#성능 최적화
27개의 글
#3728
Weight-Space Programming — 가중치 0.016%로 수학 성능 6배 개선
MIT CSAIL 연구진이 공개한 Weight-Space Programming을 정리했습니다. GPT-6 Astra로 표기된 모델이 Qwen3.5-0.8B 가중치의 0.016%만 수정해 MATH-500을 7.9%에서 48.1%로 올린 실험과 한계가 핵심입니다.
#3710
openidea, Rust로 다시 만든 IntelliJ IDE — 메모리 169MB, 준비 1.1초
l0ng-ai의 openidea가 IntelliJ IDEA를 Rust로 재구현했습니다. 공개 11일 만에 3,432스타, README 벤치마크에서 메모리 169MB 대 2,011MB, 준비 1.1초 대 13.2초를 제시한 근거와 단서를 정리했습니다.
#3681
agent-desktop v1.0.2 공개 — 접근성 트리로 데스크톱을 조작하는 에이전트 CLI 정리
Vercel Labs가 agent-desktop v1.0.2를 공개했습니다. 스크린샷 대신 접근성 트리를 JSON 스냅샷으로 읽고 ref로 실행하는 Rust CLI이며, 기본값은 headless입니다.
#3631
hunch 공개 — EmbeddingGemma2 기반 System One 판단 서버, CPU 추론
undrgrnd-labs가 EmbeddingGemma2 기반 System One 판단 서버 hunch를 공개했습니다. 느린 teacher 모델에서 배운 작은 student가 CPU에서 밀리초 단위로 답하는 구조와 성능 수치를 정리했습니다.
#3605
에이전트 스킬 130개를 동적 링커로 조립하는 방법 — html-publish 127.6KB를 11.2KB로
서소영이 2026년 10월 27일 공개한 에이전트 스킬 동적 링커 조립 방식은 127개 스킬을 132개 스킬·11개 도메인 카탈로그로 재편하고, call·include·pick 링크로 런타임에 조립합니다. html-publish는 127.6KB에서 11.2KB로 91% 줄었다고
#3601
Baidu Unlimited OCR 2: 수백 페이지 문서를 한 번에 읽는 오픈 OCR, 단계별 비용 고정
Baidu가 2026년 10월 27일 공개한 Unlimited OCR 2는 SR-SWA로 단계별 디코딩 비용을 고정해 수백 페이지 문서를 한 번에 파싱합니다. 보도 기준 점수와 아직 확인되지 않은 한계를 정리합니다.
#3529
Zagitta gpu-unlock: RTX 30 텐서코어 제한 해제, BF16 최대 80% 향상 주장
Zagitta의 gpu-unlock은 RTX 30 시리즈의 FP/BF16 텐서코어 명령어 발급 속도 제한을 푸는 오픈소스 프로젝트다. RTX 3090 Ti 벤치마크에서 BF16은 80%, TF32는 94% 올랐다고 보고됐다.
#3483
MiniMax M3.1 Flash 가중치 공개: 428B·활성 23B, 주요 칩·클라우드 지원
MiniMax가 10/23에 M3.1 Flash의 모델 가중치를 오픈소스로 공개했습니다. 총 428B·활성 23B MoE 구조이며, 첫날부터 주요 칩과 클라우드, vLLM·SGLang이 붙었습니다.
#3480
Behavioral Localization: 스킬 효과 국소화로 소프트 프롬프트를 학습한다
Behavioral Localization은 스킬의 효과가 궤적 전체가 아니라 상위 10% 위치에 집중된다는 관측에서 출발합니다. 그 위치만 골라 짧은 소프트 프롬프트를 학습시켰더니, 공유 프롬프트 성공률이 30.36%에서 36.79%로 올랐습니다.
#3478
HGM-Dual: 계보 인식 진단 가이드로 하네스 최적화를 플래닝까지 확장와 플래닝 정렬 문제
HGM-Dual은 계보 인식 context와 두 갈래 자식 생성으로 하네스 최적화를 플래닝 태스크까지 끌고 왔습니다. 최강 베이스라인 대비 케이스 정확도 최대 14.45% 상대 개선, 2배에서 4배 적은 평가 예산이 핵심 주장입니다.
#3476
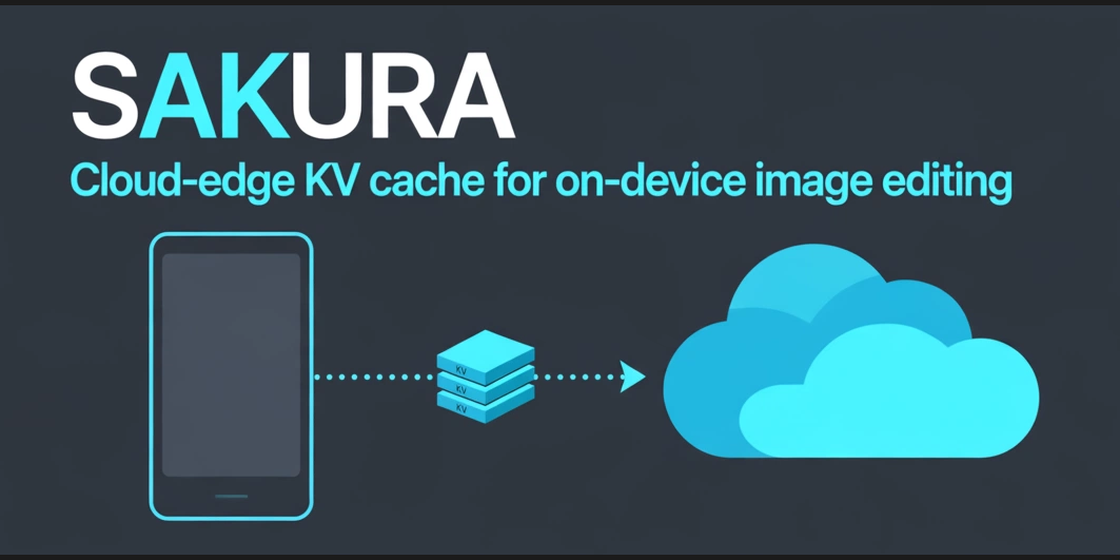
SAKURA: 대역폭 적응형 KV 캐시로 폰 온디바이스 이미지 편집 가속와 클라우드-엣지 구조
SAKURA는 대역폭 적응형 KV 캐시로 폰 온디바이스 이미지 편집의 전송 병목을 푼다. CacheGen 대비 지연 1.82배, 온디바이스 생성 대비 3.27배 감소, 캐시 저장 3.06배 축소.
#3474
additive power law: 롱컨텍스트 지속 프리트레이닝 스케일링 법칙 연구와 100개 예산 조합
Ziqing Qiao 연구진이 롱컨텍스트 지속 프리트레이닝(LCCP)의 additive power law를 제시했다. 모델 크기, 단기 프리트레이닝 토큰, LCCP 토큰 세 요소로 긴 문맥 성능을 예측한다.
#3470
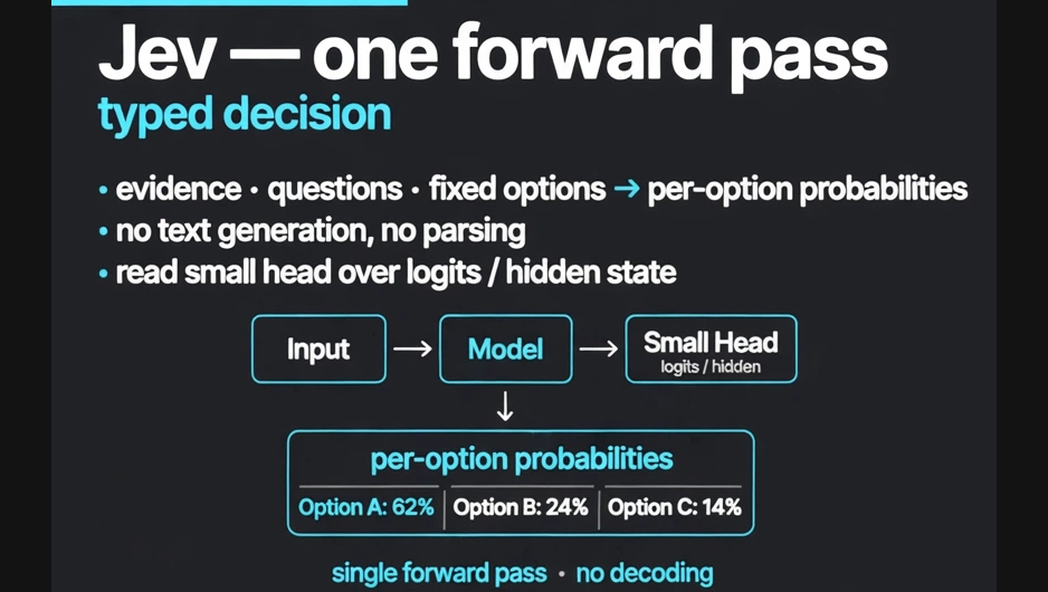
Jev 오픈 LoRA 재현: 한 번의 forward pass로 답을 읽는 결정 모델와 LoRA 헤드 읽기
Jev를 오픈으로 재현한 논문. 한 번의 forward pass로 증거·질문·고정 옵션을 옵션별 확률로 매핑한다. 1,000세션을 1개 GPU로 약 3분에, 약 $0.06에 판정한다.
#3449
MicroPerf-Bench: 마이크로서비스 성능 최적화로 코딩 에이전트 실력 재기와 42% 회복 한계
MicroPerf-Bench는 마이크로서비스 시스템의 종단간 성능 최적화로 코딩 에이전트를 재는 벤치마크다. 1,755회 실행에서 최고 구성도 주입된 성능 저하의 42.0%만 회복했다.
#3448
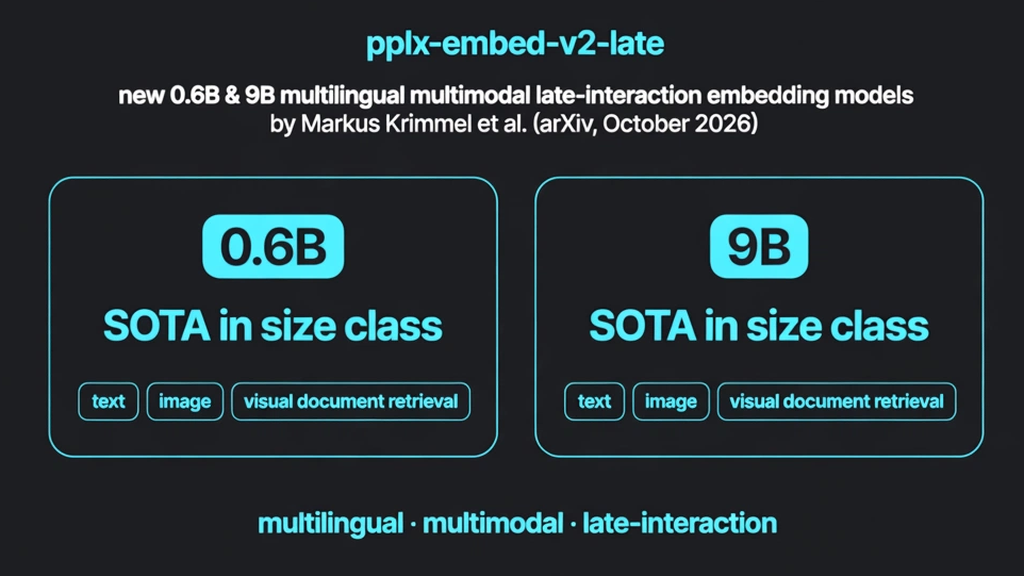
pplx-embed-v2-late: 0.6B·9B 다국어 멀티모달 late-interaction 임베딩
pplx-embed-v2-late는 0.6B와 9B의 다국어·멀티모달 late-interaction 임베딩 모델 쌍이다. 각 size class에서 text·image·visual document retrieval 벤치마크 전반에 걸쳐 SOTA이며, 0.6B는 자신보다 몇 배 큰
#3446
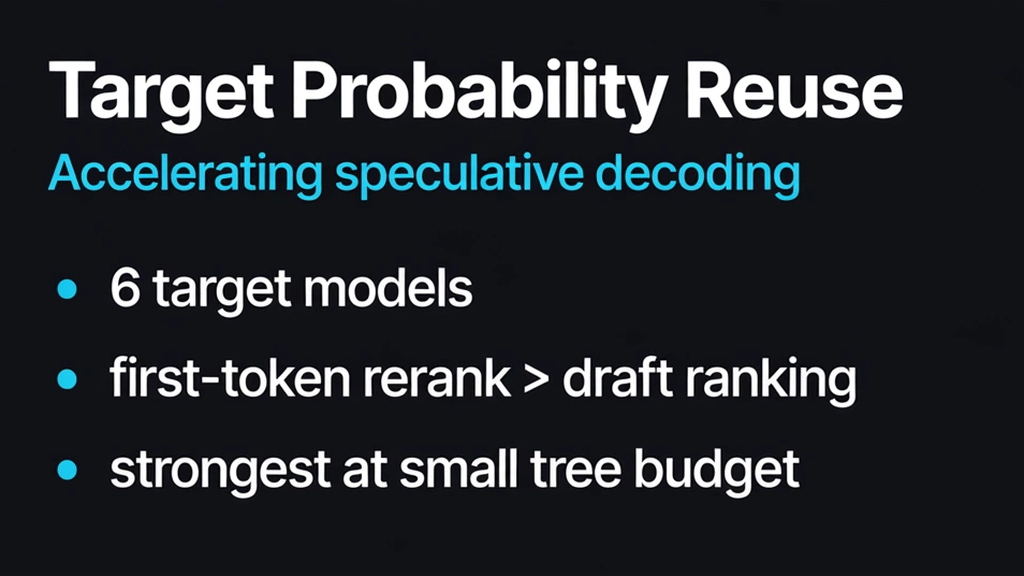
target probability reuse: 타깃 확률 재사용으로 추측 디코딩을 가속한다
추측 디코딩 검증 과정에서 이미 계산된 next-token 분포를 다음 트리 선택에 재사용한다. 여섯 개 target에서 first-token branch 리랭크가 draft ranking보다 expected acceptance를 높였다. 작은 tree budget에서 효과 두드러.
#3428
CATS: 에이전트별 기여도 계산으로 멀티에이전트 토폴로지를 탐색하는 연구와 슈퍼그래프 팀 탐색
CATS는 에이전트별 기여도로 멀티에이전트 토폴로지를 탐색한다. BigCodeBench 정확도 +5.3pp, 배포 토큰 54% 절감, HotpotQA 프롬프트 포이즈닝 스트레스 테스트 3회 모두 악성 에이전트 제거.
#3381
크래프톤 라온-1 미니: 30B급 독자 개발 LLM 프리뷰 Apache 2.0 공개와 독자 개발 방식
크래프톤이 10/21 자체 개발 30B급 LLM '라온-1 미니' 프리뷰를 Apache 2.0으로 공개했다. 전체 300억 매개변수 중 추론 시 40억만 활성화하는 MoE+선형 어텐션 구조라 단일 GPU 서버에서도 돌리기 현실적인 규모.
#3379
ElevenLabs Eleven Realtime: 말로 듣고 바로 답하는 음성 에이전트 모델
ElevenLabs가 실시간 음성 에이전트용 speech-to-speech 모델 'Eleven Realtime v1'(Mini/Max)을 공개했다. v1 Max는 Big Bench Audio 98.8%, 첫 오디오 응답 0.57초. OpenAI Realtime API 호환이라
#3377
TorchTPU: 구글·메타 공동 TPU 네이티브 PyTorch 백엔드 오픈소스 공개와 52% MFU 기록
Google이 PyTorch Conference 2026에서 TorchTPU를 오픈소스로 공개했다. TPU용 네이티브 PyTorch 백엔드로, Google·Meta PyTorch 팀이 공동 개발. eager 실행 우선, .to("cuda") → .to("tpu") 수준의 최소 변경으로
#3375
카카오 Kanana-2-vision-encoder 2종 공개: 지연 60% 감소한 비전 인코더
카카오가 AI 비전 인코더 Kanana-2-vision-encoder 2종을 오픈소스로 공개했다. medium 4.26억·tiny 9,800만 파라미터, 지연 60% 감소 주장. 온디바이스 멀티모달 파이프라인에 쓸 만한 경량 옵션이 하나 늘었다.
#3349
Exa 3.0: AI 에이전트용 검색 API 역대 최대 품질 개선·저가 티어 출시, 저가 티어 출시
Exa가 2026-10-19 AI 에이전트용 검색 API Exa 3.0을 출시했다. 회사는 '우리가 내놓은 역대 최대 검색 품질 개선'이라고 표현한다. 신규 저가 티어 Exa Lite(1,000요청당 $4), Dynamic Highlights GA(토큰 95%↓), 인덱스 대확장이
#3340
Obsidian Pele: Mermaid 렌더러 번들 1/6, 최대 500배 빠른 렌더 주장
Obsidian이 노트 앱용으로 직접 만든 오픈소스 Mermaid 렌더러 Pele가 공개됐다. Mermaid.js 대비 gzip 번들 1/6(230 kB), 렌더 최대 500배(0.05–0.3 ms), 의존성 0개, CSS 변수 테마 전환. 10/17 HN 프론트페이지(561포인트)
#3338
leanrea 8KB 스킬: REA 대체, MCP 없이 38% 빠르고 35% 저렴한 구조와 설치물 하나
리버스엔지니어링 에이전트 스킬 REA(25MB 패키지+MCP 서버+207개 도구)를 SKILL.md 단일 파일(8KB)로 대체한 leanrea. 컨텍스트 오버헤드는 400.7k→34.5k 토큰, 벤치마크는 38% 빠름·35% 저렴·60% 토큰 절감, 점수는 74/75로 REA와
#3332
텐센트 Hy Memory 2.0: 에이전트 기억을 3B 특화 모델에 맡기는 구조와 55.49 하네스 점수
텐센트 Hunyuan이 에이전트 메모리 프레임워크 Hy Memory 2.0을 공개했다. 메모리 쓰기 경로를 전담하는 Hy-Memory-30B-A3B(활성 파라미터 3B)가 4개 하네스 평균 55.49로 Claude Opus 5(54.62)를 앞섰다는 주장. 쓰기 경로 오프로드
#3329
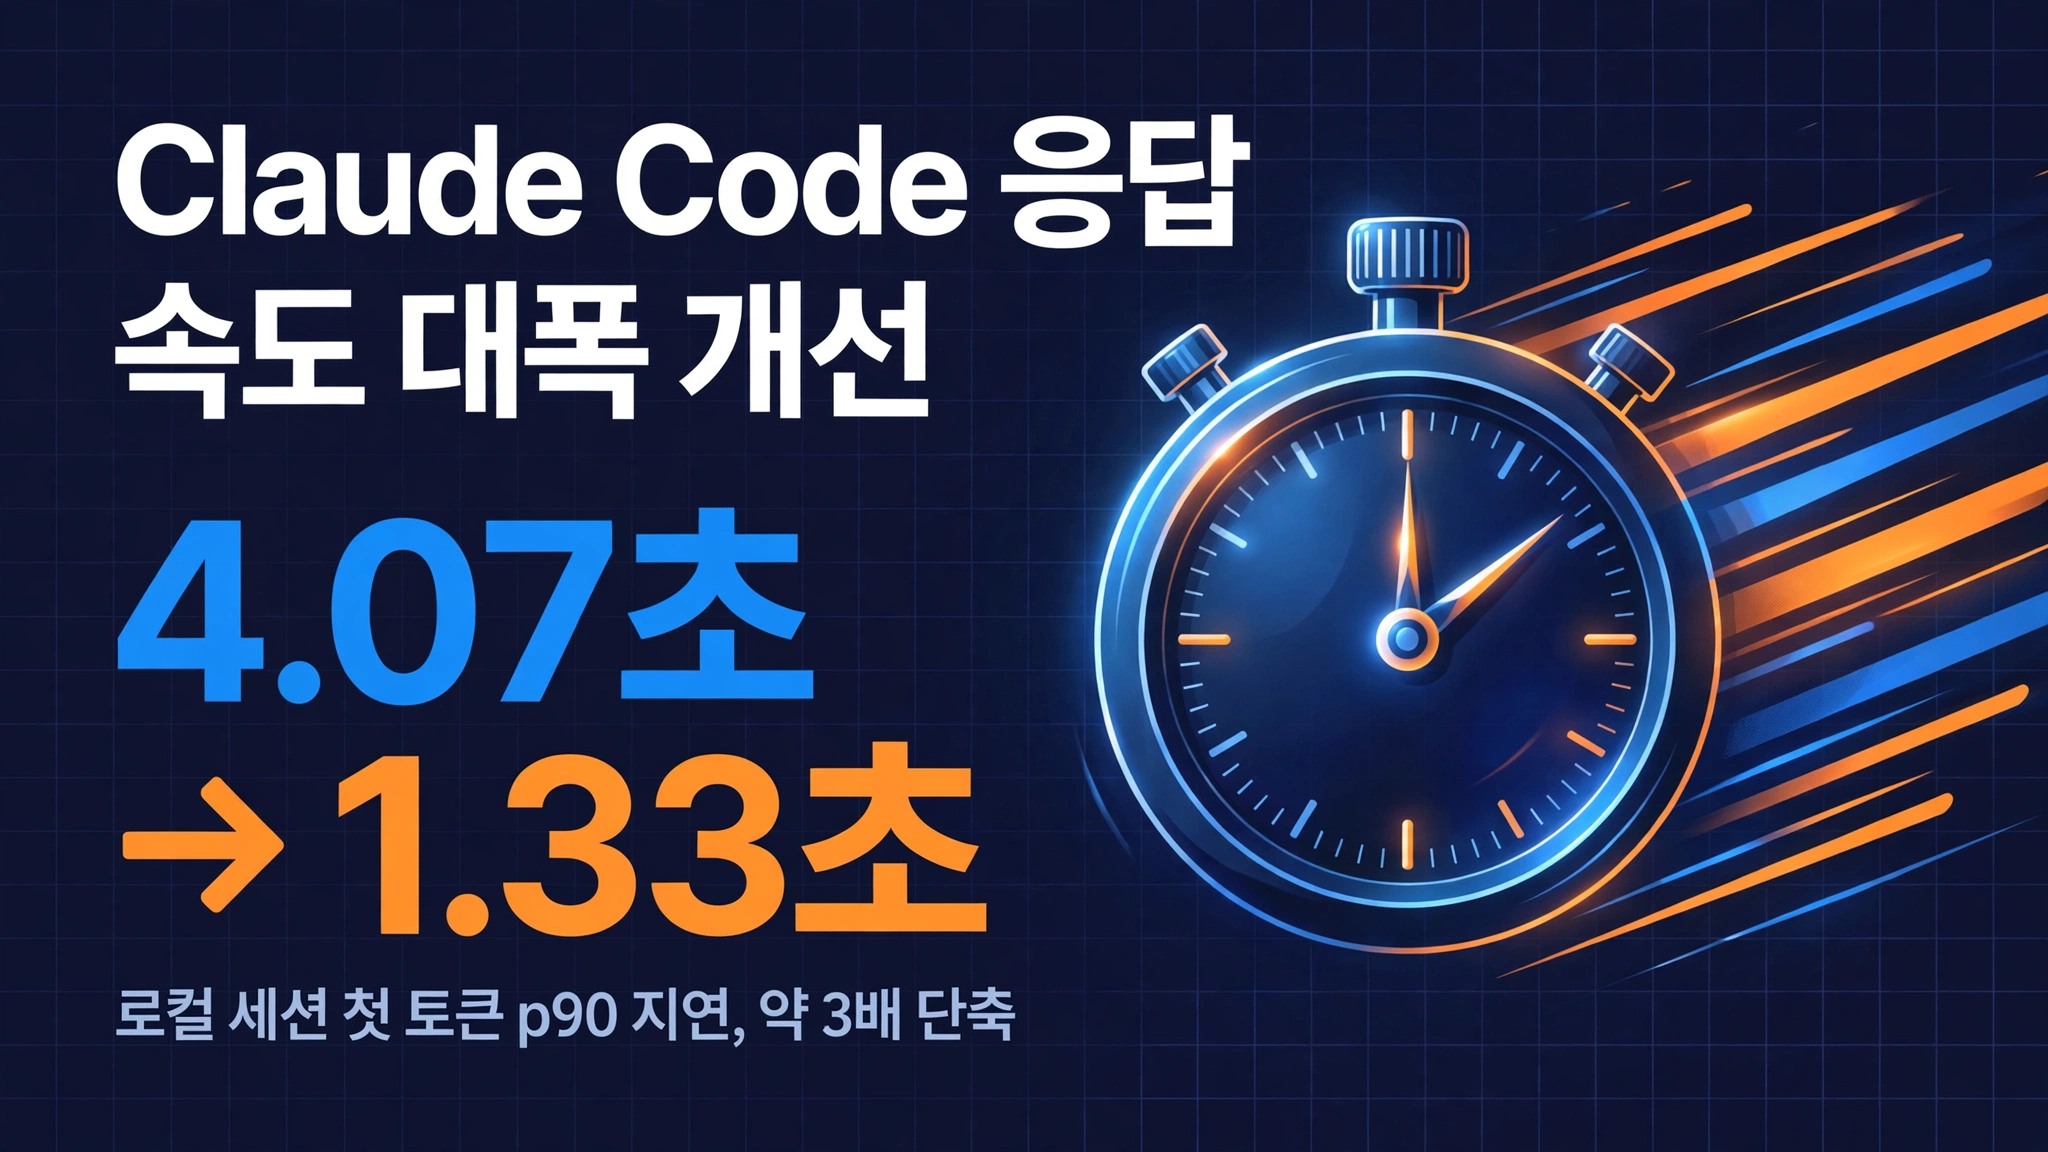
Claude Code 속도 개선: 첫 토큰 지연 4.07초에서 1.33초로 단축한 방법과 전송 최적화
Anthropic이 10월 17일 @ClaudeDevs를 통해 Claude Code의 첫 토큰 지연 개선을 발표했다. 로컬 세션 p90 4.07초→1.33초, 클라우드 세션 16.99초→6초, 웹/Cowork 3.36초→2.17초, API 1.53초→1.01초. 핵심 수단은 턴당 대화
#3194
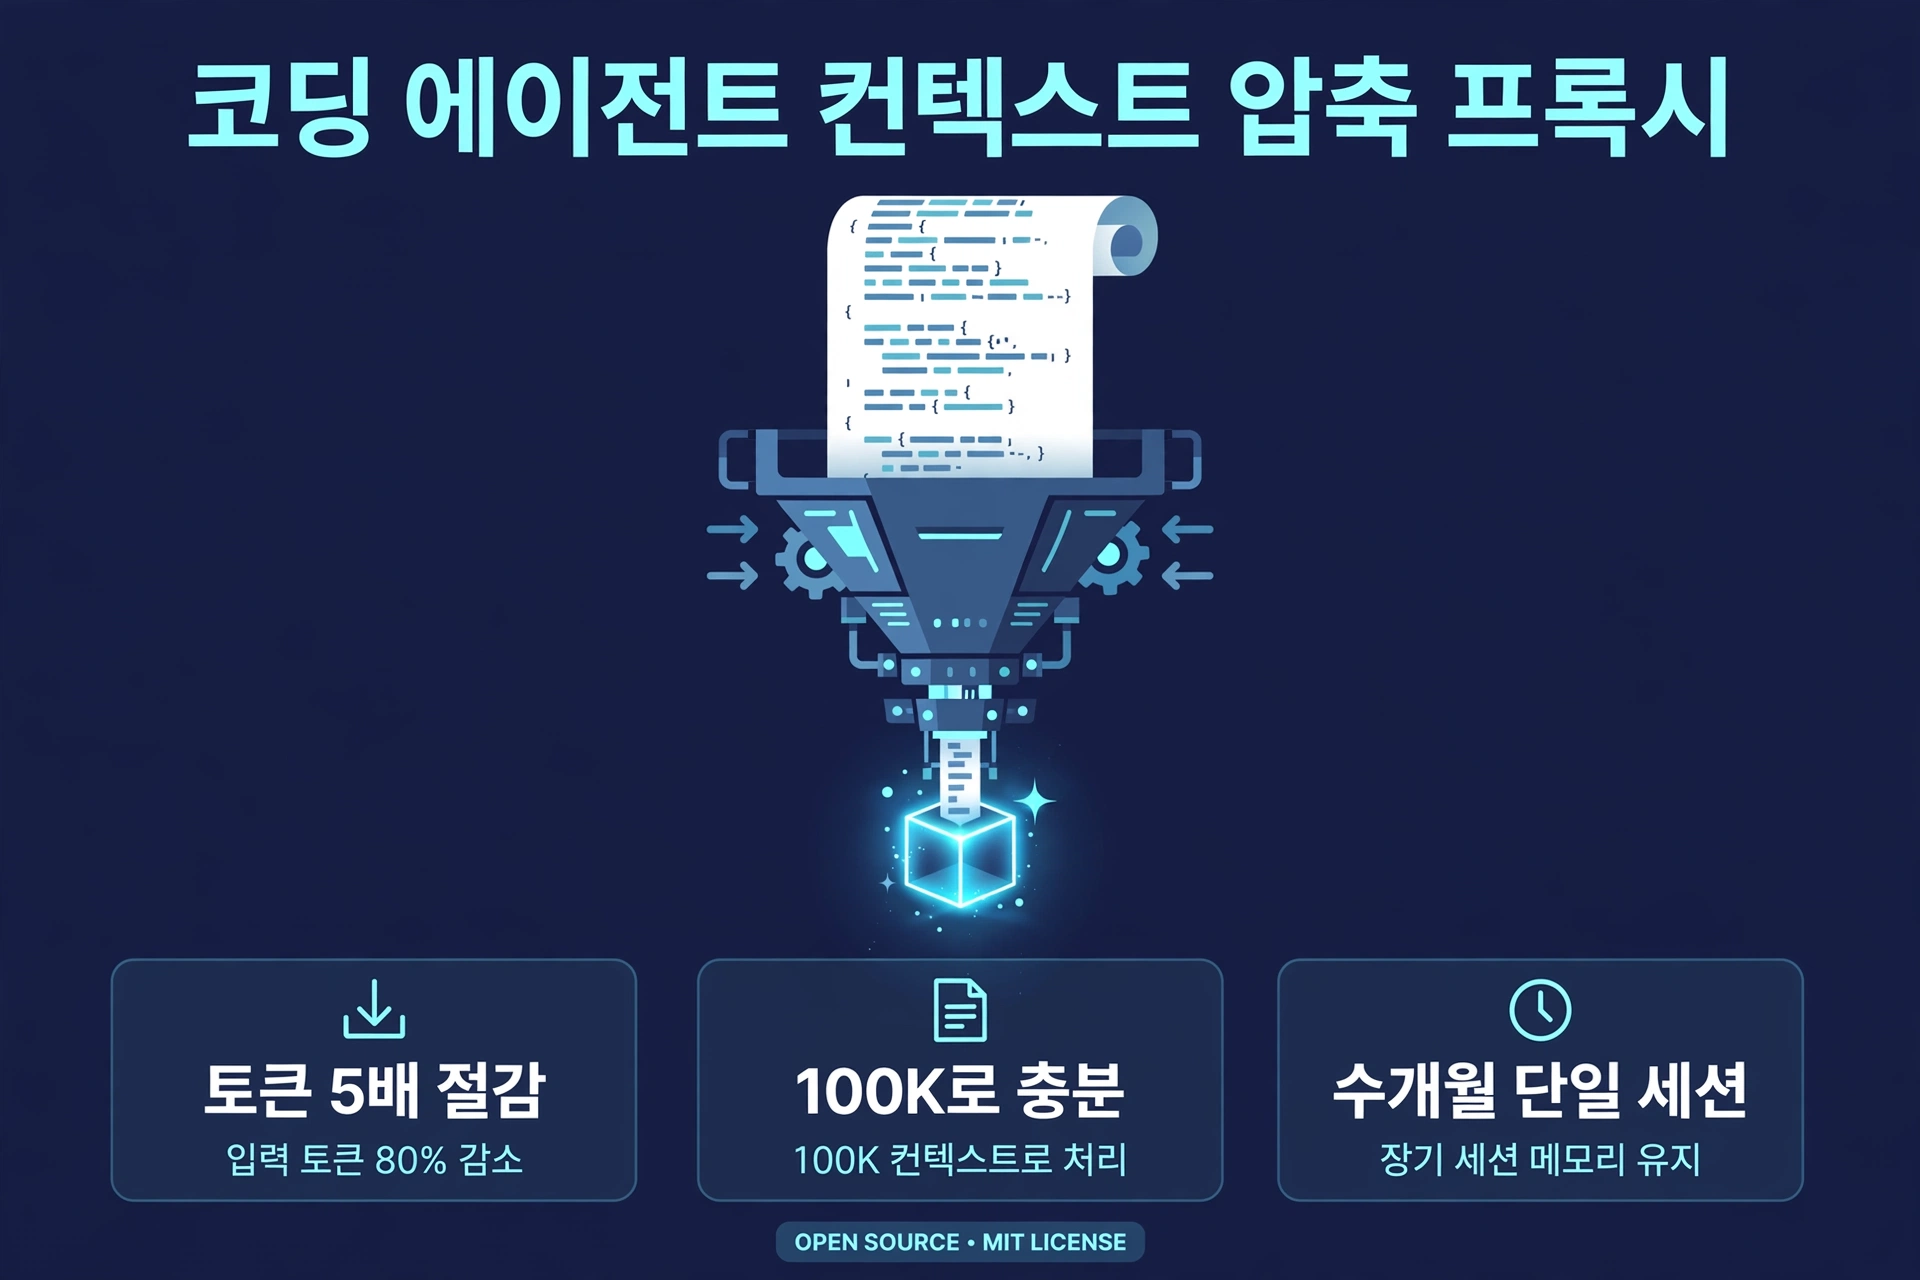
billion-context: 코딩 에이전트 컨텍스트 5배 절감하는 압축 프록시 구조와 동작 원리
에이전트와 모델 API 사이에 끼는 컨텍스트 압축 프록시 billion-context. 모델이 직접 압축 타이밍을 정하는 구조, 4개의 컨텍스트 관리 도구, 그리고 주장 뒤의 미확인 수치를 개발자 관점에서 정리한다.