SAKURA: 대역폭 적응형 KV 캐시로 폰 온디바이스 이미지 편집 가속와 클라우드-엣지 구조
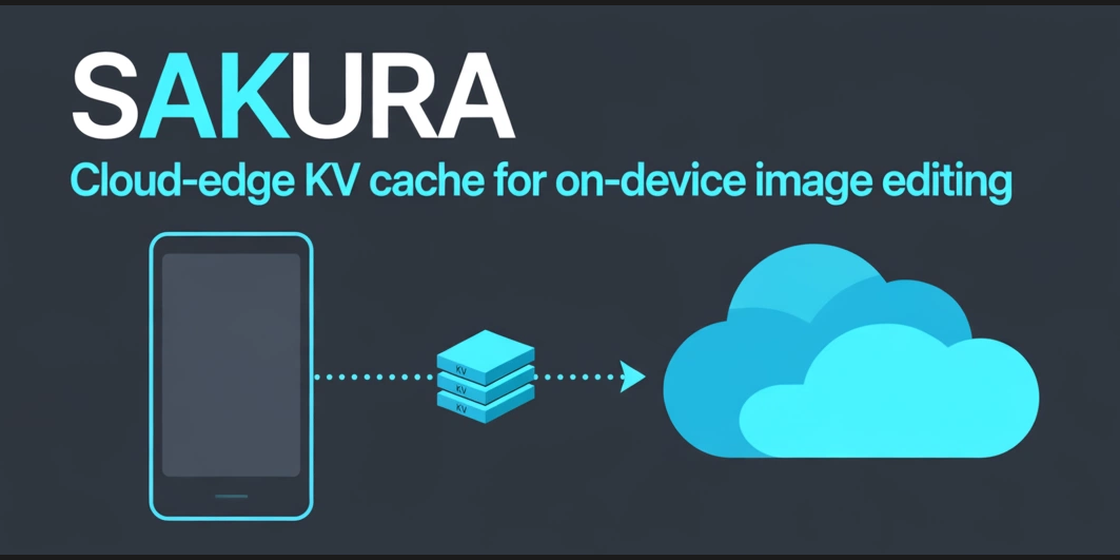
핵심 — 캐시 전송이 추론 경로의 병목이다
- SAKURA는 reusable attention state를 bandwidth budget 하에 모바일로 전달하는 cloud-edge 아키텍처다.
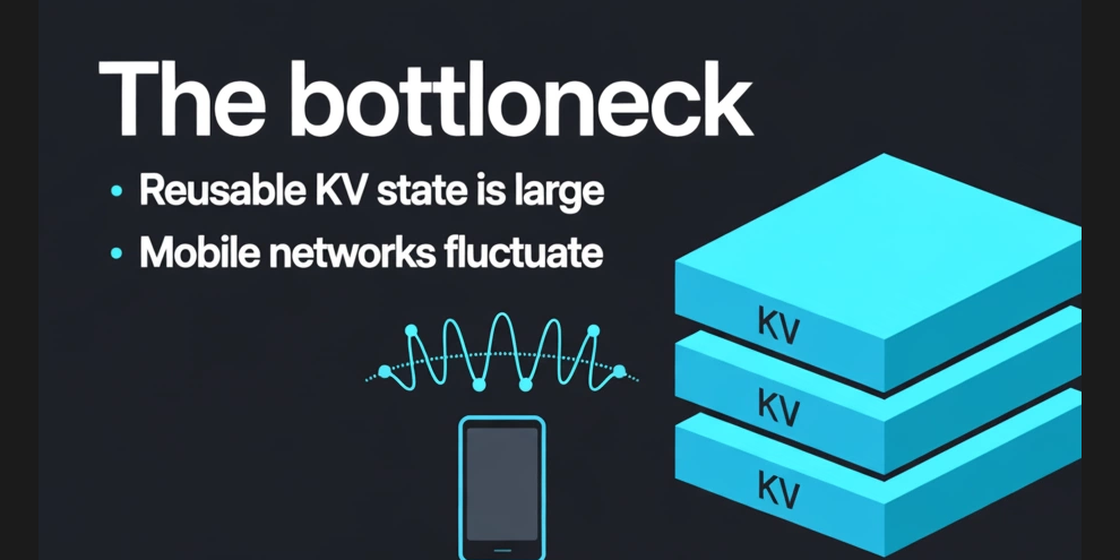
- face swapping, virtual try-on 같은 template 기반 작업에서는 KV state를 미리 계산해 재사용할 수 있다. 하지만 이 state는 크고, template 수에 비례해 커진다. 모바일에 다 저장하기 어렵다.
- 캐시를 클라우드에 두면 전송이 추론 경로에 끼어든다. 전송이 on-device 연산보다 느려질 수 있다. fluctuating mobile networks, 즉 불안정한 모바일 네트워크가 전제 조건이다.
- SAKURA는 이 병목을 대역폭 적응(rate adaptation)으로 푼다.
동작 — 토큰 중요도 압축과 파이프라인 실행
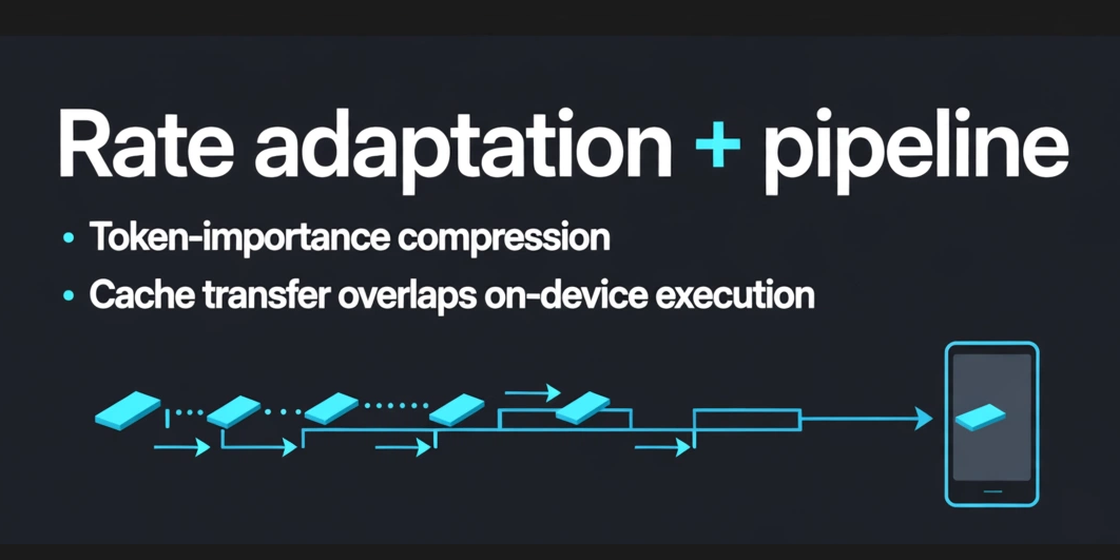
- fine-grained token-importance-aware compression 기법으로 제한된 전송 budget에서 image quality를 유지한다. 토큰마다 중요도를 따져서 압축한다.
- runtime은 network bandwidth를 보고 upcoming shard마다 cache representation을 적응적으로 고른다. 대역폭이 바뀌면 다음 샤드의 캐시 표현도 바뀐다.
- pipelined runtime이 cache transfer·reconstruction과 on-device execution을 겹쳐서 실행한다. 전송·복원과 기기 내 실행을 동시에 돌린다.
수치 — 지연과 캐시 저장 모두 줄었다
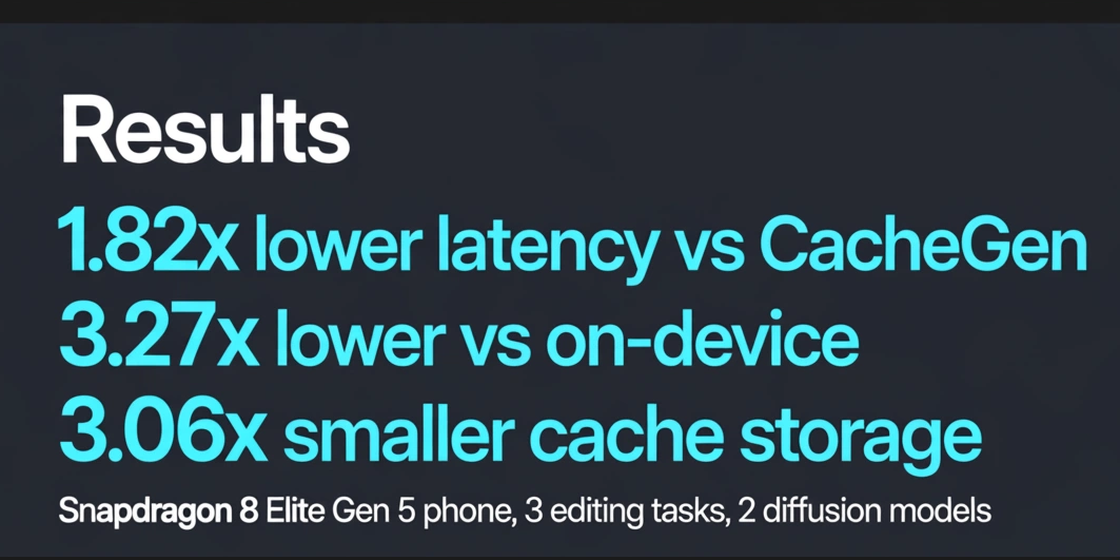
- 평가는 3개 editing tasks와 2개 diffusion models로 했다. 기기는 Snapdragon 8 Elite Gen 5 폰이다.
- latency는 CacheGen(DiT 적응) 대비 1.82배 줄었고, on-device generation 대비 3.27배 줄었다.
- cache storage는 uncompressed cache 대비 3.06배 줄었고, image quality는 유지됐다.
세 수치의 비교 기준이 다르다는 점에 주의한다. 1.82배는 CacheGen과의 비교, 3.27배는 온디바이스 생성과의 비교, 3.06배는 압축하지 않은 캐시와의 비교다.
왜 중요한지 — 온디바이스 생성형 AI의 실용화 조건
폰 이미지 편집은 프라이버시 때문에 온디바이스 추론이 유리하다. 요청별 추론을 디바이스에 두면 개인 이미지와 프롬프트를 클라우드에 보내지 않아도 된다. 기존의 cloud-device collaboration은 효율과 프라이버시를 함께 잡지만, 핵심 병목은 재사용 KV 캐시의 크기와 전송이다. Android 개발자 관점에서 온디바이스 생성형 AI의 실용화는 메모리와 대역폭 최적화에 달려 있다. diffusion transformer 기반 편집 서비스가 대표적 예다. Snapdragon 8 Elite Gen 5라는 최신 플래그십 모바일 칩에서의 실측 수치는 디바이스 타깃 선정의 근거가 된다. 개인 이미지와 프롬프트를 클라우드에 안 보낸다는 점은 사용자 신뢰와 규제 대응에도 중요하다.
아직 안 밝혀진 것 / 쟁점
- 평가에 쓴 3개 editing task의 명칭은 미확인이다.
- 평가에 쓴 2개 diffusion model의 명칭은 미확인이다.
- image quality가 유지됐다는 주장의 측정 지표는 미확인이다.
- Snapdragon 8 Elite Gen 5 외 디바이스에서의 결과는 미확인이다.