Zagitta gpu-unlock: RTX 30 텐서코어 제한 해제, BF16 최대 80% 향상 주장
Zagitta가 공개한 gpu-unlock은 NVIDIA RTX 30 시리즈(Ampere)의 FP/BF16 텐서코어 명령어 발급 속도 제한을 푸는 오픈소스 프로젝트입니다. 레포는 2026-10-18에 생성됐고, 확인 시점 스타 수는 3,639개였습니다. 소비자용 Ampere 카드가 전문가용 카드보다 FP16/BF16 명령어 발급 속도를 낮게 제한받는다는 전제에서 출발합니다. 이 프로젝트는 CMP 암호화폐 채굴 GPU의 펌웨어 해제 연구를 결합한 것으로, 이미 갖고 있는 카드의 연산 여유를 끌어내는 방향입니다.
로컬 추론이나 이미지 생성을 돌리는 개발자에게는 새 카드 없이 성능을 올릴 수 있는 선택지가 될 수 있습니다. 다만 이 글의 모든 향상 수치는 레포 벤치마크와 커뮤니티 보고에 근거한 주장이고, 독립 기관의 재현 수치는 확인되지 않았다는 점을 먼저 밝혀둡니다.
드라이버를 패치하지 않고, VBIOS도 건드리지 않는다
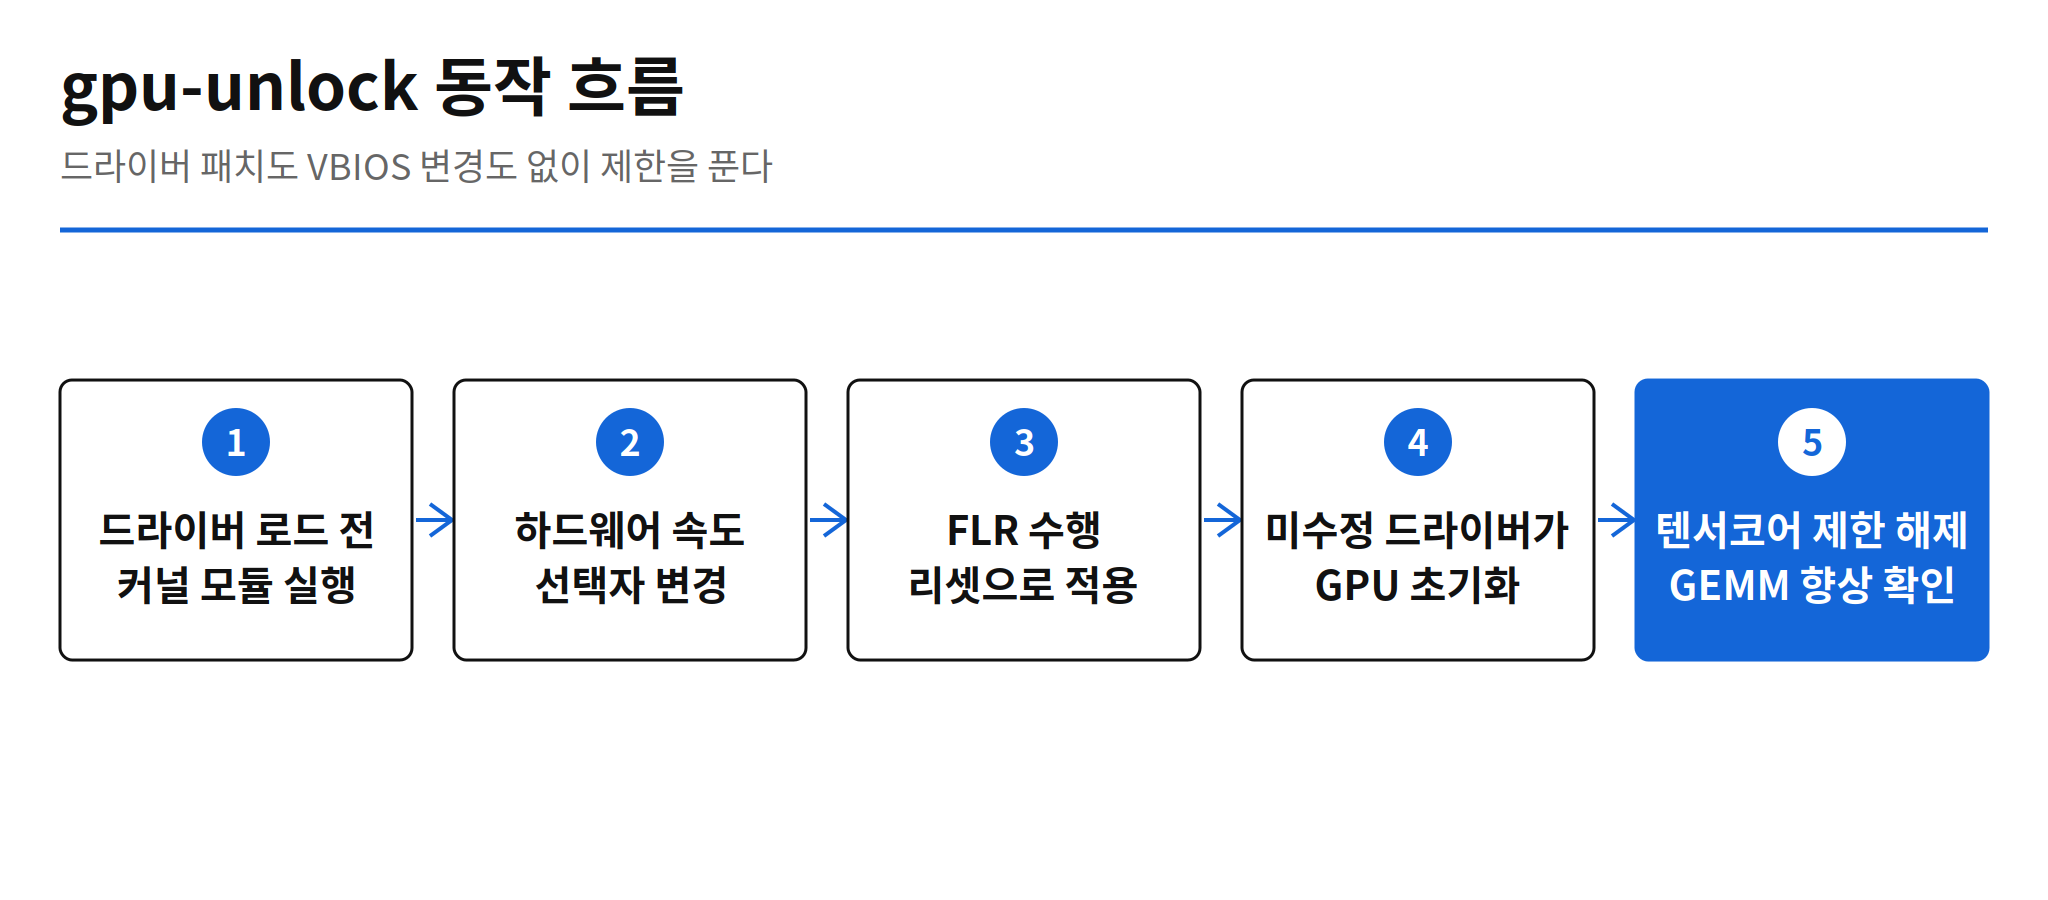
동작 방식은 단순한 순서 바꾸기에 가깝습니다. Linux 커널 모듈이 NVIDIA 드라이버가 로드되기 전에 실행되고, 하드웨어 속도 선택자를 바꾼 뒤 Function Level Reset(FLR)을 수행합니다. 그 다음 수정하지 않은 드라이버가 GPU를 초기화합니다. 그래서 드라이버를 새로 패치할 필요가 없고, VBIOS를 영구적으로 바꾸지도 않습니다.
지원 대상은 GA102, GA103, GA104, GA106 GPU로 안내됐습니다. Windows용 실험 구현도 있는데, UEFI 방식이며 RTX 3090에서 BF16 연산량이 약 82.5% 올랐다고 문서화됐습니다. 다만 하드웨어 전용 실험 단계로 안내된 만큼, Linux 경로와 같은 무게로 보기는 어렵습니다.
숫자로 보면: 3090 Ti에서 BF16 80%, TF32 94%
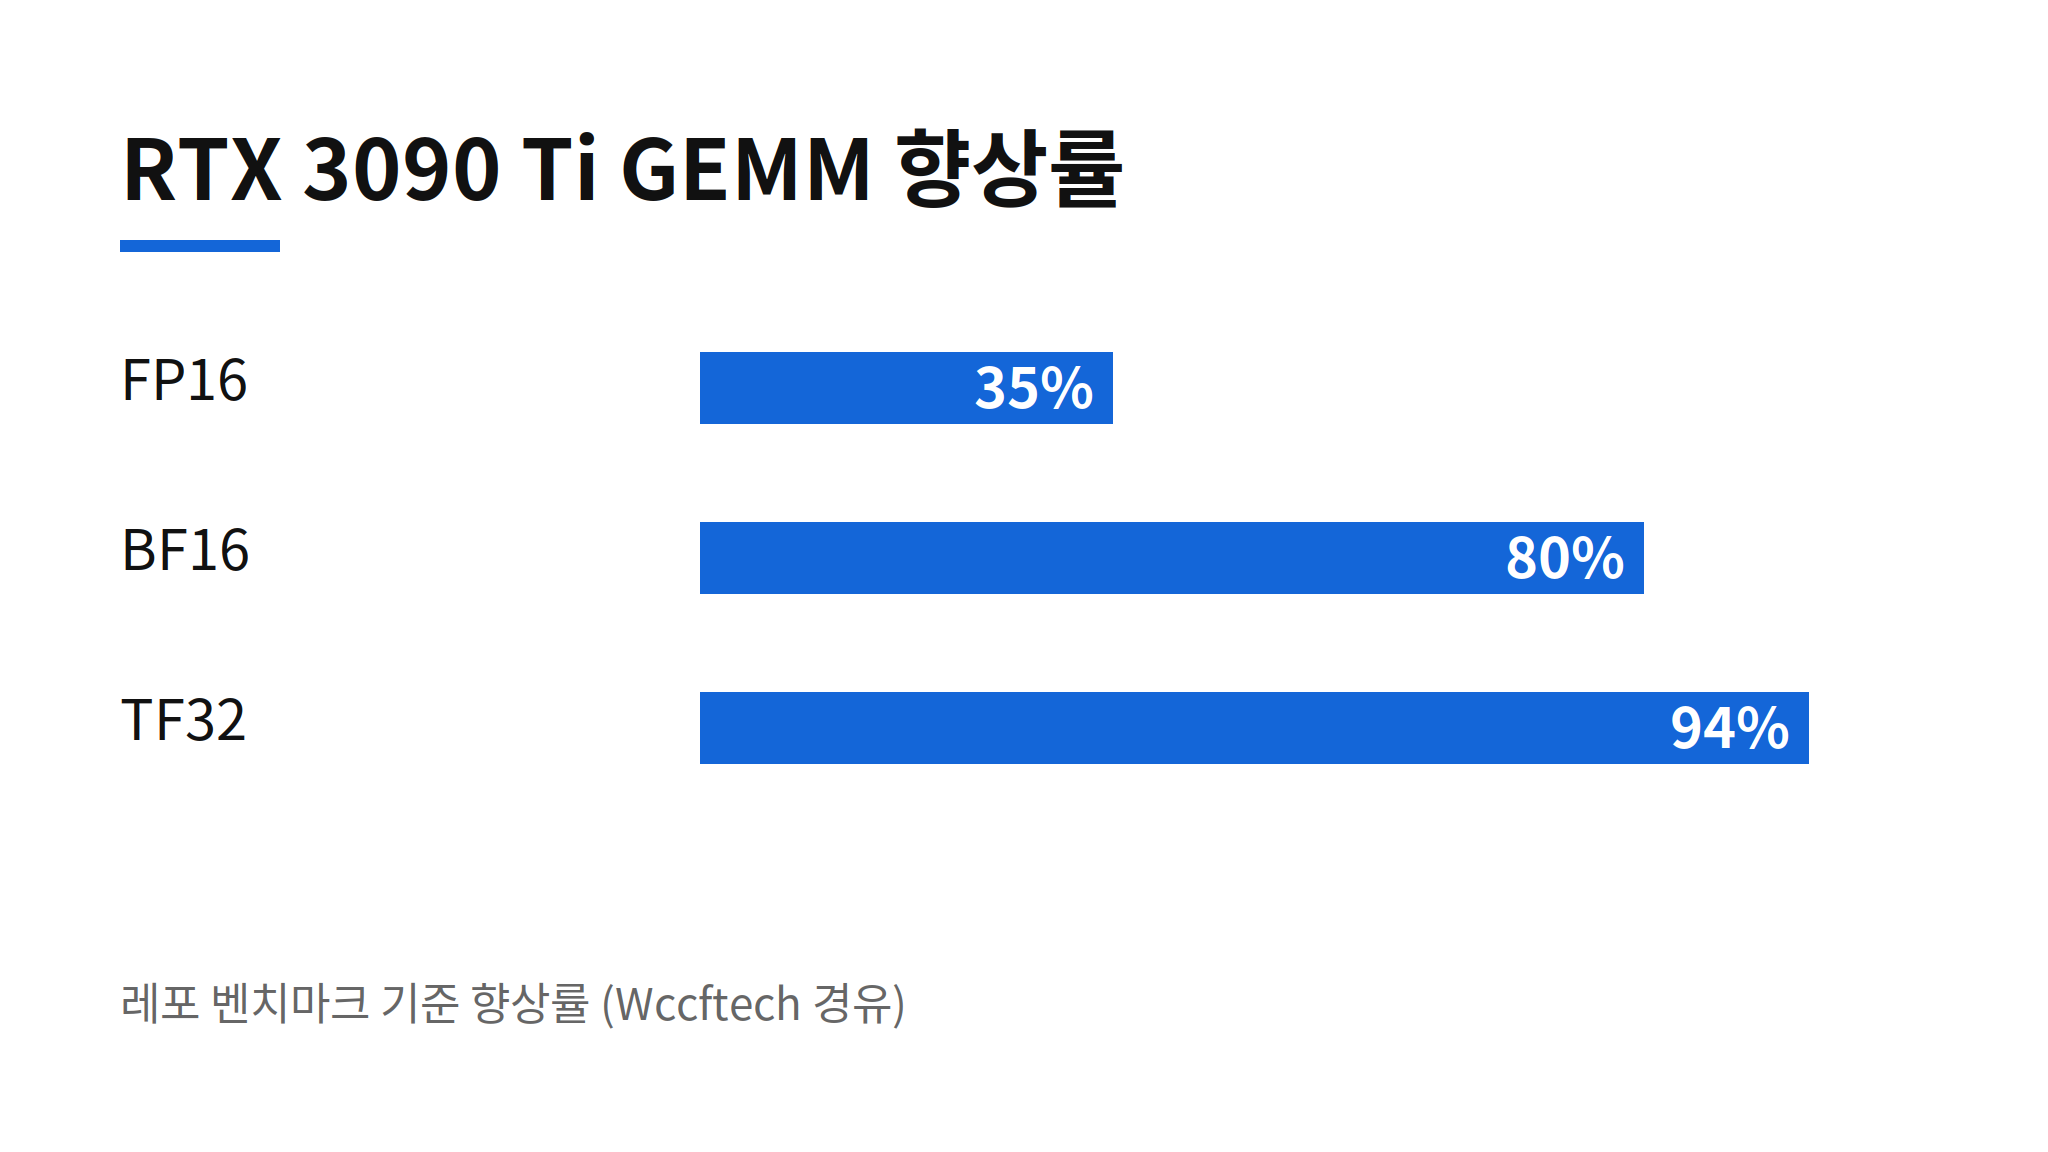
레포 벤치마크에서 RTX 3090 Ti(450W 제한)는 고밀도 행렬 곱(GEMM) 테스트를 돌렸습니다. FP16은 87.46 TFLOPS에서 118.39 TFLOPS로 35% 올랐고, BF16은 87.50 TFLOPS에서 157.41 TFLOPS로 80% 올랐습니다. TF32는 42.58 TFLOPS에서 82.61 TFLOPS로 94% 올랐습니다.
| 카드 | 항목 | 변경 전 | 변경 후 |
|---|---|---|---|
| RTX 3090 Ti (450W) | FP16 | 87.46 TFLOPS | 118.39 TFLOPS (+35%) |
| RTX 3090 Ti (450W) | BF16 | 87.50 TFLOPS | 157.41 TFLOPS (+80%) |
| RTX 3090 Ti (450W) | TF32 | 42.58 TFLOPS | 82.61 TFLOPS (+94%) |
| RTX 3080 Ti (315W) | BF16 | 71.59 TFLOPS | 113.98 TFLOPS |
| RTX 3080 Ti (315W) | TF32 | 35.65 TFLOPS | 65.28 TFLOPS |
| RTX 3080 10GB (320W 유지) | FP16/BF16 | 약 65 TFLOPS | 110~113 TFLOPS |
다른 카드 보고도 같은 방향입니다. RTX 3080 Ti 보고는 BF16 71.59 TFLOPS에서 113.98 TFLOPS로, TF32 35.65 TFLOPS에서 65.28 TFLOPS로 올랐고, 전력 제한은 315W였습니다. RTX 3080 10GB 보고는 FP16/BF16이 약 65 TFLOPS에서 110~113 TFLOPS로 올랐고, 원래 전력 제한 320W를 유지했습니다.
실제 AI 작업에서는 갈린다
GEMM 수치가 실제 작업 속도로 그대로 이어지지는 않습니다. RTX 3090 Ti의 ComfyUI 테스트에서 MOSS-Image SFT BF16은 58.6% 빨라졌고, Qwen-Image 2.1 Turbo BF16은 57.2%, Z-Image Turbo BF16은 56.1% 빨라졌습니다. 반면 INT8 설정은 0.3%만 올랐습니다. RTX 3090의 vLLM 보고는 프롬프트 처리량이 33% 올랐지만, 토큰 생성 속도는 사실상 그대로였습니다.
이 갈림이 이 프로젝트를 이해하는 열쇠입니다. 텐서코어 연산이 병목인 구간에서는 효과가 크고, 그렇지 않은 구간에서는 거의 없습니다. 메모리 대역폭이 늘어나거나 CUDA 코어가 추가되는 것도 아닙니다. 게임 성능이나 DLSS 실행 시간 개선을 뒷받침하는 설득력 있는 증거도 아직 없습니다.
아직 확인되지 않은 것들
- 결과가 보편적이지 않습니다. RTX 3080 Ti 20GB 보고 중에는 해제 절차는 성공했지만 기대한 BF16 향상이 나오지 않은 사례가 있습니다. 변동 요인은 미확인입니다.
- 벤치마크의 출처가 제한적입니다. 레포와 커뮤니티 보고에 근거하고, 독립 기관의 재현 수치는 확인되지 않았습니다. 레포의 라이선스 표기도 GitHub API에서 확인되지 않았습니다.
- 모든 작업이 빨라지는 것은 아닙니다. 위에서 본 것처럼 INT8이나 토큰 생성처럼 병목이 다른 구간은 효과가 갈립니다.
핵심은 '모든 작업이 빨라진다'가 아니라, 텐서코어 연산이 병목인 구간에서만 효과가 난다는 점입니다.
실무 판단은 이렇게 정리됩니다. 구형 GPU로 로컬 AI를 돌리는 팀이라면 하드웨어 교체 전에 이 선택지를 검토해볼 만합니다. 다만 실험 단계라는 점을 감안해, 본인 카드와 본인 작업으로 직접 재는 편이 안전합니다. GEMM 수치만 보고 도입을 결정하지 말고, 자기 워크로드의 병목이 텐서코어 구간인지부터 확인하는 것이 순서입니다.