Jev 오픈 LoRA 재현: 한 번의 forward pass로 답을 읽는 결정 모델와 LoRA 헤드 읽기
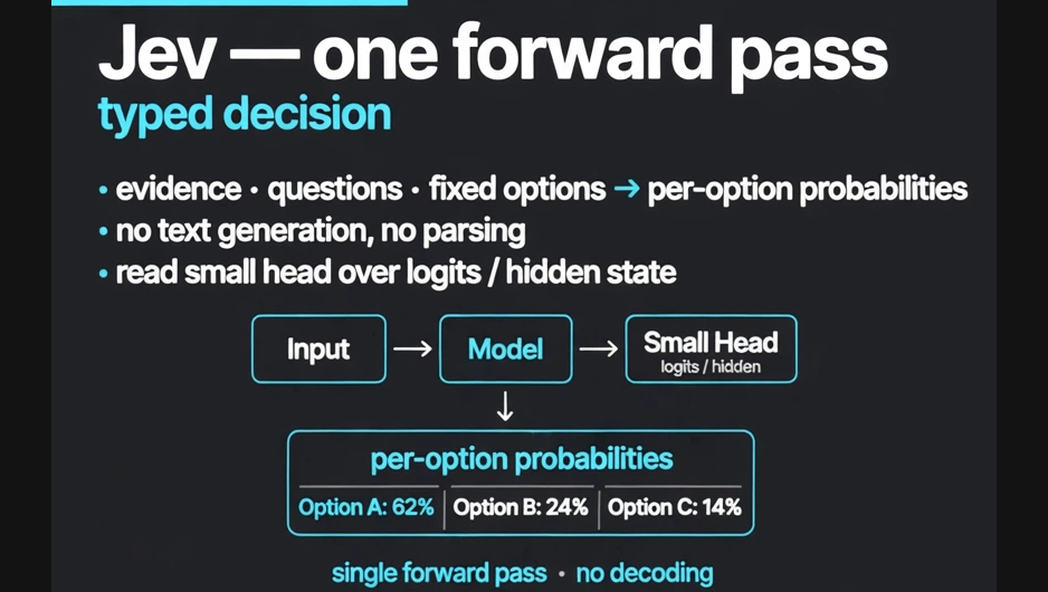
핵심 — 답을 생성하지 않고 읽는다
- typed decision은 증거·질문·고정 옵션을 옵션별 확률로 매핑한다. 한 forward pass로 계산한다 (arXiv).
- 텍스트 생성과 파싱을 거치지 않는다. 언어 모델의 logit이나 hidden state 위의 작은 헤드를 읽는다. 생성이 아니라 읽기다 (arXiv).
// 개념도: 생성 파서 대신 헤드를 한 번 읽는다
evidence, question, options  →  backbone (frozen) + rank-16 LoRA
logits / hidden state        →  pointer head
output: per-option probabilities (one forward pass)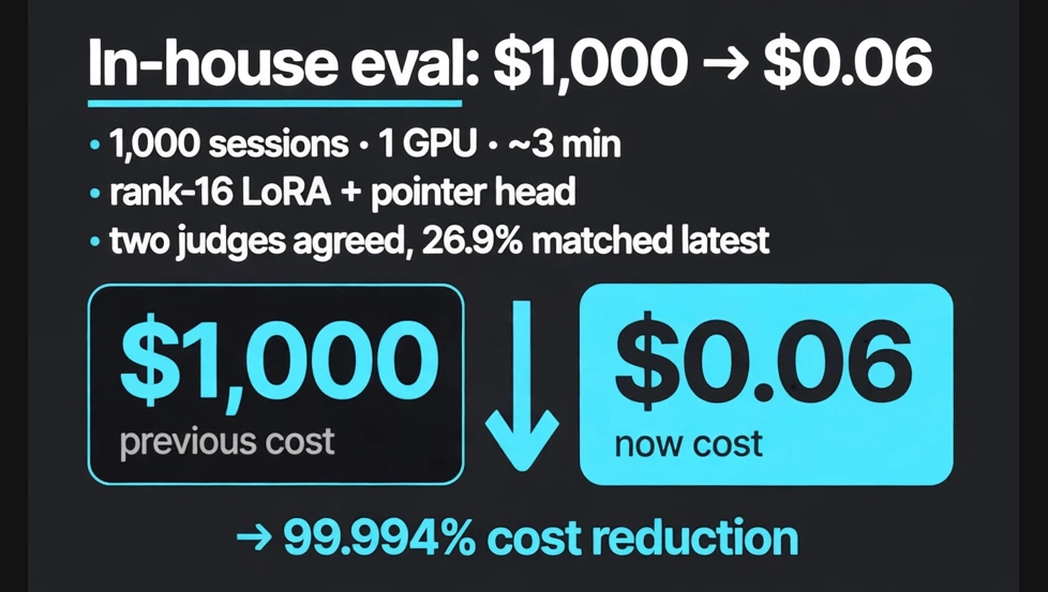
Part I — 사내 평가기를 $0.06짜리로
- 사내 System~1 judge가 약 148K 에이전트 코딩 세션 기록을 학습 코퍼스용으로 트리아지했다 (arXiv).
- frontier LLM judge는 패스당 약 $1,000이 들었다. 저장된 라벨 중 최신 합의와 일치한 것은 두 judge가 합의한 세션의 26.9%뿐이었다 (arXiv).
- self-hosted frozen backbone + rank-16 LoRA + pointer head로 3개 typed 질문을 한 forward pass로 답했다 (arXiv).
- 1,000세션을 1개 GPU로 약 3분에 판정했다. 약 $0.06 — frontier judge 비용의 약 1%다. 세션은 조직 안에 머문다 (arXiv).
개념 흐름은 이렇게 읽힌다: judge 호출을 LLM API가 아니라 사내 GPU의 forward pass 한 번으로 바꾼다. 비용 구조가 바뀌면 평가를 매일 돌릴 수 있다.
Part II — 오픈 재현이 상용 참조와 유의차 없음
- Eikos 공개 레시피와 약 25K 결정 코퍼스를 3개 백본(1B·2B·35B)에 적용했다 (arXiv).
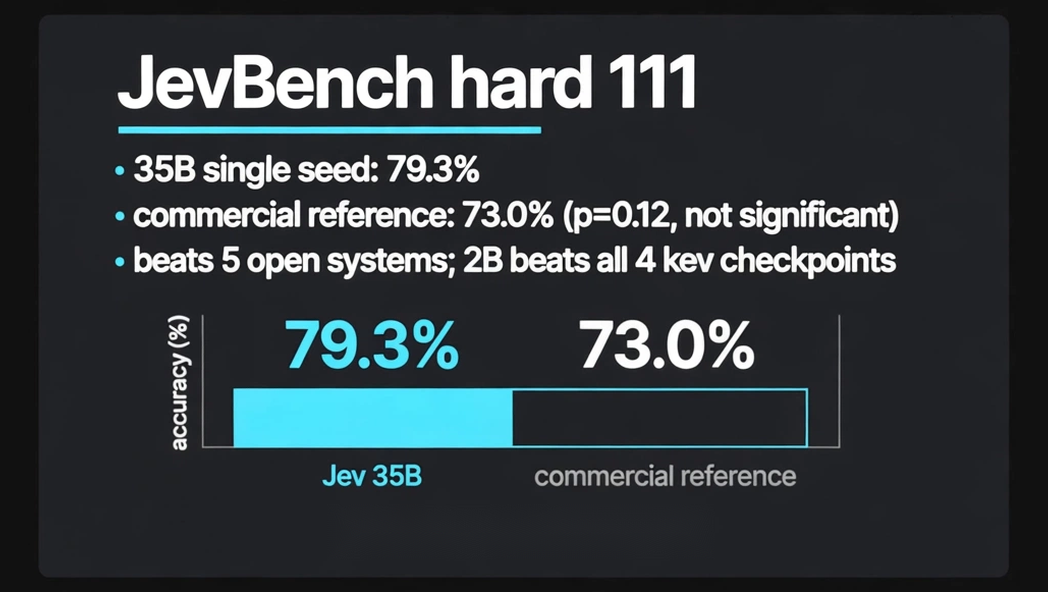
- JevBench 공개 hard 111문항에서 35B 단일 시드가 79.3%를 기록했다. 상용 참조 73.0%와 유의한 차이가 없다(미조정 p=0.12) (arXiv).
- 5개 오픈 시스템을 앞섰고, 2B는 kev 체크포인트 4개를 전부 앞섰다 (arXiv).
출력 레이어 26개 letter 행 학습의 이득은 감지되지 않았다는 점도 저자들이 직접 보고한다. 작은 평가의 해상도 한계를 지적한다 (arXiv).
왜 중요한지 — Series 코딩 세션 라벨링
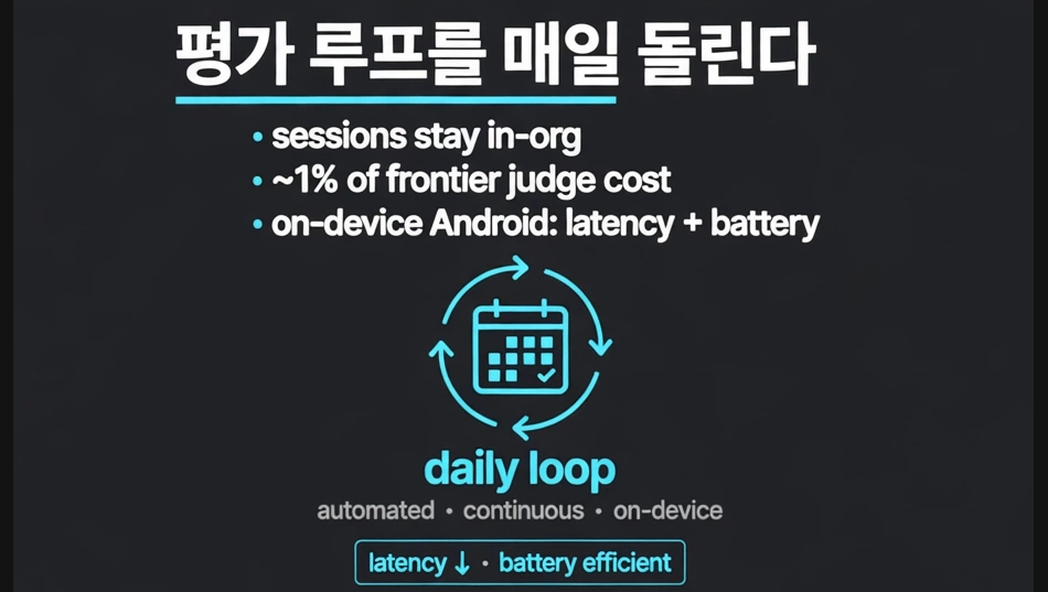
모바일 에이전트 평가에 frontier judge를 돌리면 패스당 $1,000이다. $0.06짜리 사내 judge가 같은 일을 하면 평가 루프를 매일 돌릴 수 있다. Android 온디바이스에서도 one-forward-pass 판정은 지연·배터리 양쪽에 유리하다. 라벨링을 매일 돌리면 코딩 에이전트의 회귀를 조기에 잡을 수 있다 (이슈 배경).
아직 안 밝혀진 것
- 상용 참조 Jev의 정확한 버전·시점이 초록에 없다. 무엇을 이겼는지 불분명하다 — 미확인.
- Eikos 레시피·코퍼스의 라이선스·공개 범위가 초록에 없다. 재현 조건을 알 수 없다 — 미확인.
- 사내 judge의 실제 운영 배포 여부가 초록에 없다. 실험인지 운영인지 불분명하다 — 미확인.