#온디바이스
18개의 글
#3702
Drex Max v1 공개, 27B 판단 모델이 확률만 답하는 방식과 24GB Mac 실행 조건
Nace AI가 판단 전용 모델 Drex Max v1 가중치를 공개했습니다. 텍스트를 생성하지 않고 선택지별 확률을 돌려주며, Decision Index 67.52와 24GB Mac 실행 조건을 정리했습니다.
#3697
Hex 3.0.0 로컬 음성 입력 — 메모리 900MB에서 160MB로, Linux ARM64 패키지까지
anomalyco가 로컬 음성 입력 도구 Hex 3.0.0을 공개했습니다. 로컬 모델 메모리는 약 900MB에서 약 160MB로 줄었고, Linux ARM64 빌드와 .deb·.rpm 패키지, Vocabulary와 hex 명령이 추가됐습니다.
#3693
1.3B 문서 파싱 OCR MiniCPM-OCR-1.0 — 93.68점, 1.2 pages/s
OpenBMB가 MiniCPM-V/o 패밀리 첫 OCR 특화 모델 MiniCPM-OCR-1.0(1.3B)을 공개했습니다. Real5-OmniDocBench 93.68, 처리량 1.2 pages/s, vLLM·SGLang 등 첫날 지원과 한국어 품질 미확인 지점을 정리했습니다.
#3692
speridlabs idol — 사진 한 장을 3D 가우시안 스플랫으로, VRAM 7.2GB·2초 미만
speridlabs가 사진 한 장에서 최대 1,048,576개의 3D 가우시안을 생성하는 image-to-3D 모델 idol을 공개했습니다. VRAM 7.2GB, 2초 미만 실행, .ply 출력과 게이트 모델 2개 동의 조건을 정리했습니다.
#3689
화면을 뺏지 않는 Android 에이전트 Mika — 가상 화면 조작과 무선 디버깅 페어링 구조 정리
wangzan101의 Mika는 보이지 않는 백그라운드 가상 화면에서 앱을 대신 조작하는 온디바이스 Android 에이전트입니다. 공개 이틀 만에 GitHub 스타 2,567개, 서버 없는 BYOK 구조와 요구 사양을 정리했습니다.
#3641
Spark-X2.6-4B, 트렌딩 진입한 4B 대화형 오픈 모델 — 영·중 지원·Apache-2.0
XHToken의 Spark-X2.6-4B가 Hugging Face 트렌딩에 진입했습니다. 등록일·다운로드·언어·라이선스 등 확인된 사실과 벤치마크·한국어 성능 같은 미확인 항목을 구분해 정리했습니다.
#3631
hunch 공개 — EmbeddingGemma2 기반 System One 판단 서버, CPU 추론
undrgrnd-labs가 EmbeddingGemma2 기반 System One 판단 서버 hunch를 공개했습니다. 느린 teacher 모델에서 배운 작은 student가 CPU에서 밀리초 단위로 답하는 구조와 성능 수치를 정리했습니다.
#3624
GUI-JEPA 공개 — 디코더 없이 모바일 GUI 동작을 고르는 빠른 에이전트 정책
Bingchao Wang 연구진이 디코더 없는 모바일 GUI 에이전트 정책 GUI-JEPA를 공개했습니다. 토큰 생성 대신 잠재 공간에서 동작을 골라 Qwen2.5-VL-7B 대비 2.8~4.0배 빠르고 파라미터는 6% 수준입니다. 설계와 한계를 정리했습니다.
#3564
LFM3: 하나의 백본에서 갈라진 6종 모델 — Liquid AI의 온디바이스 전문화 전략
Liquid AI가 하나의 백본에서 갈라진 6종 오픈웨이트 모델 LFM3를 공개했습니다. 22T 토큰 학습, 256K 컨텍스트, 기기에서 도는 작은 모델의 실무적 의미를 정리합니다.
#3531
gpu-unlock-ada: RTX 4090·4070 Ti SUPER 텐서코어 제한 해제 커널 모듈
JustAResearcher의 gpu-unlock-ada가 RTX 4090과 4070 Ti SUPER의 텐서코어 제한을 푸는 Linux 커널 모듈로 공개됐다. 발급 속도는 약 2배로 측정됐지만, 실제 GEMM 향상은 형태에 따라 12–34%에 그쳤다.
#3529
Zagitta gpu-unlock: RTX 30 텐서코어 제한 해제, BF16 최대 80% 향상 주장
Zagitta의 gpu-unlock은 RTX 30 시리즈의 FP/BF16 텐서코어 명령어 발급 속도 제한을 푸는 오픈소스 프로젝트다. RTX 3090 Ti 벤치마크에서 BF16은 80%, TF32는 94% 올랐다고 보고됐다.
#3476
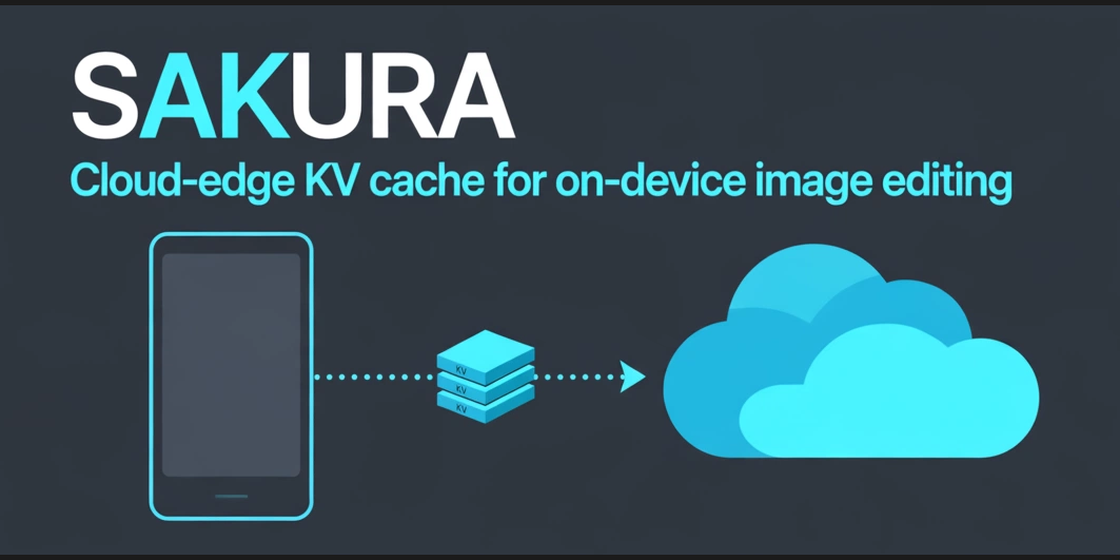
SAKURA: 대역폭 적응형 KV 캐시로 폰 온디바이스 이미지 편집 가속와 클라우드-엣지 구조
SAKURA는 대역폭 적응형 KV 캐시로 폰 온디바이스 이미지 편집의 전송 병목을 푼다. CacheGen 대비 지연 1.82배, 온디바이스 생성 대비 3.27배 감소, 캐시 저장 3.06배 축소.
#3470
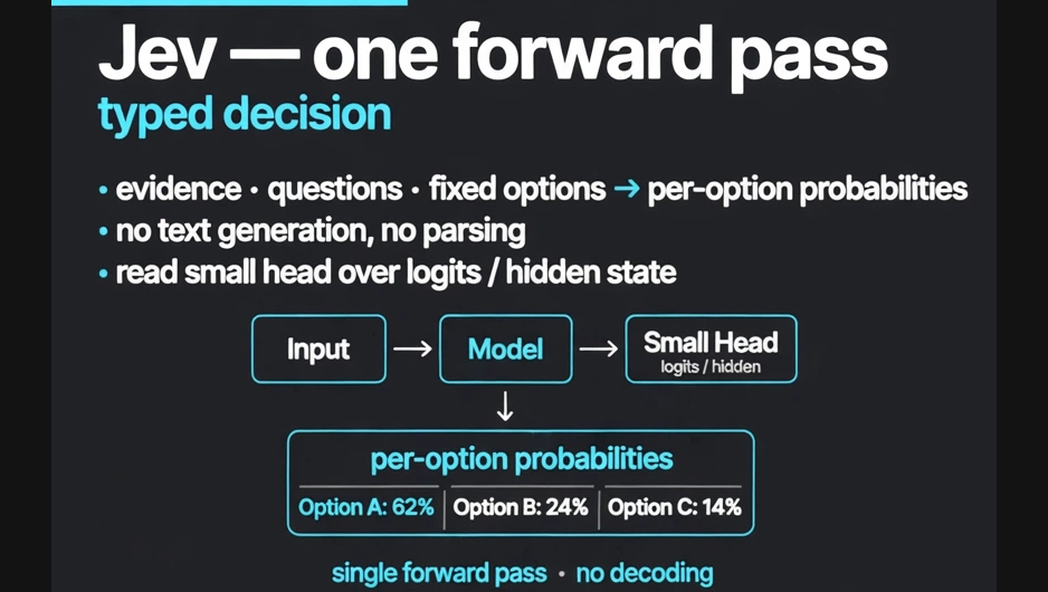
Jev 오픈 LoRA 재현: 한 번의 forward pass로 답을 읽는 결정 모델와 LoRA 헤드 읽기
Jev를 오픈으로 재현한 논문. 한 번의 forward pass로 증거·질문·고정 옵션을 옵션별 확률로 매핑한다. 1,000세션을 1개 GPU로 약 3분에, 약 $0.06에 판정한다.
#3446
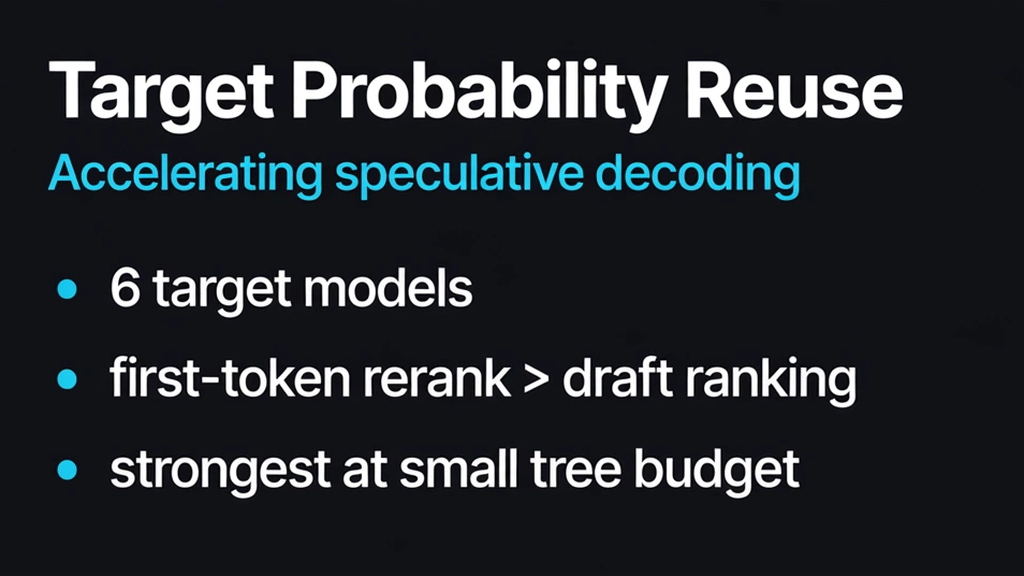
target probability reuse: 타깃 확률 재사용으로 추측 디코딩을 가속한다
추측 디코딩 검증 과정에서 이미 계산된 next-token 분포를 다음 트리 선택에 재사용한다. 여섯 개 target에서 first-token branch 리랭크가 draft ranking보다 expected acceptance를 높였다. 작은 tree budget에서 효과 두드러.
#3386
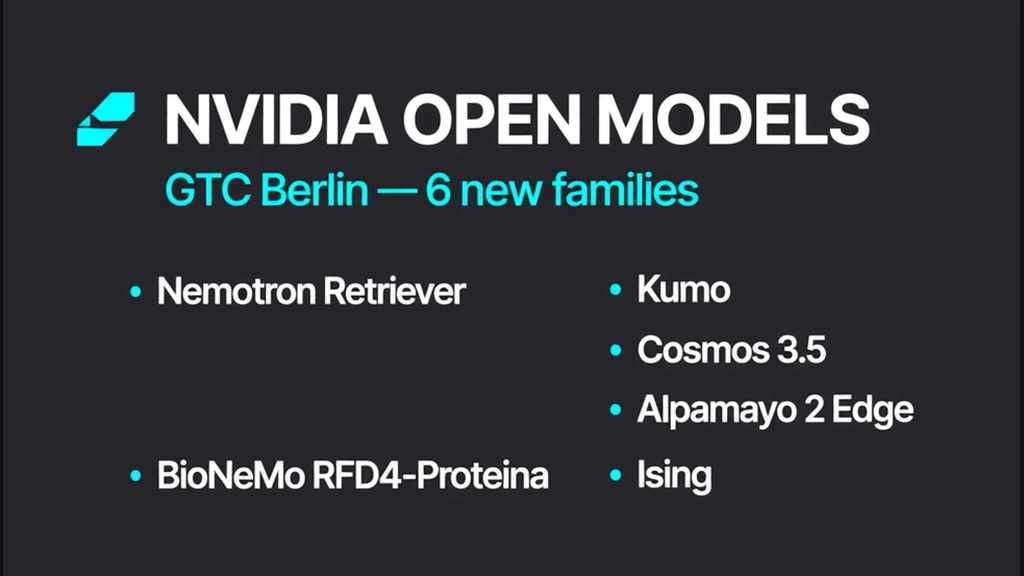
NVIDIA 오픈모델 대확장: 6개 신규 패밀리 GTC Berlin에서 일괄 공개와 바이오·양자 분야
NVIDIA가 GTC Berlin에서 언어·로보틱스·바이오·양자 컴퓨팅을 가로지르는 오픈 모델 6종을 발표했다. RAG용 리트리버, 구조화 데이터 예측, 로보틱스 월드 모델이 모두 오픈 웨이트로 제공된다.
#3383
Underdog Bark 3.0: 163MB 음성 모델이 Whisper보다 낮은 오류율 주장
Underdog AI가 163MB 음성 인식 모델 Bark 3.0을 출시했다. 회의 녹음 단어 오류율 자사 측정 7.82%로 Whisper large-v3(13.63%)보다 낮다고 주장했다. CC-BY 4.0 오픈소스, 영어 전용.
#3382
DigUp: EmbeddingGemma 2 기반 온디바이스 파일 의미 검색 데스크톱 앱와 단축키 검색
EmbeddingGemma 2(740M, Apache 2.0)를 쓴 오픈소스 데스크톱 파일 의미 검색 앱 DigUp. 865MB 모델을 1회 내려받으면 이후 전부 온디바이스 동작. 텔레메트리도 계정도 없다. Mac/Windows/Linux 지원, GitHub 5.3k 스타.
#3333
humanizer 12B: AI 초안을 사람처럼 고치는 로컬 리라이팅 모델의 정체와 95% 인간 판정
AI 초안을 사람이 쓴 것처럼 다시 써주는 12B 로컬 리라이팅 모델 humanizer. 숫자·날짜·인용은 그대로 유지하고, Originality.ai 최고 강도에서 95%가 인간 판정. Gemma 4 파인튜닝, Apache-2.0, 2-bit QAT 3.9GB 로컬 실행.