1.3B 문서 파싱 OCR MiniCPM-OCR-1.0 — 93.68점, 1.2 pages/s
OpenBMB는 MiniCPM-V/o 패밀리에서 처음 나온 OCR 특화 모델 MiniCPM-OCR-1.0을 공개했습니다. 파라미터는 1.3B이며, 문서 이해에 집중한 소형 모델입니다.
대형 OCR 모델과 맞붙는 구도를 1.3B 규모로 노렸다는 점이 이번 공개의 핵심입니다. 속도와 품질을 함께 잡겠다는 포지션이 모델 카드 곳곳에서 드러납니다.
공개 내용
모델 카드는 이 모델을 패밀리 최초의 OCR 특화 모델로 소개합니다. 베이스 모델은 openbmb/MiniCPM-V-4.6이며, 파이프라인 유형은 image-text-to-text입니다.
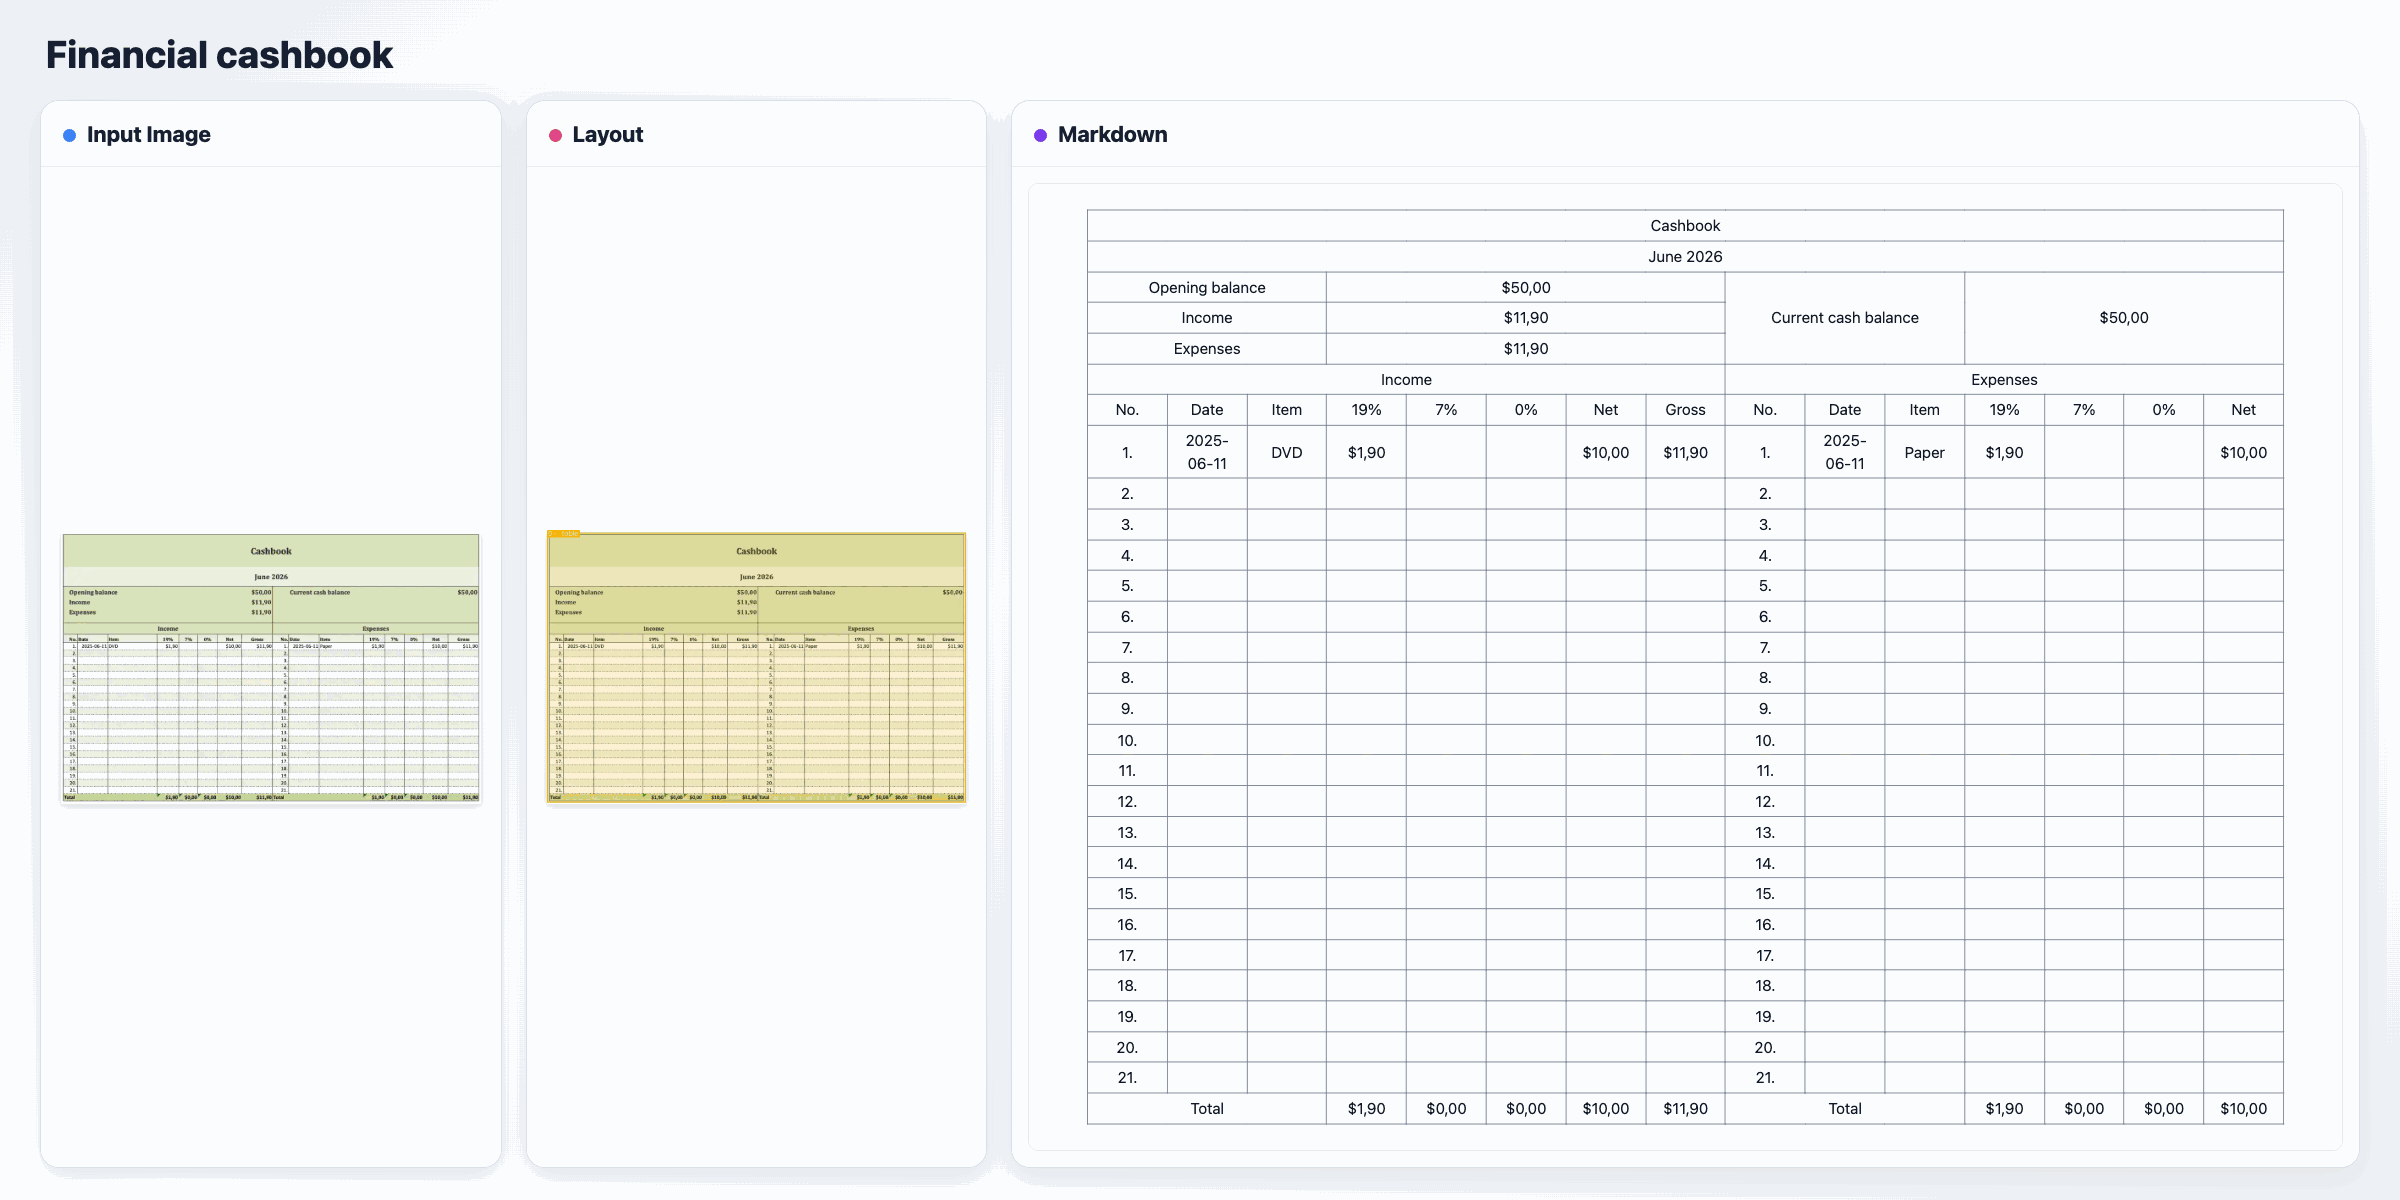
- 텍스트·표·수식·차트·도장까지 포함한 구조화 정보 추출에 집중합니다
- 대상 문서는 중국어·영어 문서와 PDF입니다
- 스캔본뿐 아니라 휘어진 페이지·사진·기울어진 페이지도 처리 대상으로 명시합니다
- Hugging Face 확인 시점(2026-10-31) 기준 좋아요 379, 다운로드 3,050을 기록했습니다
숫자로 본 성능
모델 카드가 제시한 대표 점수는 Real5-OmniDocBench 93.68입니다. 처리량은 1.2 pages/s로 제시됐습니다.
"SOTA document parsing: 93.68 on Real5-OmniDocBench" — 모델 카드 원문 표기입니다.
다만 처리량 수치에는 측정 조건이 붙습니다. RTX 5090 환경에서 OmniDocBench v1.6 이미지 1,651장을 동시성 1로 처리한 결과입니다.
DSpark 디코딩 가속을 적용하면 종단 처리 효율이 55% 개선된다는 설명도 함께 제시됐습니다. 조건이 다른 환경에서는 같은 수치를 그대로 기대하기 어렵습니다.
배포와 실행 경로
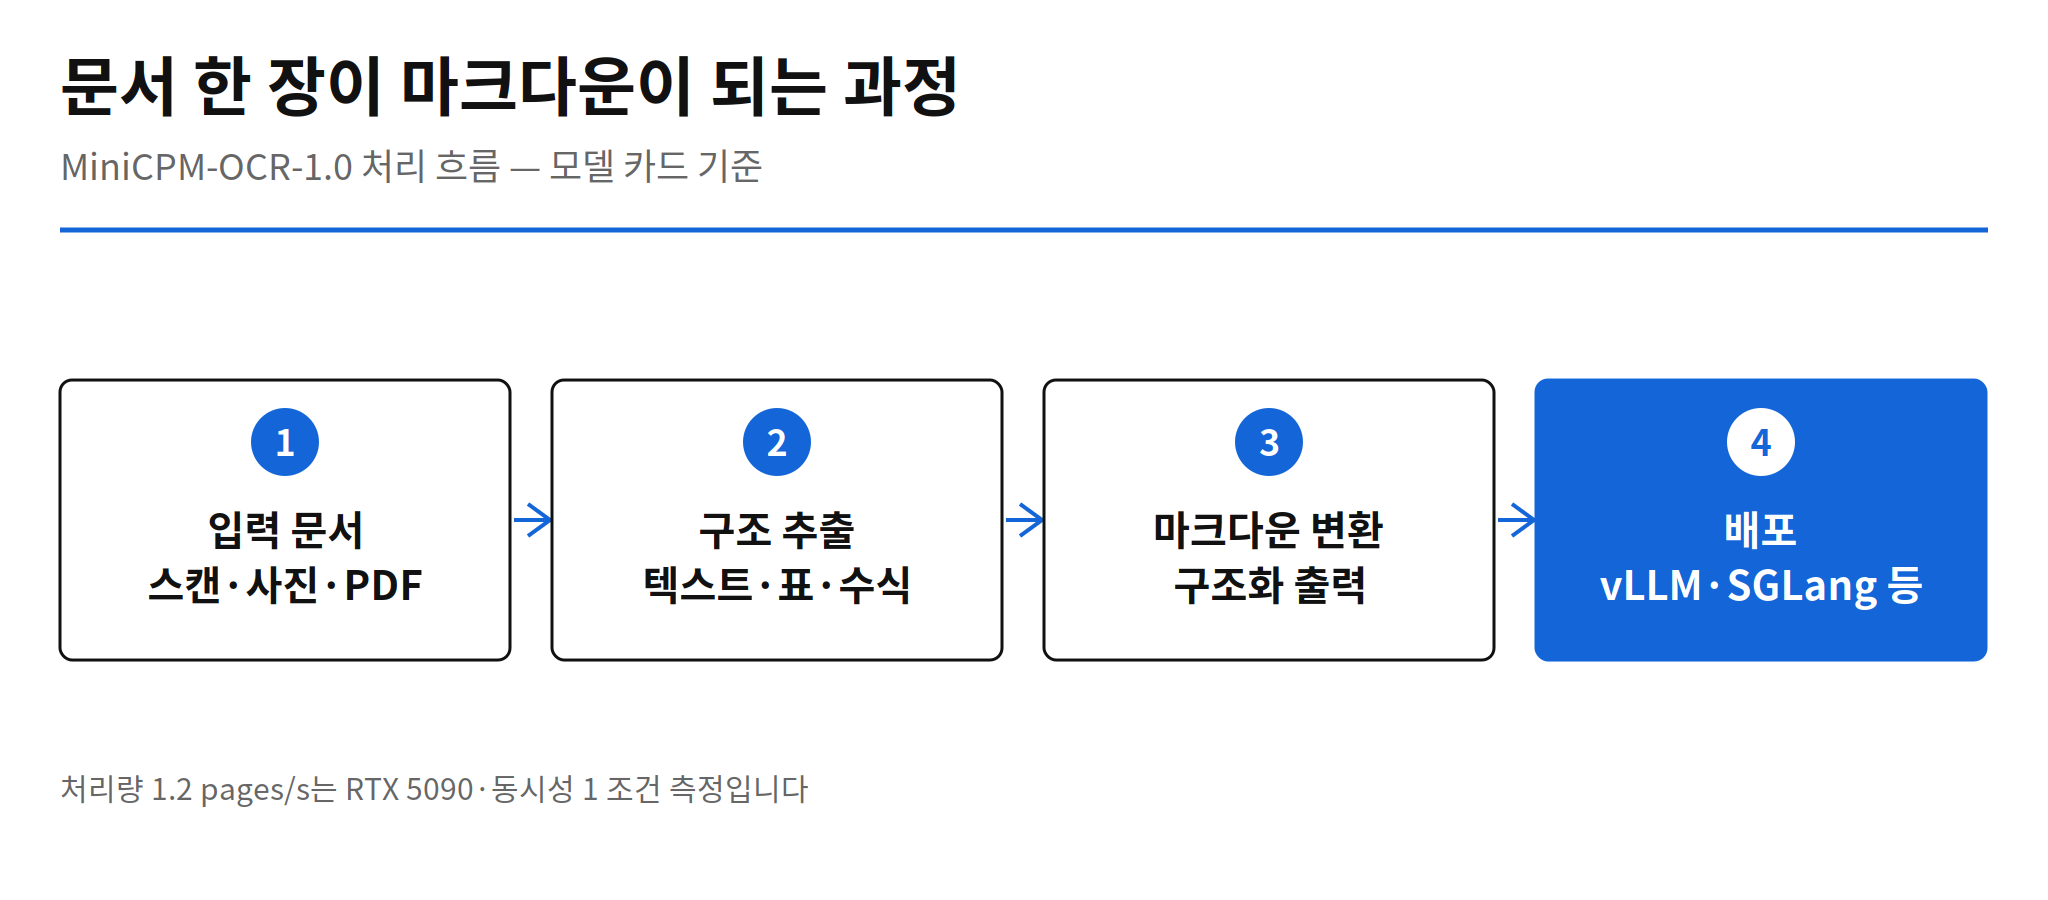
배포 경로는 공개 첫날부터 넓게 열려 있습니다. 모델 카드는 vLLM, SGLang, llama.cpp, Ollama 지원을 명시합니다.
- 서버 추론은 vLLM·SGLang 경로로 붙일 수 있습니다
- 로컬 실행은 llama.cpp·Ollama 경로가 열려 있습니다
- 재현 가이드는 GitHub 레포에 공개돼 있습니다
1.3B 규모와 로컬 실행 경로가 함께 갖춰져 있어서, 온디바이스 문서 처리로 확장해 볼 여지도 있습니다. 물론 실제 구동 성능은 기기별 확인이 필요합니다.
확인되지 않은 지점
- 제시된 벤치마크는 모델 카드 자체 평가입니다. 독립 재현 결과는 아직 미확인입니다
- 한국어 문서 처리 품질은 미확인입니다. 모델 카드는 중국어·영어를 명시하고 있습니다
- 1.2 pages/s는 특정 GPU·동시성 조건의 측정값입니다. 일반 환경의 처리량으로 읽으면 안 됩니다
실무 판단
문서 파싱은 사내 문서·PDF 자동화의 기반 기술입니다. 스캔 문서를 마크다운으로 바꾸는 과정은 RAG 입력 전처리와도 바로 연결됩니다.
도입 판단의 순서는 명확합니다. 한국어 문서 샘플로 직접 돌려 보고, 표·수식 유지율을 확인한 뒤에 파이프라인 편입을 결정하는 편이 안전합니다.
중국어·영어 문서 비중이 높은 팀이라면 1.3B 소형 모델의 비용 구조만으로도 검토 가치는 충분합니다. 반대로 한국어 문서가 중심이면 품질 검증이 먼저입니다.