GUI-JEPA 공개 — 디코더 없이 모바일 GUI 동작을 고르는 빠른 에이전트 정책
기존 방식의 병목
모바일 GUI 에이전트는 보통 7B 규모로 미세 조정된 비전-언어 모델(VLM)이 동작을 텍스트로 하나씩 생성하는 방식으로 동작합니다. 매 동작마다 토큰을 하나씩 디코딩해야 하니 느리고 메모리도 많이 듭니다. 후보 동작을 점수 매기는 방식도 대규모 언어 모델이나 VLM을 루프 안에 두는 구조라, 병목이 사라지지 않았습니다.
온디바이스나 저지연 환경에서는 이 구조가 그대로 비용이 됩니다. 화면을 보고 다음 동작을 정하는 일이 매번 거대한 모델의 생성을 거치기 때문입니다. GUI-JEPA는 여기서 질문을 바꿨습니다. 동작을 새로 써내는 대신, 후보 중에서 고르는 문제로 바꾼 것입니다.
생성에서 선택으로
GUI-JEPA는 Joint-Embedding Predictive Architecture(JEPA)에 기반한 첫 디코더 없는 GUI 에이전트 정책입니다. 라벨 없는 GUI 스크린샷으로 사전 학습한 JEPA 인코더의 잠재 공간에서 동작을 선택합니다.
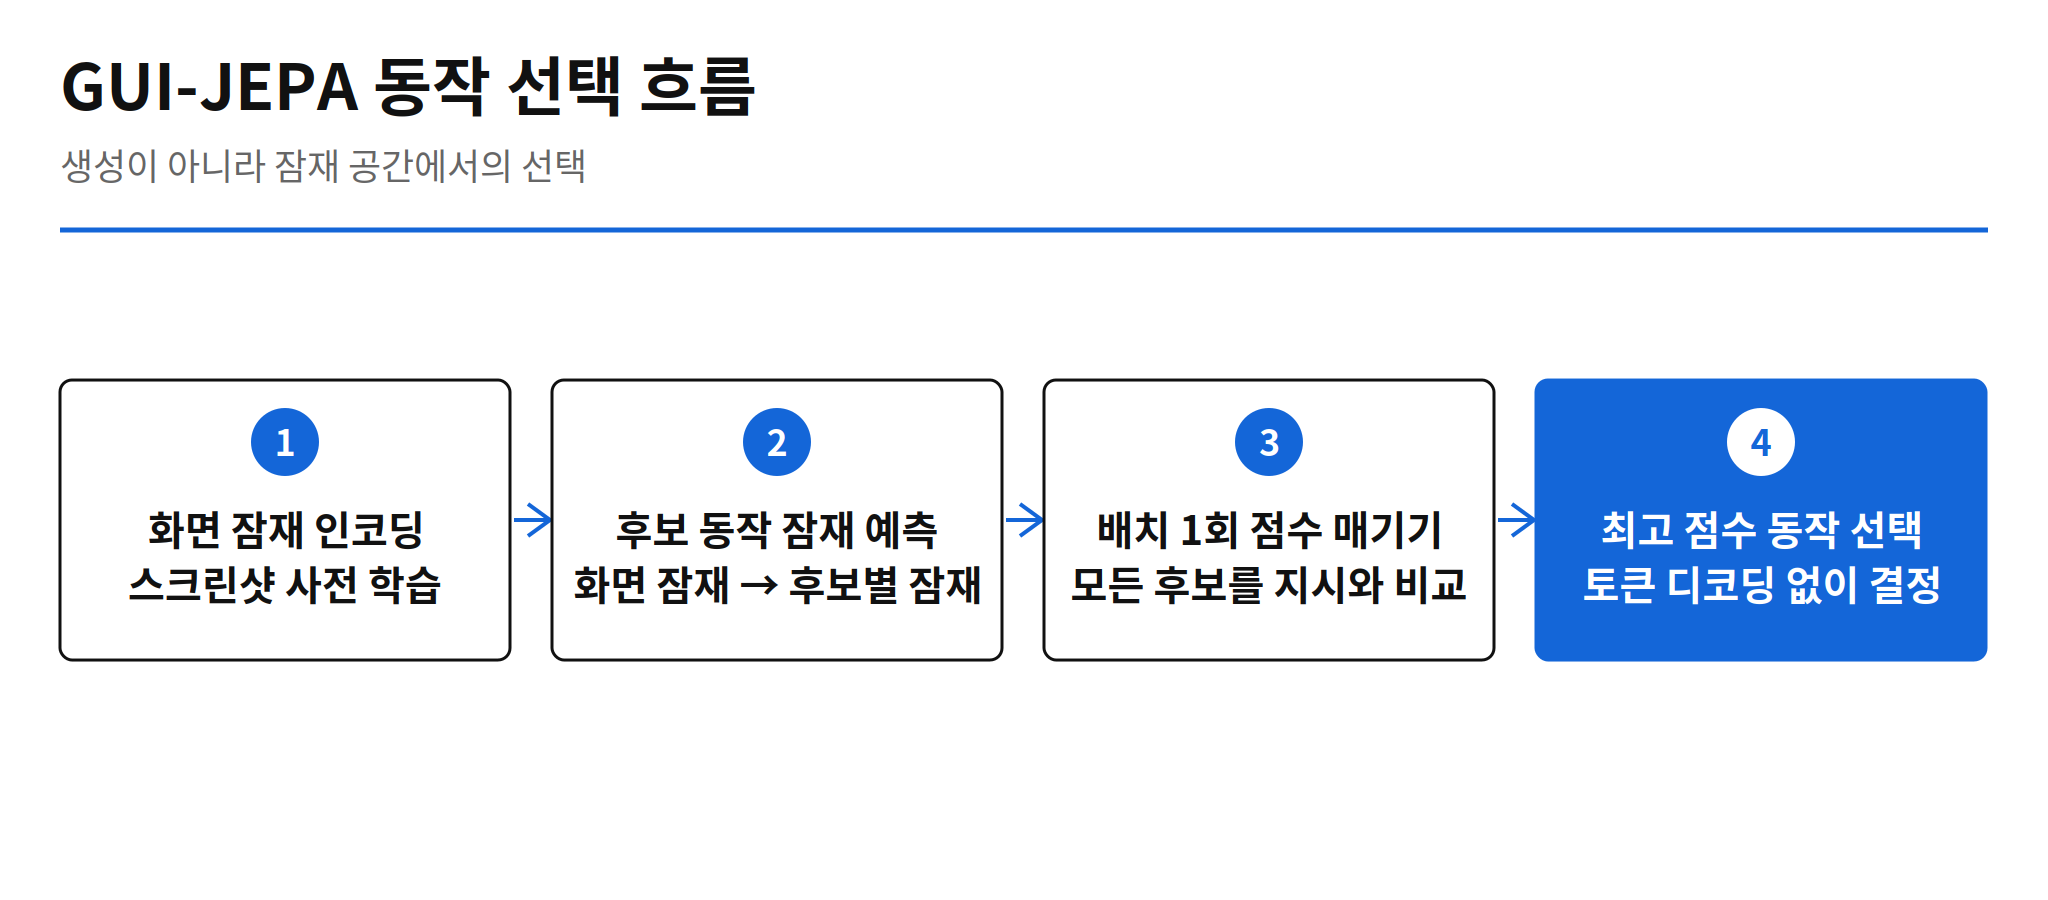
흐름은 네 단계로 정리됩니다. 먼저 화면을 잠재로 인코딩하고, 동작·영역 조건 잠재 예측기가 화면 잠재를 후보 동작별 잠재로 바꿉니다. 이어서 가벼운 헤드가 토큰 디코딩 없이 한 번의 배치 패스로 모든 후보를 지시와 비교해 점수를 매깁니다. 마지막으로 가장 높은 점수의 동작을 선택합니다.
핵심은 모델을 더 크게 만드는 것이 아니라, 동작 결정 자체를 생성에서 선택으로 옮긴 점입니다.
측정 결과
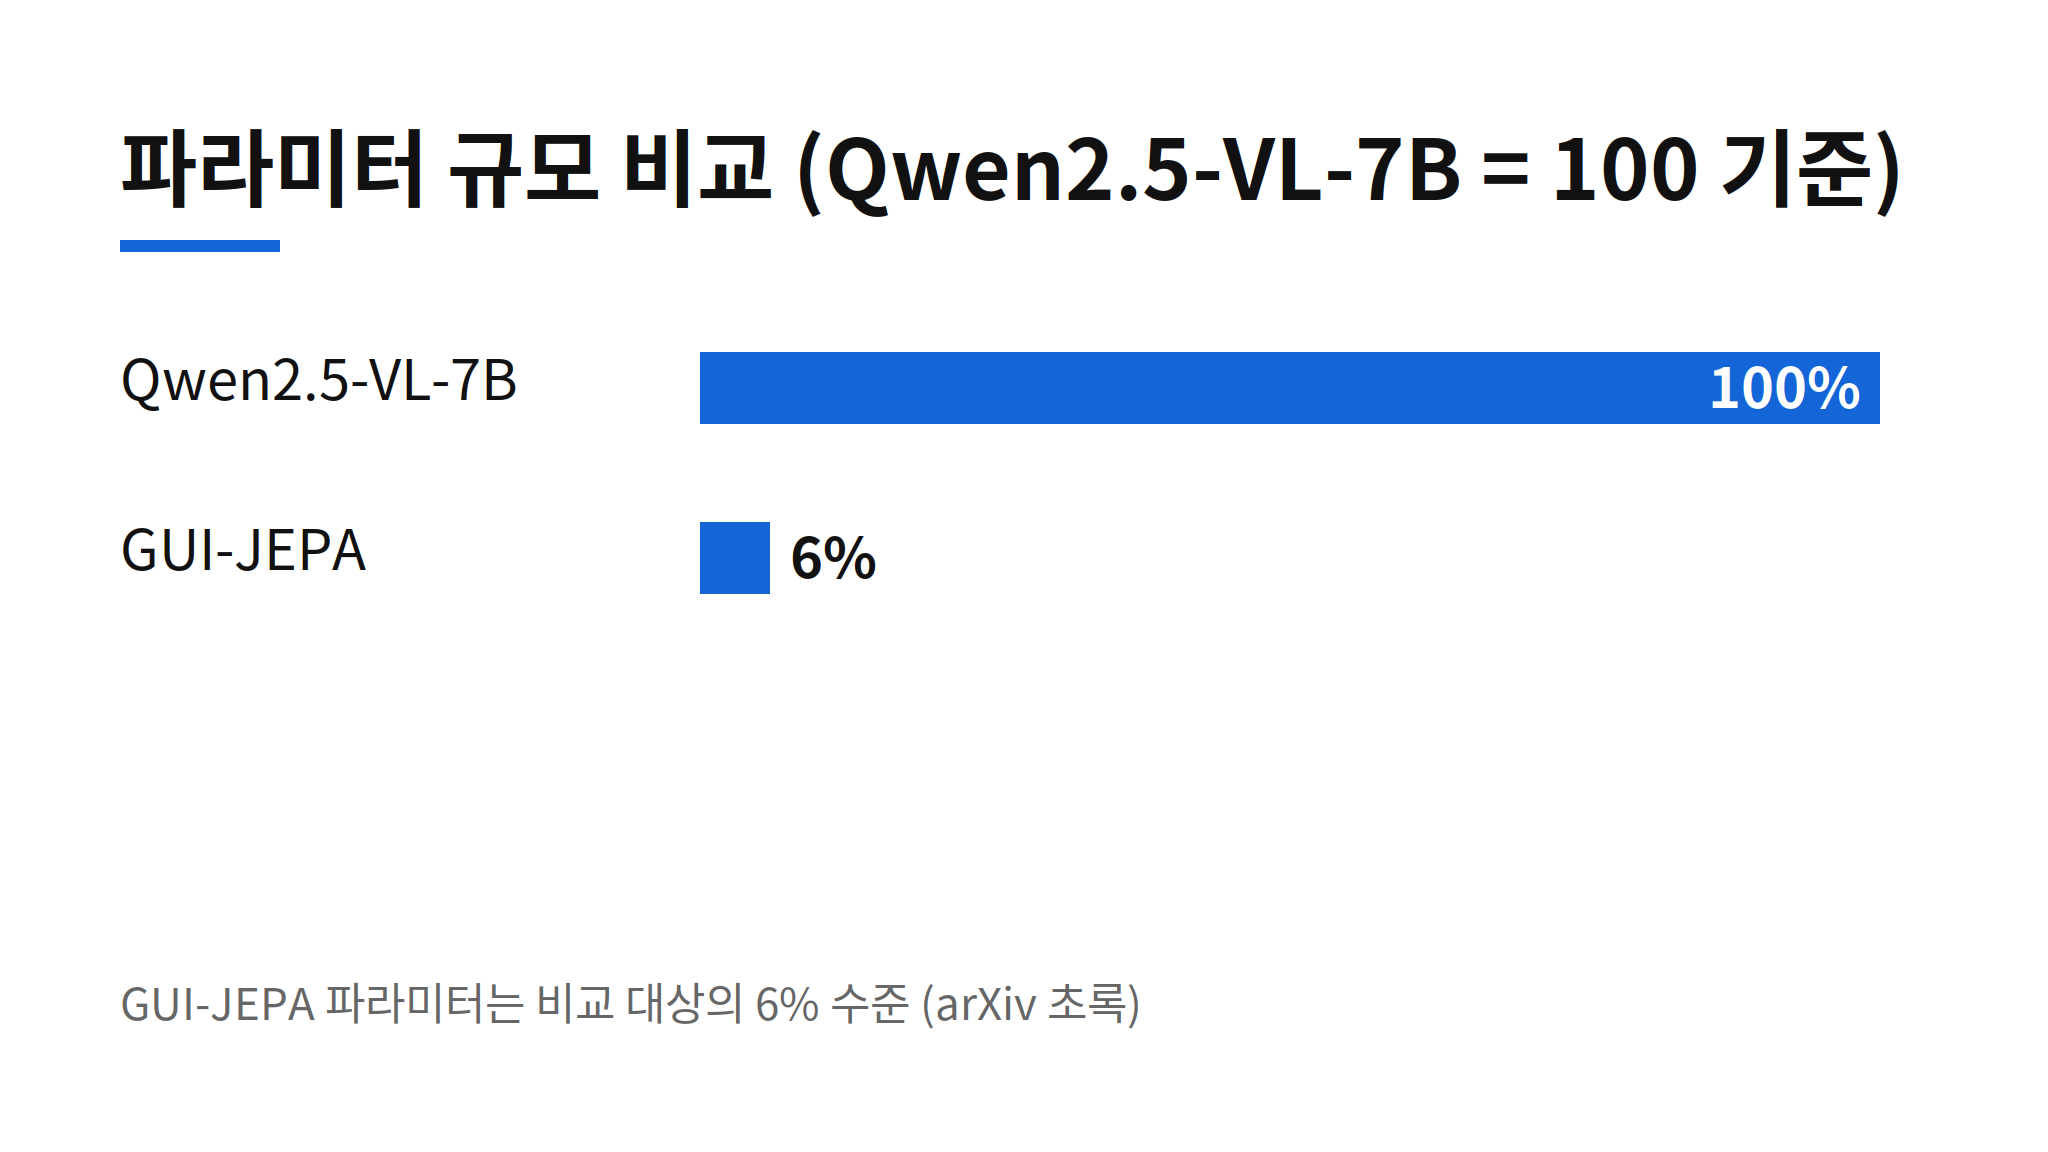
AndroidControl에서 GUI-JEPA는 같은 GPU에서 같은 입력으로 미세 조정한 Qwen2.5-VL-7B 에이전트 대비 2.8~4.0배 빨랐습니다. 분포 내 정확도는 86~92%에 도달했으며, 파라미터는 비교 대상의 6% 수준이었습니다.
- 속도 2.8~4.0배 — 같은 GPU·같은 입력 조건에서 Qwen2.5-VL-7B 미세 조정 에이전트와 비교한 결과입니다
- 정확도 86~92% — 분포 내 조건에서의 수치이며, 범위가 있는 만큼 단일 대표값으로 읽으면 안 됩니다
- 파라미터 6% 수준 — 모델 크기 자체가 작아졌다는 점이 속도 개선과 함께 제시됐습니다
학습 방식의 이례적인 결과
예측기는 화면 동역학 사전 학습이 아니라 판정 자체를 위해 학습됩니다. 그런데 무작위 초기화된 예측기도 동역학 사전 학습 예측기만큼 잘 동작했다고 합니다. 동역학을 먼저 배우는 단계가 판정 성능에 필수적이지 않았다는 뜻으로 읽힙니다.
이 결과는 설계 단순화의 여지를 보여줍니다. 동역학 사전 학습을 생략해도 판정 품질이 유지된다면, 학습 파이프라인의 한 단계를 덜 수 있기 때문입니다. 다만 이 결론은 초록에 제시된 범위 안에서만 유효합니다. 어떤 태스크·조건에서 동등했는지는 본문 확인이 필요합니다.
아직 확인되지 않은 점
분포 외 환경에서의 정확도와 실패 형태는 초록에 수치로 제시되지 않았습니다. 학습에 쓴 GUI 스크린샷의 규모와 출처도 초록에서 확인되지 않았습니다. 실제 기기에서의 지연·메모리 측정 결과 역시 초록에 언급되지 않았으므로, 온디바이스 실측 수치로 인용하면 안 됩니다.
실무 판단: 온디바이스 설계의 참고 근거로 읽을 것
Android 개발자에게 이 논문의 가치는 온디바이스 에이전트 설계의 참고 근거에 있습니다. 2.8~4.0배 속도, 6% 파라미터라는 수치는 경량화 방향을 가늠하는 기준이 됩니다. 코드가 공개돼 있어 재현과 응용도 가능합니다. 다만 실제 기기 실측이 없다는 점은 분명히 구분해야 합니다. 분포 내 정확도만으로 실전 성능을 단정하지 말고, 분포 외 조건에서의 실패 형태를 본문에서 확인한 뒤에 도입을 검토하는 것이 순서입니다.