humanizer 12B: AI 초안을 사람처럼 고치는 로컬 리라이팅 모델의 정체와 95% 인간 판정
10월 18일, Hugging Face에서 jialinyyzz/humanizer가 트렌딩 상위에 올랐다. AI가 쓴 초안(이메일·에세이·보고서·포럼 글, 영어+중국어)을 사람이 쓴 것처럼 다시 써주는 12B 텍스트 리라이팅 모델이다. 차별점은 명확하다: 탐지기를 속이는 게 아니라 문체를 다듬되 모든 숫자·단위·날짜·이름·인용을 그대로 유지하고 아무것도 추가하지 않도록 학습됐다. 게다가 로컬에서 돌아간다.
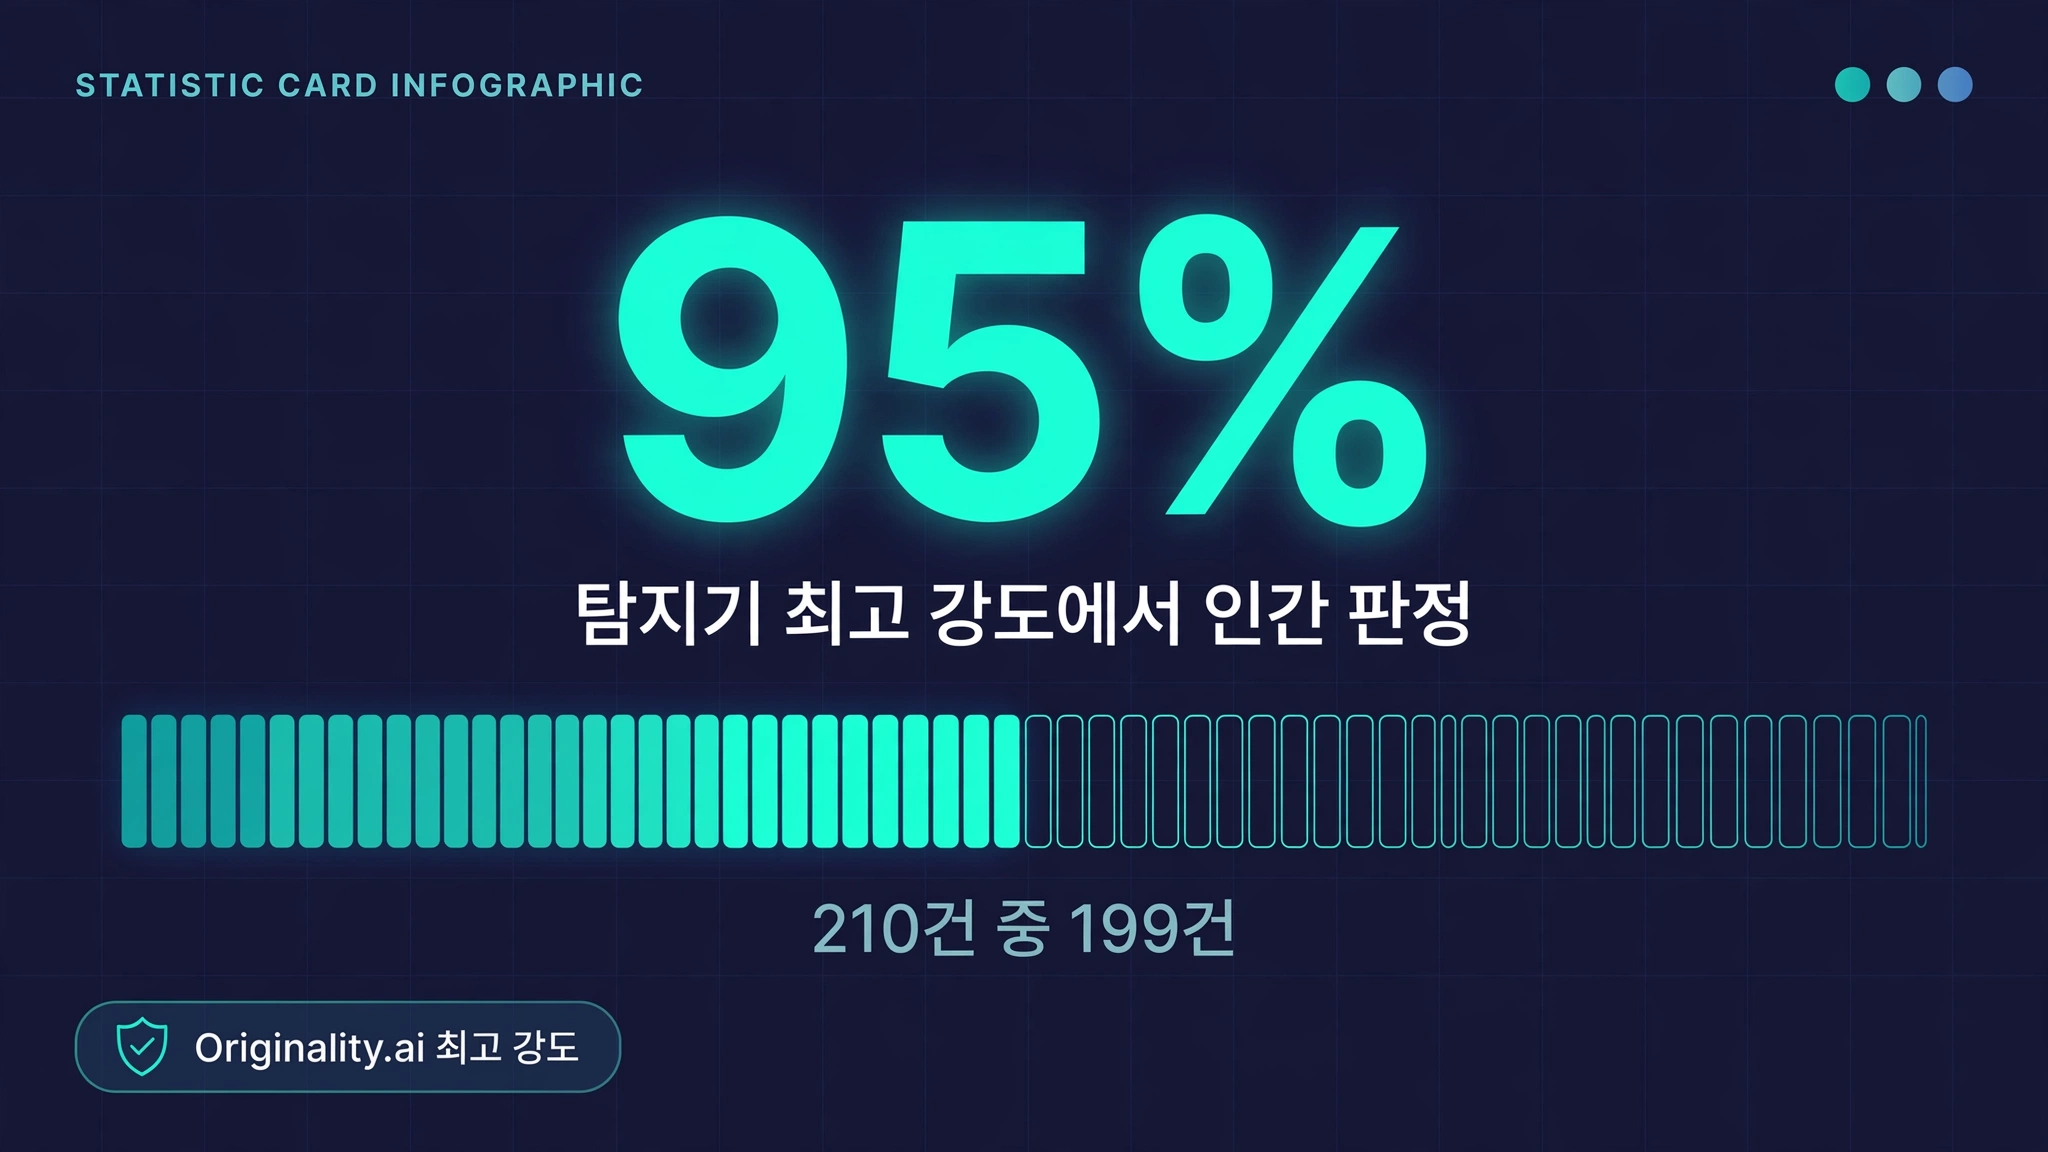
개발자 관점 한 줄 요약: Gemma 4 12B 파인튜닝 + Apache-2.0 라이선스의 오픈 가중치 리라이팅 모델. Originality.ai 최고 강도에서 영어 리라이트 210건 중 199건(95%)이 인간 판정. 2-bit 양자화 인식 학습(QAT)으로 3.9GB까지 줄여 노트북에서도 돌릴 수 있다. 문서가 외부 API로 나가지 않는다는 점이 실무 도입의 가장 큰 장점이다.
핵심 사실
- jialinyyzz/humanizer — AI 초안을 사람이 쓴 것처럼 리라이팅. 베이스는
google/gemma-4-12B파인튜닝, 라이선스 Apache-2.0, 파이프라인 text-generation. (Hugging Face 모델카드) - HF 지표: likes 1,895 · downloads 95,870 (2026-10-18 기준). 레포 생성 2026-09-11, 최근 수정 2026-10-15 — 업데이트 직후 트렌딩 상위 진입. (Hugging Face API)
- 탐지기 평가: Originality.ai 최고 강도 설정에서 영어 리라이트 210건 중 199건(95%)이 인간 작성 판정. AI로 플래그된 건 11건, 이전 릴리스는 26건이었다. 학습 과정에 AI 탐지기는 전혀 사용하지 않았다고 명시. (모델카드, 2026-10-02 측정)
- 팩트 유지: 엄격한 LLM 판정에서 영어 리라이트 420건 중 376건이 사실 문제 없음. 문제가 발견된 경우 10건 중 9건 이상은 단어·구 하나 수준의 수정으로 해결. (모델카드)
- 양자화: 2-bit·Q3·Q4_K_M 파일에 양자화 인식 학습(QAT) 적용 — 3.9GB 2-bit 파일이 bf16 대비 top-1 토큰 일치율 87%(표준 양자화는 70%). Q6_K·Q8_0은 표준 빌드. (모델카드)
- 사용 경로 3가지: Mac(Apple silicon)·Windows용 데스크톱 앱(오프라인 동작, .docx·PDF 가져오기), CLI(
pipx install후hz paper.md), llama.cpp 직접 실행. 동반 GitHub 레포sgaofen/humanizer-local-model★349 (2026-09-11 생성). 최신 앱 릴리스는 app-v0.3.4 (2026-10-11). (모델카드, GitHub API)
바뀐 점과 그대로인 점
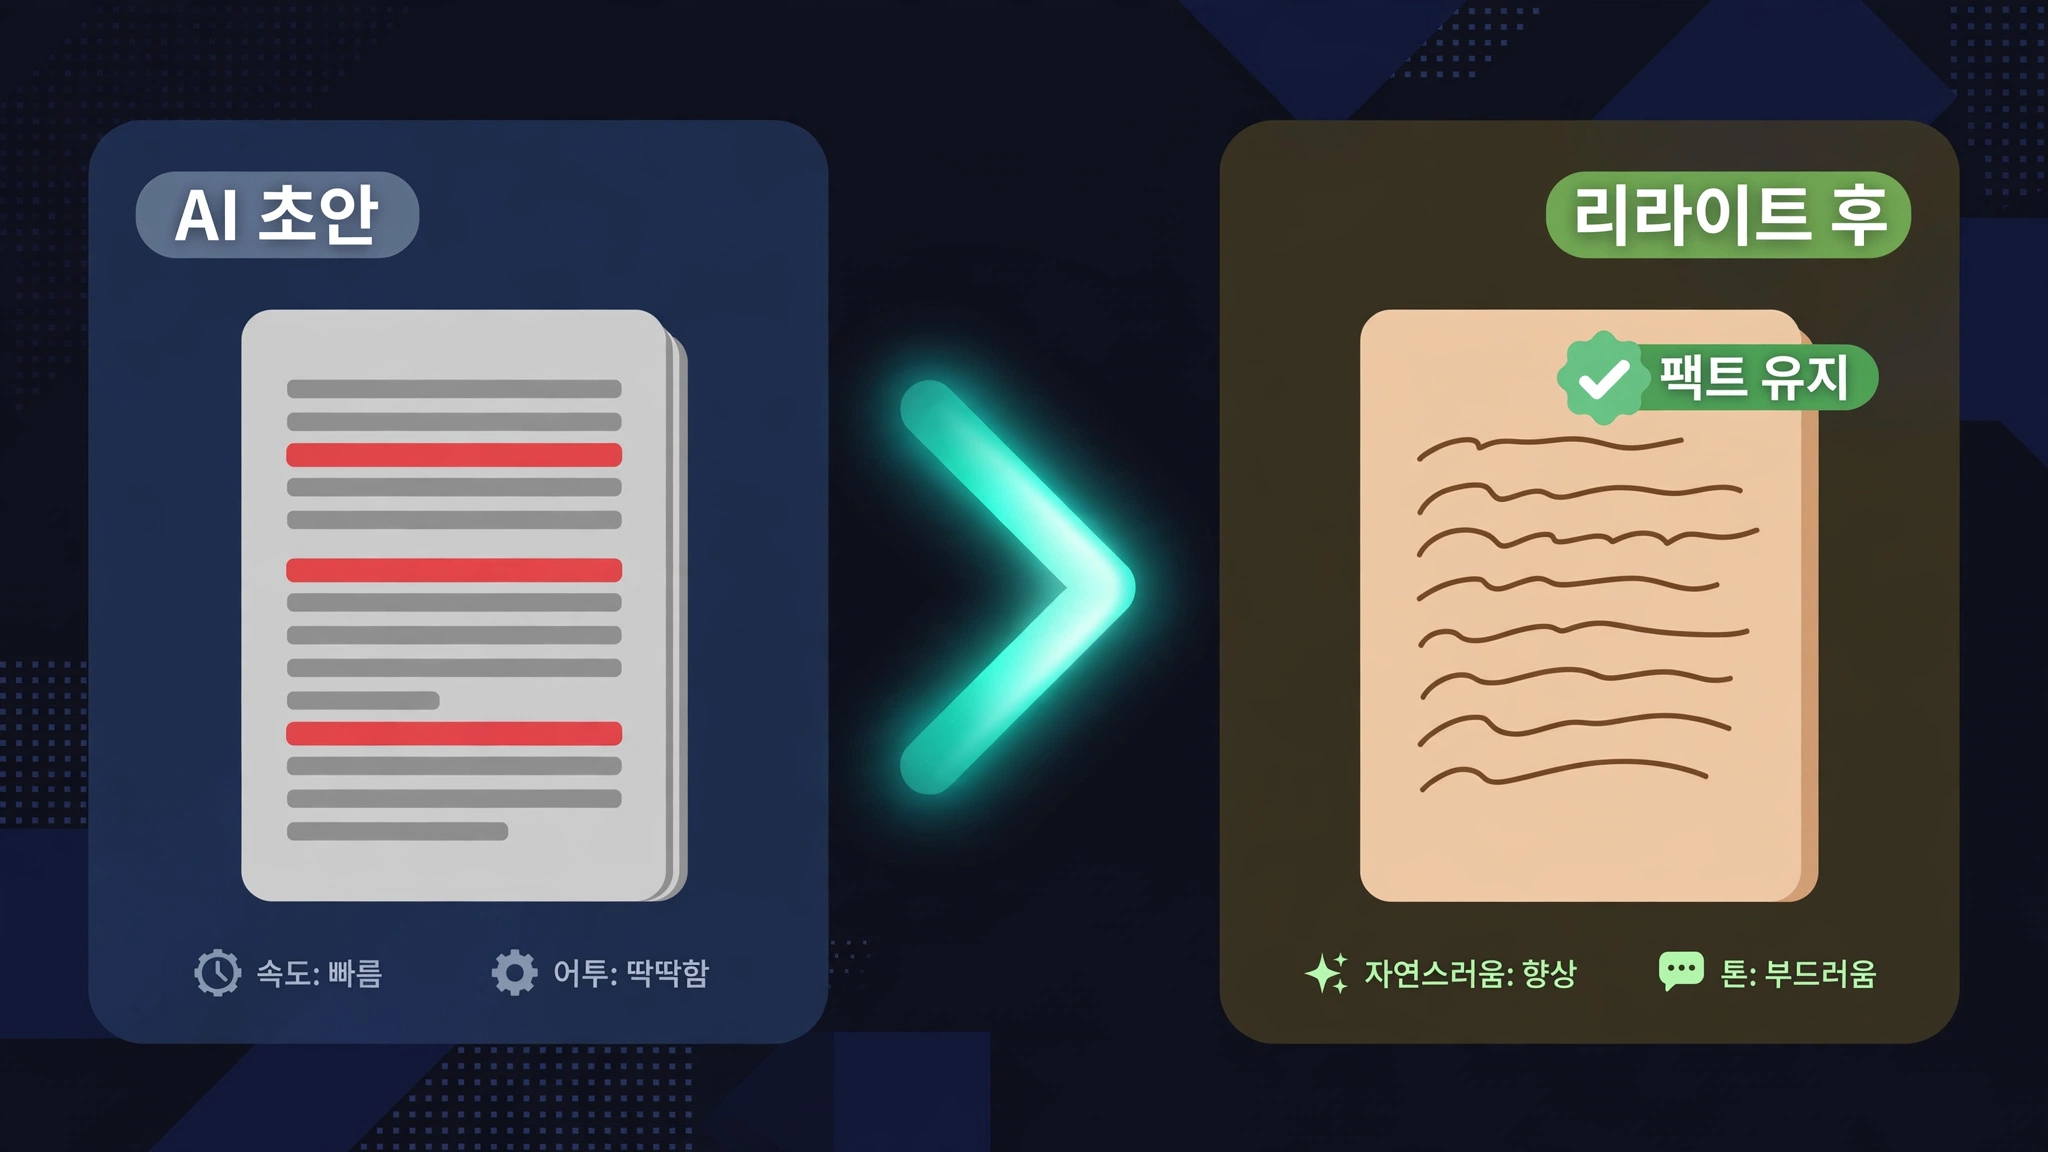
모델이 하는 일은 단순해 보이지만 설계가 영리하다. AI 초안의 "AI 티"(반복되는 문장 패턴, 딱딱한 접속사, 과도하게 균일한 리듬)를 사람의 문체 분포 쪽으로 옮기면서, 숫자·단위·날짜·이름·인용은 토큰 단위로 보존하도록 학습됐다. 이 팩트-보존 제약이 없는 리라이트 모델은 할루시네이션을 끼워넣기 쉬운데, humanizer는 그 지점을 정면으로 잡았다. LLM 판정 기준 팩트 문제율이 420건 중 44건(약 10.5%)이고 대부분 단어·구 하나 수정으로 해결되는 수준이라, 실무에서는 리라이팅 후 숫자·날짜·이름만 훑어보는 정도의 검수면 충분해 보인다.
95% 인간 판정: 평가의 실체
| 측정 (모델카드, 2026-10-02) | 수치 |
|---|---|
| 인간 판정 (Originality.ai 최고 강도) | 210건 중 199건 (95%) |
| AI 플래그 (현 릴리스) | 11건 |
| AI 플래그 (이전 릴리스) | 26건 |
| 팩트 문제 없음 (LLM 판정) | 420건 중 376건 |
| 2-bit QAT top-1 토큰 일치율 (bf16 대비) | 87% (표준 양자화 70%) |
주의 (미확인): "95% 인간 판정"은 Originality.ai 단일 탐지기의 자체 측정이다. 다른 탐지기에서의 성능은 공개되지 않았고, 학습 데이터의 구성·출처도 모델카드에 명시되어 있지 않다. 탐지 회피 용도 오용의 윤리적 쟁점이 있으나, 저자는 팩트 유지와 사전 검토(특히 숫자·날짜·이름)를 강조한다.
로컬 실행 + 3.9GB: 실무 도입 관점
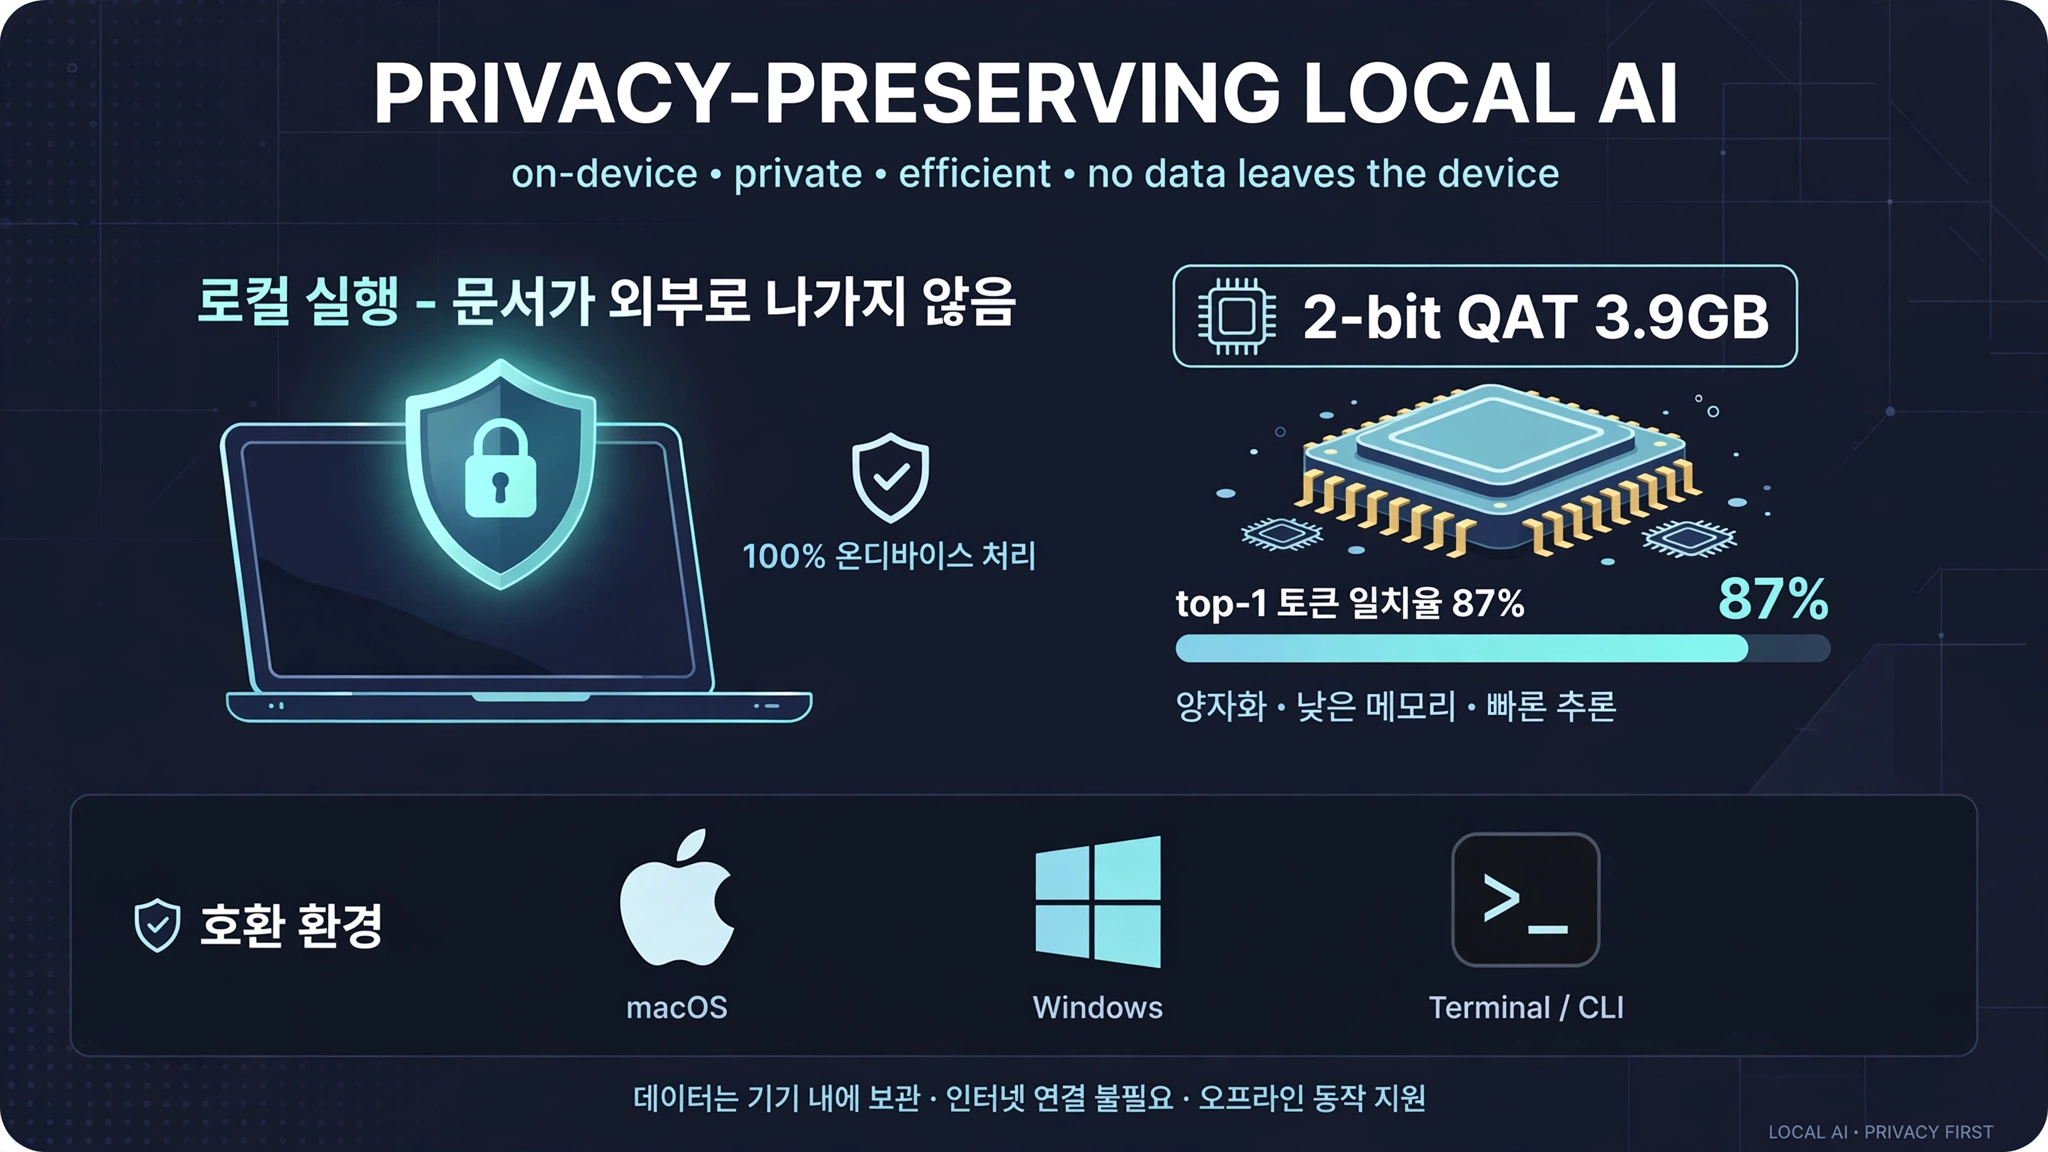
보고서·이메일 초안을 다듬을 때 가장 큰 걸림돌은 보안이다. 민감한 문서를 외부 API에 보내지 않고 로컬에서 처리할 수 있다는 점이 이 모델의 실무적 강점이다. 진입 장벽도 낮다:
# CLI 경로 — 설치 후 바로 리라이팅
hz paper.md

# llama.cpp 경로 — GGUF 파일을 직접 실행
llama-cli -m humanizer-Q2_K.gguf \
  -p "Rewrite this draft to sound natural, keep all numbers and dates unchanged."
양자화 인식 학습(QAT)을 2-bit까지 적용했다는 점도 주목할 만하다. 표준 2-bit 양자화가 bf16 대비 top-1 토큰 일치율 70%로 떨어지는 데 비해 QAT 버전은 87%를 유지한다. 3.9GB면 맥북·윈도우 노트북의 메모리 부담 없이 상주 실행이 가능한 수준이다. 텍스트 리라이팅은 실시간성이 덜 요구되는 작업이라, 이 정도면 에이전트 워크플로우의 후처리 단계(에이전트가 쓴 초안을 사람이 쓴 것처럼 다듬기)에도 무리 없이 끼워넣을 수 있다.
AX TF 관점: 에이전트가 생성하는 문서·리포트 초안은 "AI 티" 때문에 내부 공유나 대외 발신 전에 사람의 손을 탄다. humanizer 같은 리라이팅 후처리 단계가 표준 파이프라인에 들어오면, 팩트 보존 제약 덕분에 할루시네이션 리스크 없이 문체만 다듬을 수 있다. 다만 탐지기 우회 지표는 벤더 자체 측정이므로, 도입 전에는 우리 탐지 파이프라인으로 직접 재현 평가가 먼저다.