텐센트 Hy Memory 2.0: 에이전트 기억을 3B 특화 모델에 맡기는 구조와 55.49 하네스 점수
10월 16일, 텐센트 Hunyuan이 에이전트 메모리 프레임워크 Hy Memory 2.0을 발표하고 전용 모델·메모리 프레임워크·MemHub 앱의 3개 레이어를 오픈소스화했다. 핵심은 Hy-Memory-30B-A3B라는 메모리 라이터(writer) 전용 모델이다. 30B MoE 중 약 3B의 활성 파라미터만 쓰는 작은 모델이, 메모리 쓰기라는 단일 작업에서 범용 대형 모델을 이겼다는 게 텐센트의 주장이다.
개발자 관점 한 줄 요약: 에이전트의 "무엇을 기억할지 결정하는 쓰기(write) 경로"를 범용 LLM이 아니라 3B급 특화 모델로 떼어낸 아키텍처. 4개 하네스 평균 55.49로 Claude Opus 5(54.62)를 앞섰다고 주장하는데, 수치는 텐센트 자체 측정(20% 서브샘플)이라 독립 검증 전까지는 "주장"으로 읽어야 한다.
무엇을 발표했나: 핵심 사실
- Hy Memory 2.0: 에이전트 메모리 프레임워크. 전용 모델(Hy-Memory-30B-A3B) + 메모리 프레임워크 + MemHub 앱의 3층 구조로 오픈소스 공개.
- Hy-Memory-30B-A3B: Hugging Face의 tencent 공식 org에 공개. 외부 메모리 프레임워크의 쓰기 경로를 전담하는 30B MoE(약 3B 활성) 모델. 라이선스는 Apache 2.0.
- 드롭인 교체 표방: Mem0·MemOS·Hy-Memory(Chat·Working·Coding 시나리오) 안의 범용 LLM을 직접 대체하도록 설계됐고, 학습에 쓰지 않은 EverMemOS 같은 프레임워크로도 전이된다고 주장.
- 학습 방법: Memory On-Policy Distillation(OPD) 2단계 + Attributed Memory Reinforcement Learning.
- MemHub: 여러 AI 도구가 하나의 메모리를 공유하는 앱. 실제 동작·지원 도구 목록·호스티드 가격/가용성은 아직 미공개.
3층 레이어 아키텍처
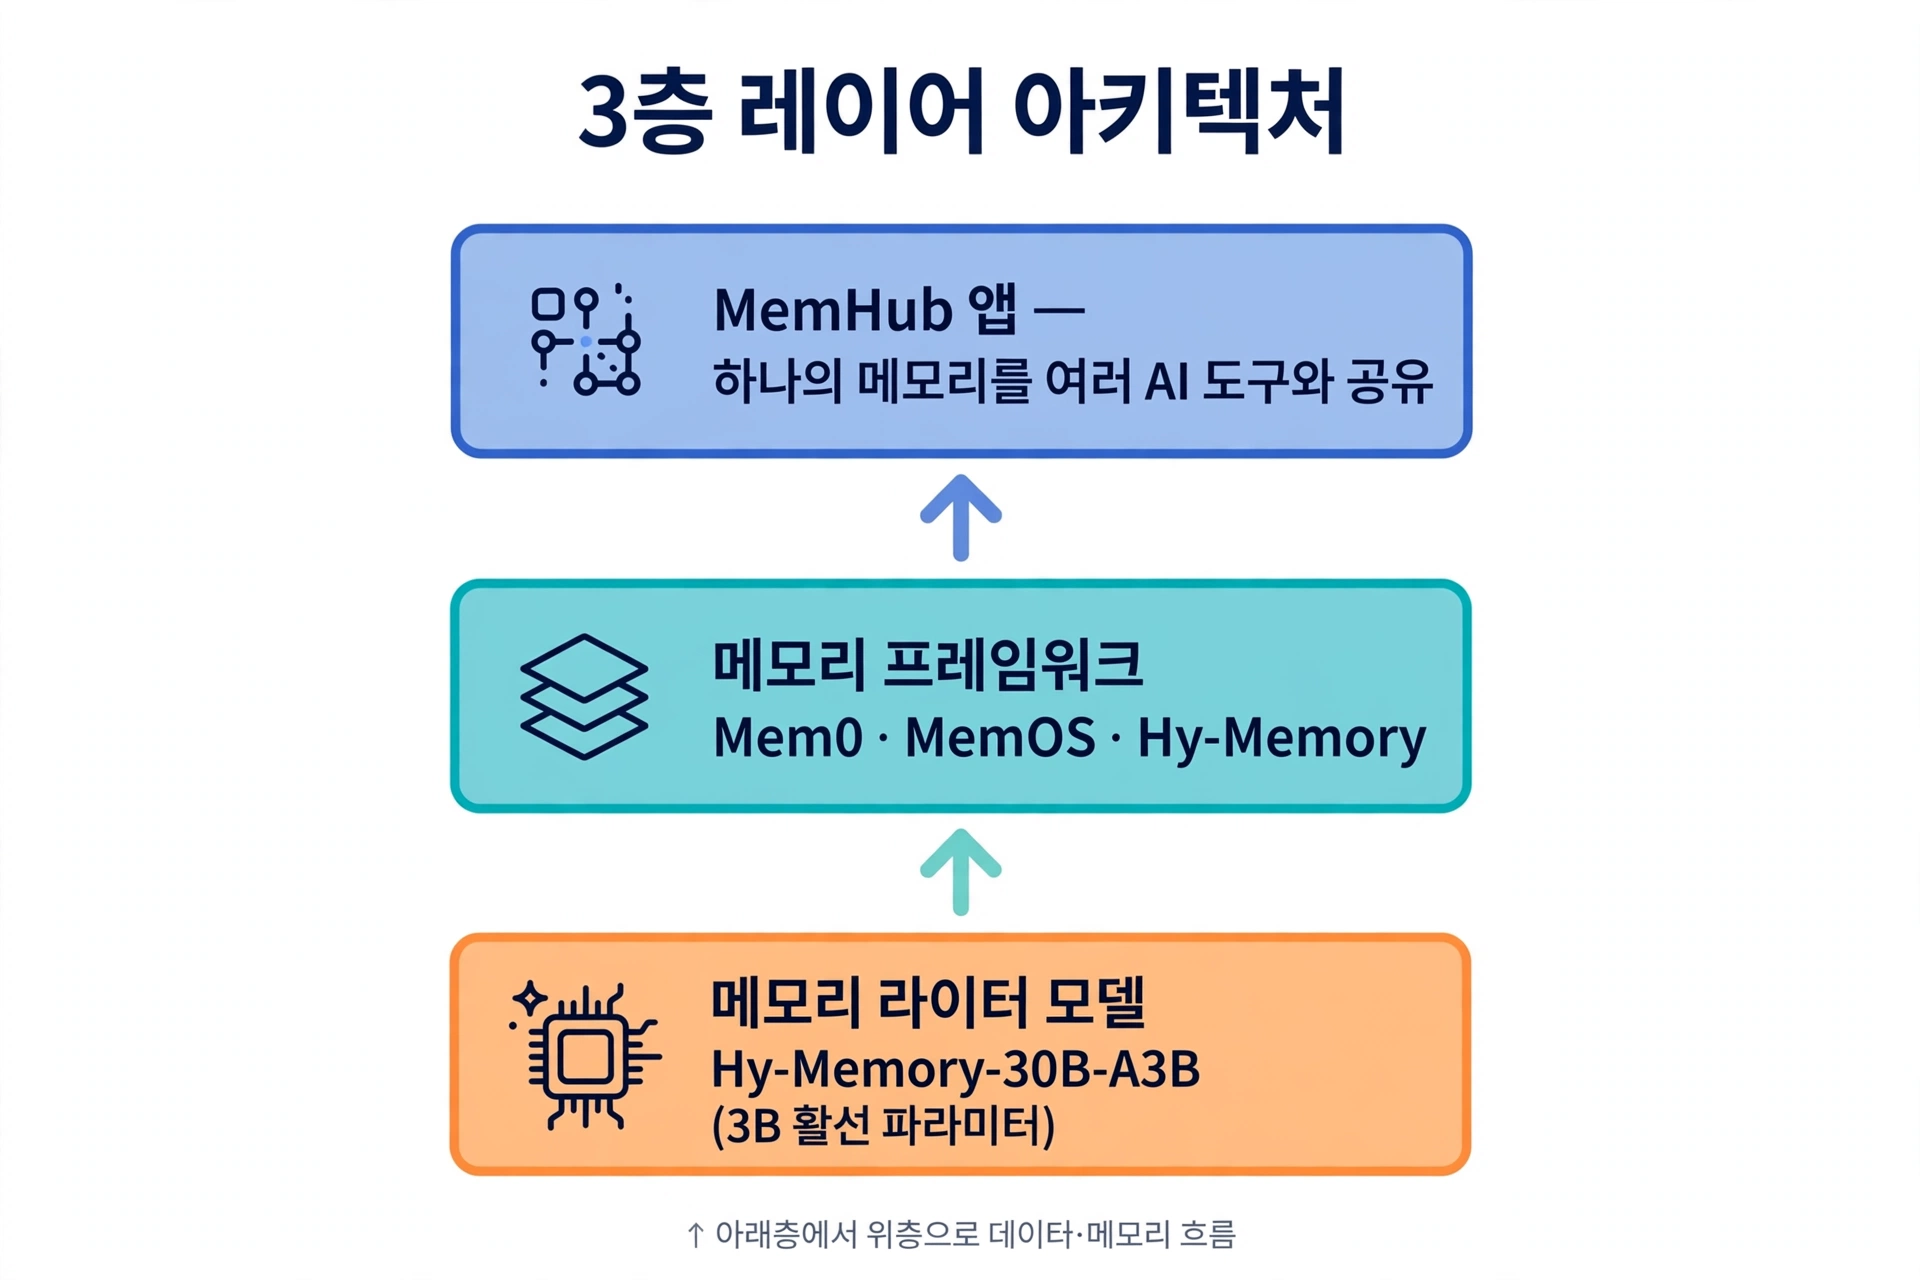
기존 에이전트 메모리 시장은 Mem0·MemOS 같은 프레임워크가 있었지만, "무엇을 기억할지 결정하는" 쓰기 경로는 범용 LLM + 프레임워크별 프롬프트로 처리해 왔다. 텐센트는 이 쓰기 경로 자체를 소형 특화 모델로 분리했다. 읽기(read)는 기존대로 범용 모델이 해도 되지만, 쓰기(write)는 매 대화 턴마다 수없이 호출되는 고빈도 작업이라 비용 민감도가 높다. 이 한 경로만 3B급 모델로 오프로드할 수 있다면 메모리 비용이 크게 낮아지고, 온디바이스·제약 환경 에이전트에도 적용 여지가 생긴다.
벤치마크: 55.49 vs Opus 5 54.62
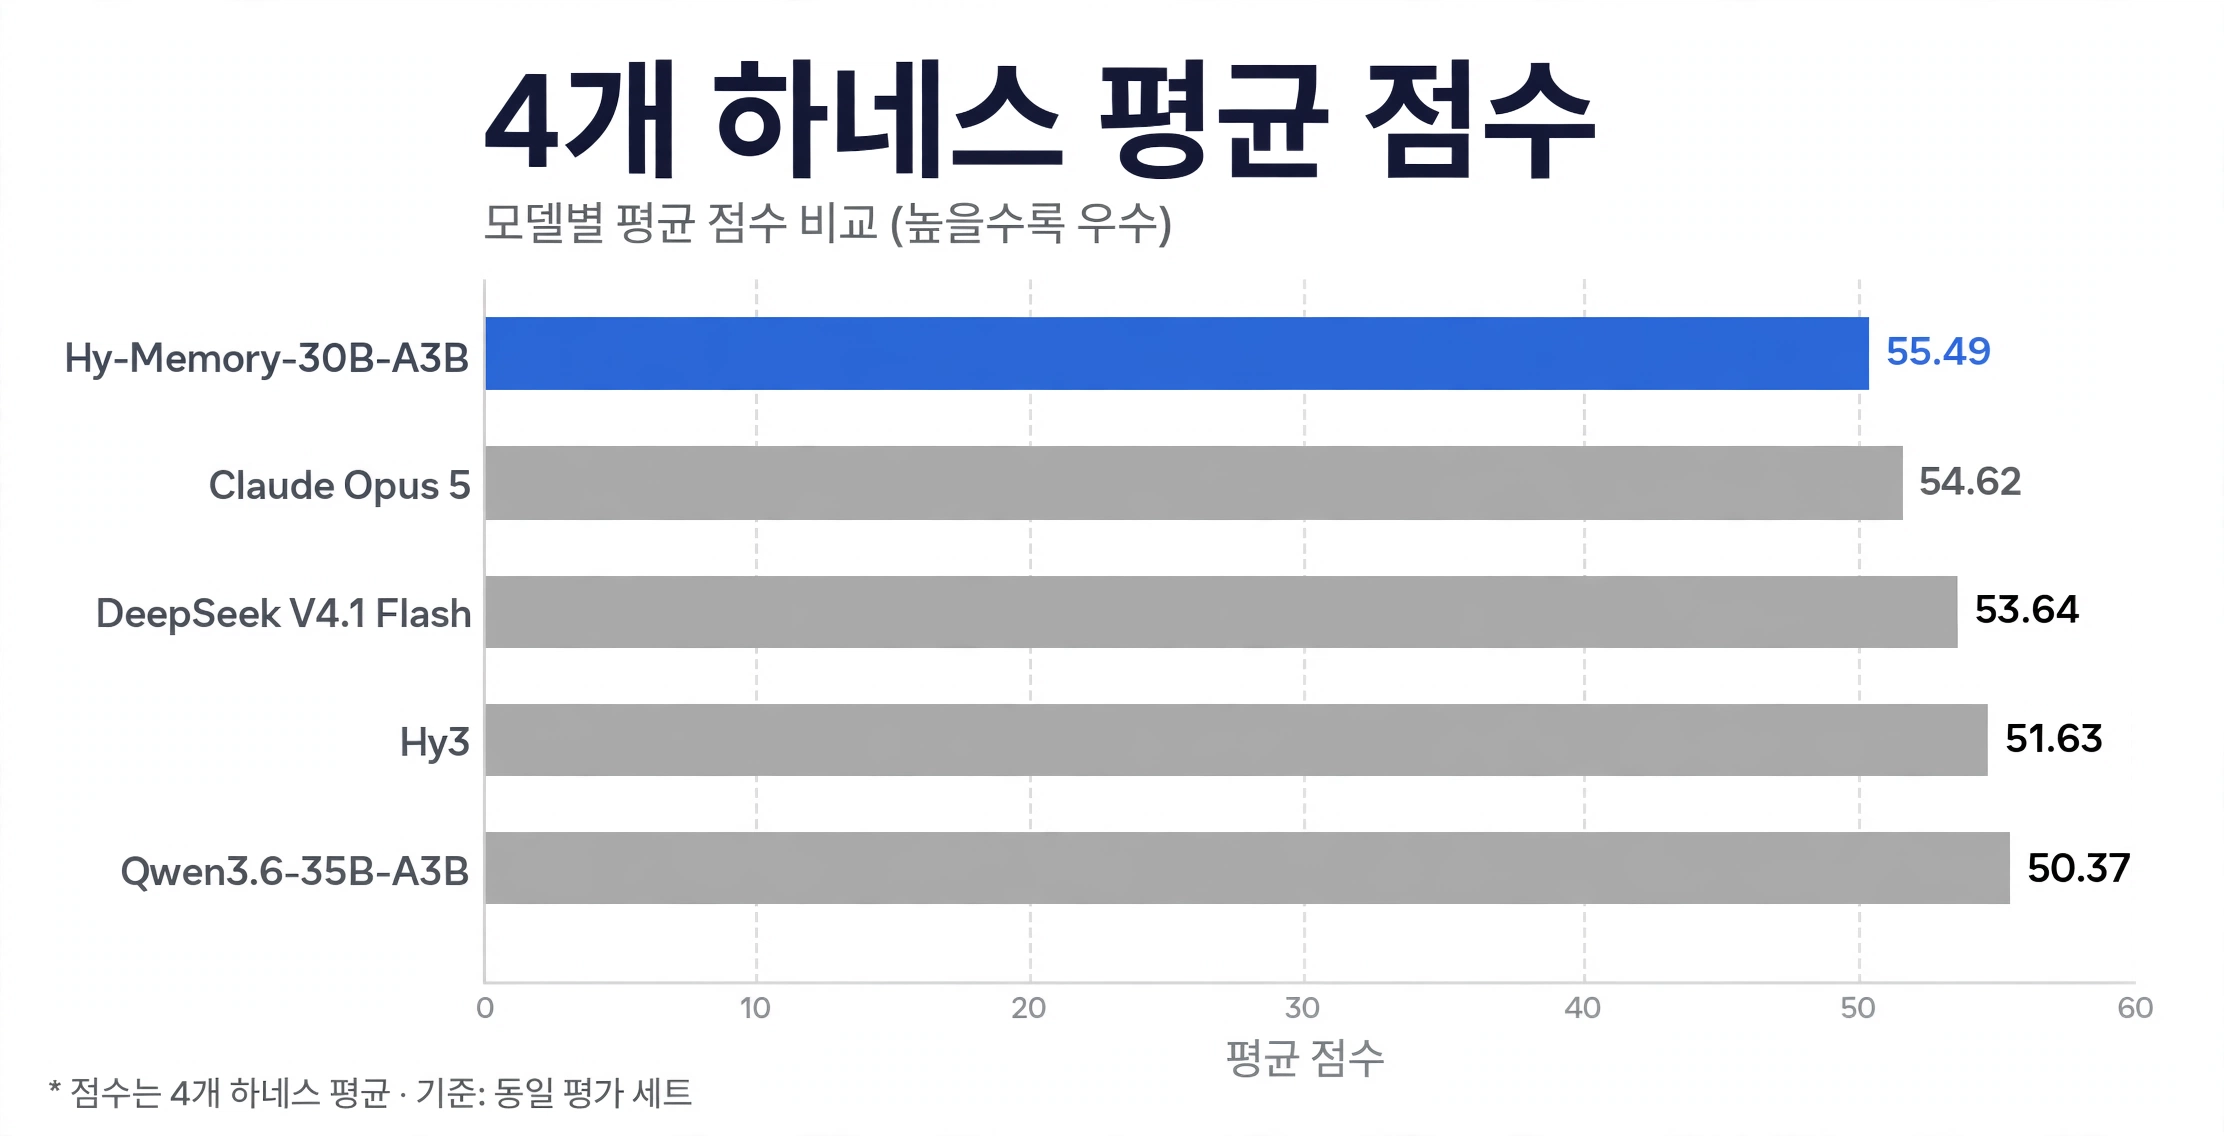
텐센트가 제시한 벤치마크(4개 하네스 평균):
| 모델 | 평균 |
|---|---|
| Hy-Memory-30B-A3B | 55.49 |
| Claude Opus 5 | 54.62 |
| DeepSeek V4.1 Flash | 53.64 |
| Hy3 | 51.63 |
| Qwen3.6-35B-A3B | 50.37 |
하네스별로는 Mem0 54.02 / Hy-Memory 60.55 / MemOS 50.51 / EverMemOS 56.89다. 평가 지표는 LoCoMo Judge·LongMemEval(LME)·PersonaMem-v2(PM-v2)·Travel SPS·Shopping PS·Code Memory Bench(CMB) 6종을 하네스별 균등 가중 평균한 것이며, 계산 효율을 위해 각 벤치마크의 20% 고정 서브샘플로만 평가했다. dev.to 실측 리뷰는 "a 30B memory model and MemHub"로 요약했고, alextech는 "vLLM으로 OpenAI 호환 API 배포 가능"을 전했다.
주의 (미확인): 벤치마크는 전량 텐센트 자체 측정(Tencent data)이며 20% 서브샘플 평가라 독립 검증이 없다. arXiv 테크리포트 2610.22196의 세부 내용·제출일도 모델 카드 태그 표기만 확인했고 원문 검증은 못 했다. 수치를 받아들이기 전에 LongMemEval 같은 표준 벤치마크를 직접 돌려보는 게 순서다.
개발자가 바로 써볼 수 있는 실무 포인트
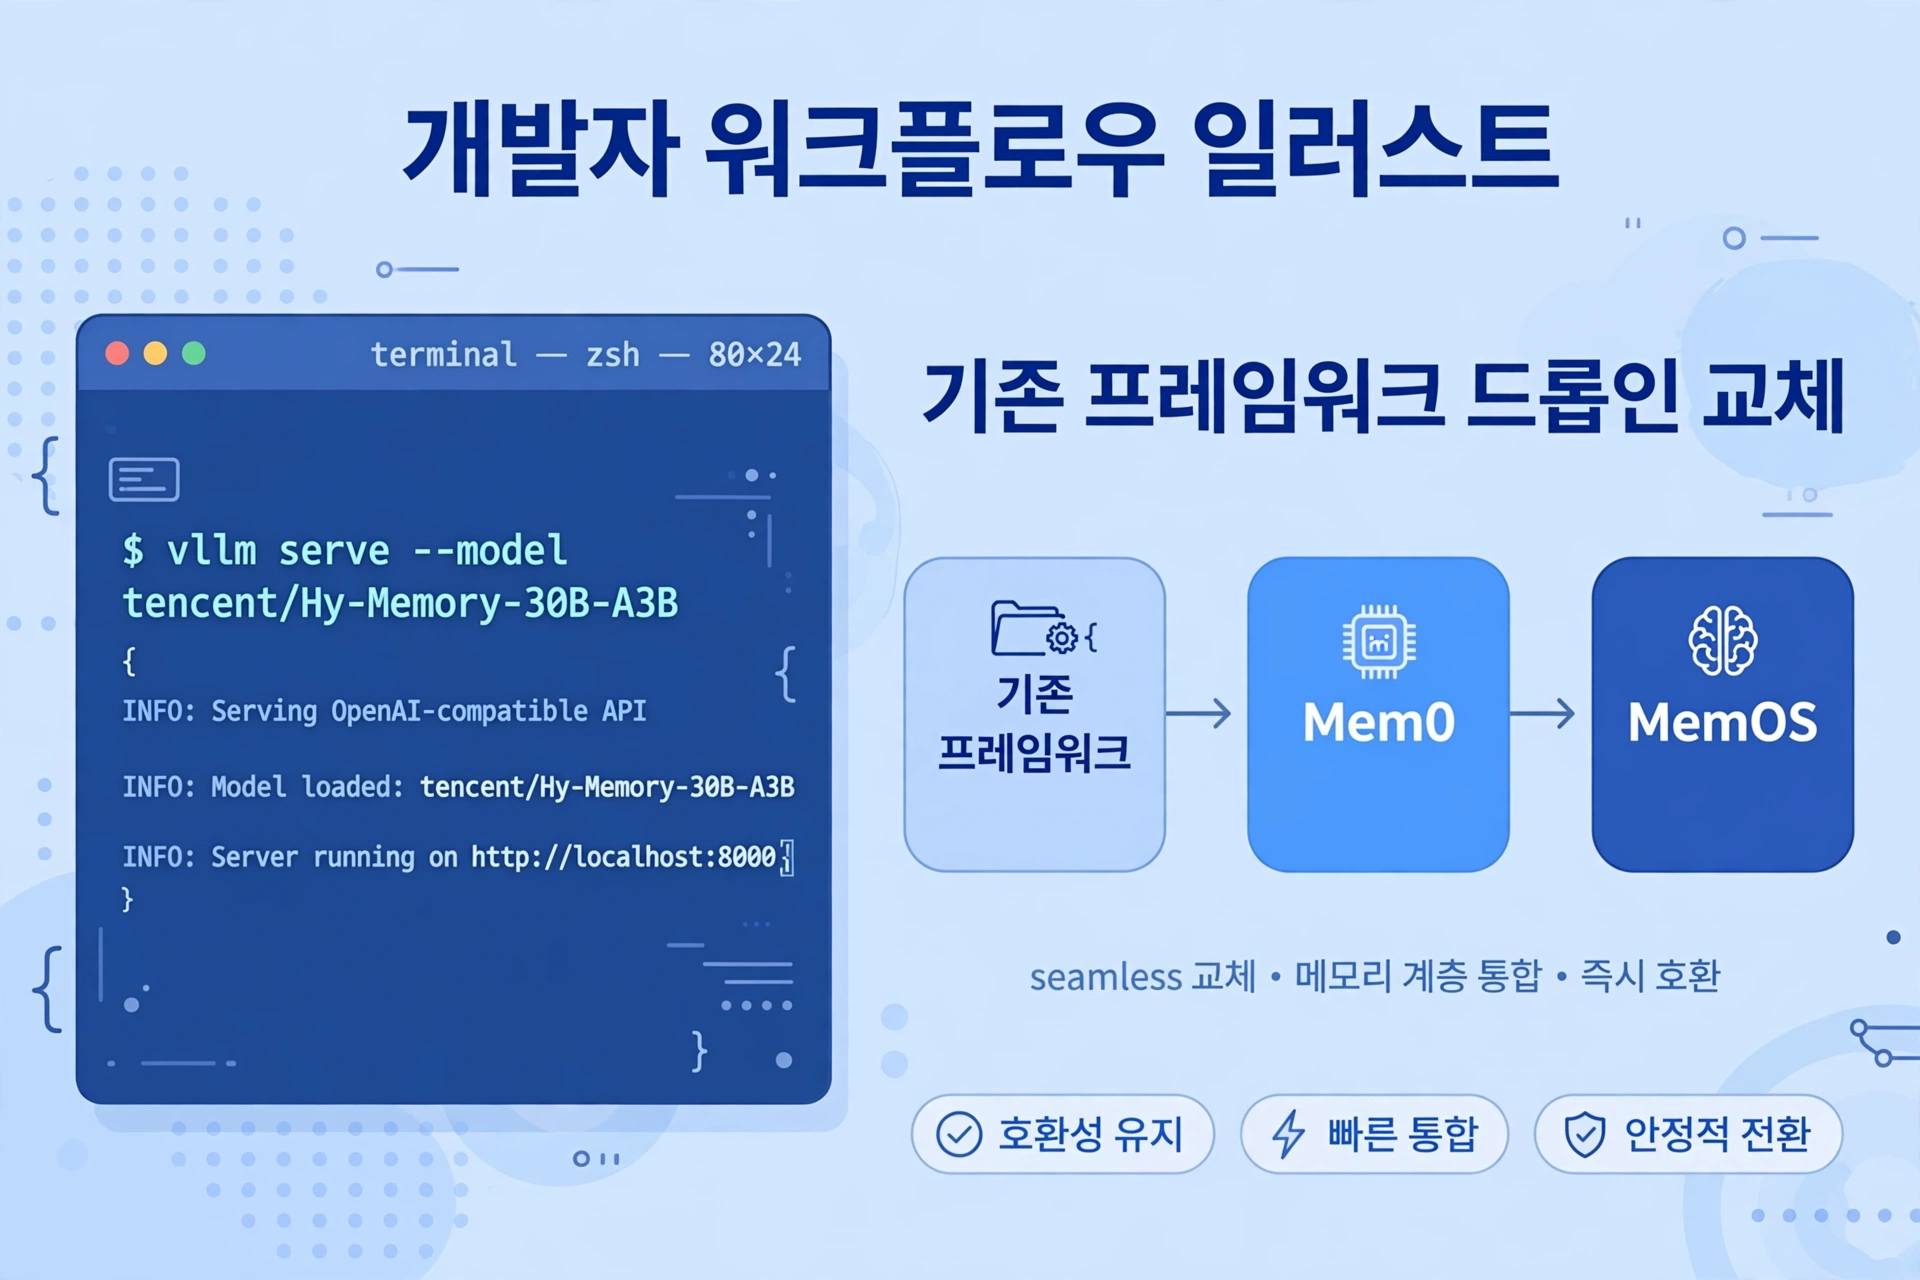
도입 장벽이 낮은 이유 두 가지: Apache 2.0 라이선스로 상용 도입에 제약이 없고, Mem0·MemOS의 드롭인 교체를 표방한다. vLLM으로 OpenAI 호환 API로 띄울 수 있으니 기존 스택에서 바로 실험해 볼 수 있다:
# Hy-Memory-30B-A3B를 vLLM으로 서빙 (OpenAI 호환 API)
vllm serve tencent/Hy-Memory-30B-A3B --port 8000

# 기존 Mem0/MemOS 설정에서 llm을 이 엔드포인트로 교체
# → 메모리 쓰기(write) 경로만 3B 특화 모델로 오프로드
memory_writer = LLM(
    model="tencent/Hy-Memory-30B-A3B",
    base_url="http://localhost:8000/v1",   # OpenAI 호환 엔드포인트
)
AX TF 관점: 장시간 동작하는 에이전트에서 메모리는 컨텍스트 윈도우 한계를 푸는 핵심 인프라다. 쓰기 경로를 3B급 특화 모델로 대체할 수 있다면 메모리 비용이 크게 낮아지고, 온디바이스·제약 환경 에이전트에도 적용 여지가 생긴다. 다만 수치는 벤더 자체 측정인 만큼 독립 재현 전까지는 "주장"으로 다뤄야 한다.
관련 이슈
- #2528 — 텐센트, 295B MoE 오픈소스 모델 'Hy3' 공식 출시
- #2531 — Tencent Hy3: 295B MoE 오픈소스 모델, Apache 2.0 라이선스
- #3158 — supermemoryai 'supermemory' — AI 메모리·컨텍스트 엔진, LongMemEval 1위·완전 로컬 실행