pplx-embed-v2-late: 0.6B·9B 다국어 멀티모달 late-interaction 임베딩
핵심 — 작은 모델이 검색 SOTA를 가져간다
- 검색과 RAG에서 임베딩은 크기 대 지연의 트레이드오프가 핵심이었다 (이슈 배경). 정확도를 올리려면 큰 모델을 써야 하고, 큰 모델은 느리다.
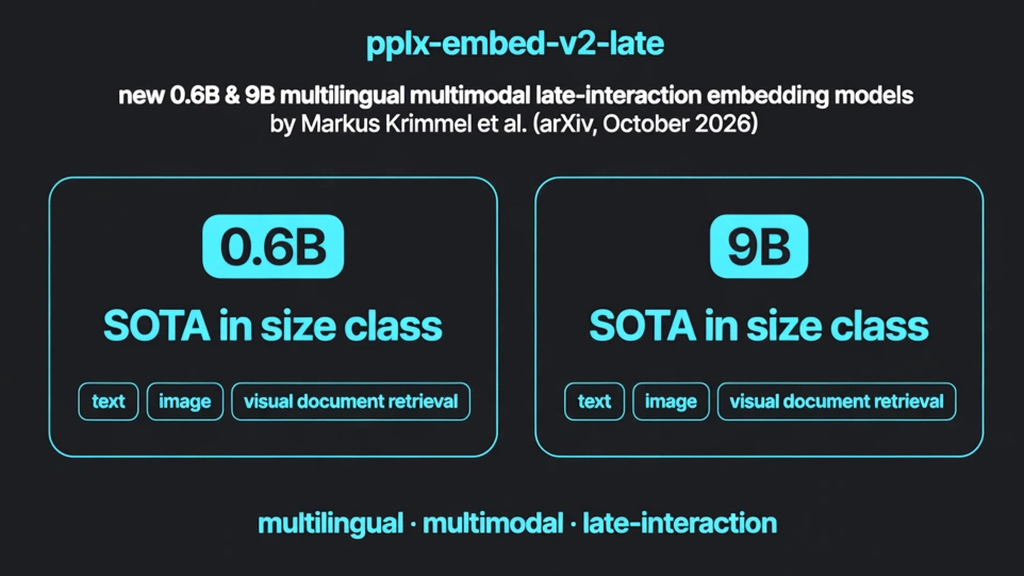
- pplx-embed-v2-late는 0.6B와 9B의 multilingual·multimodal late-interaction 모델 쌍이다 (arXiv).
- 두 모델 모두 각 size class 안에서 text, image, visual document retrieval 벤치마크 전반에 걸쳐 state-of-the-art다 (arXiv).
- late-interaction은 정확도가 높지만 무겁다는 인식이 있었는데, 0.6B가 몇 배 큰 모델과 경쟁한다는 결과가 나왔다 (이슈 배경). 트레이드오프의 한쪽 축이 흔들린 셈이다.
방법 — 18B teacher의 표현을 증류해 같은 공간에 넣는다
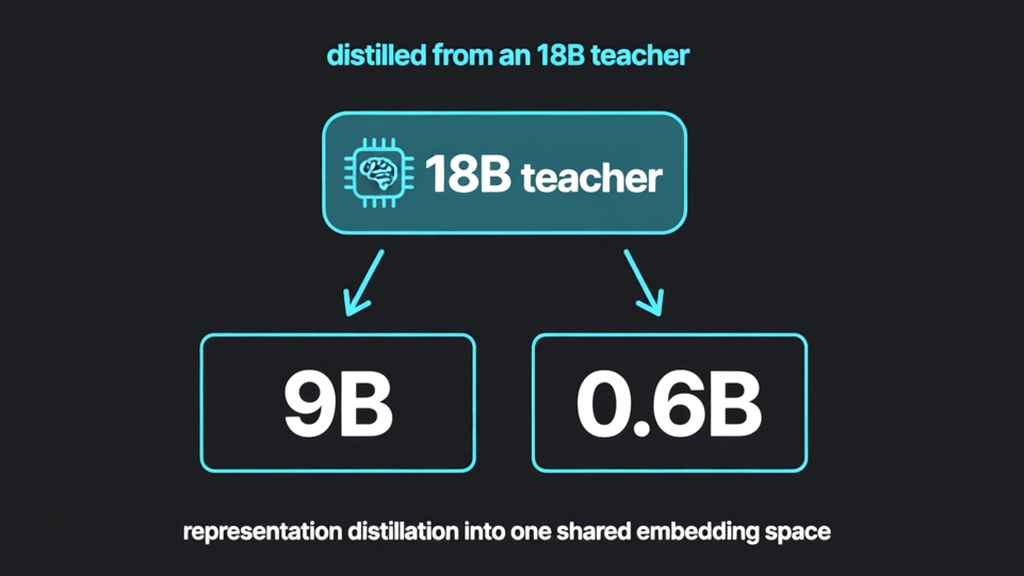
- 18B teacher로부터 representation distillation로 학습했다 (arXiv). 큰 teacher의 표현을 작은 학생 모델이 그대로 배우는 방식이다.
- 두 모델은 같은 embedding space를 공유한다 (arXiv). 0.6B와 9B가 서로 다른 공간의 벡터를 만들지 않으니, 한 쌍으로 움직일 수 있다.
- 이 공유 공간 구조가 asymmetric deployment(비대칭 배포)를 지원한다 (arXiv). 인덱싱과 쿼리에 다른 크기의 모델을 쓸 수 있다.
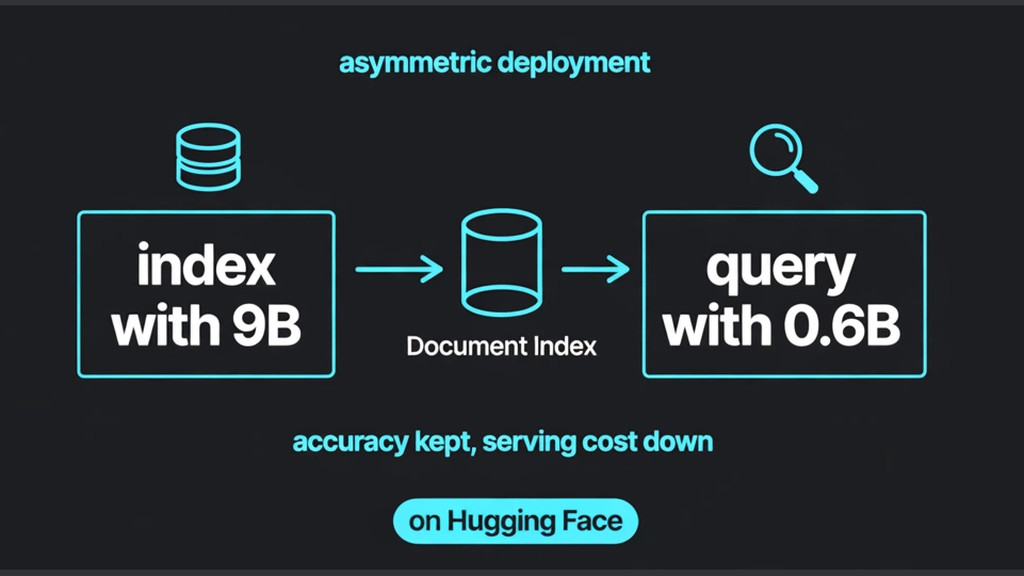
- 문서는 9B로 인덱싱하고, 쿼리는 저지연 0.6B로 처리한다 (arXiv). 정확도가 필요한 작업은 큰 모델에, 속도가 필요한 작업은 작은 모델에 맡긴다.
수치 — visual document retrieval에서 0.6B가 몇 배 큰 모델과 경쟁한다
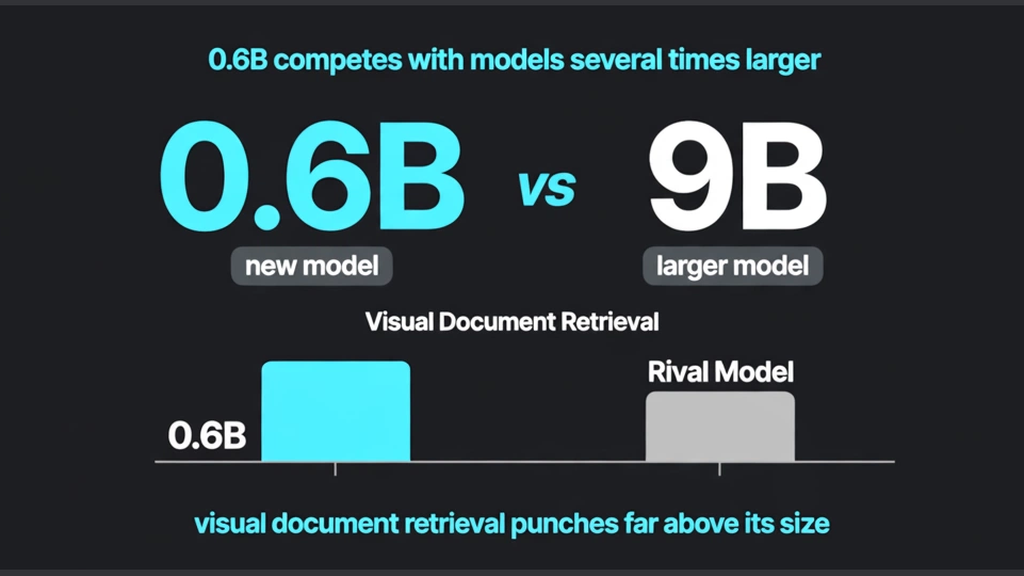
- visual document retrieval에서 0.6B 모델은 자신보다 몇 배 큰 모델과 경쟁력 있다 (arXiv). 이 벤치마크는 PDF·슬라이드 같은 시각 문서 검색이다.
- text·image 벤치마크에서도 두 모델은 각 size class 안에서 SOTA를 기록했다 (arXiv). 한 영역에 치우치지 않았다.
- 두 모델 모두 Hugging Face에서 공개되어 있다 (arXiv). 바로 내려받아 실험할 수 있다.
의미 — 인덱싱과 쿼리를 분리하는 비대칭 배포가 실용적이다
- 인덱싱은 한 번만 하면 되고, 쿼리는 계속 돈다. 9B로 인덱싱하고 0.6B로 쿼리하면 정확도는 유지하면서 서빙 비용을 낮출 수 있다 (이슈 배경). 이 구조가 설계의 핵심 실용성이다.
- visual document retrieval 강세는 PDF와 슬라이드 검색에도 응용할 만하다 (이슈 배경). RAG 소스가 문서 이미지인 경우에 특히 맞는다.
- 패턴은 간단하다 — 개념 예시:
# 인덱싱은 1회, 정확도 우선
index  = embed(documents, model="9B")
# 쿼리는 지속, 저지연 우선
answer = search(index, embed(query, model="0.6B"))
# 두 모델은 같은 임베딩 공간을 공유한다 (arXiv)
AX TF 관점. RAG 파이프라인에서 임베딩 교체는 모델명 하나 바꾸는 실험이라 A/B가 가장 쉬운 튜닝 축이다. 9B 인덱싱·0.6B 쿼리 조합을 현행 파이프라인에 바로 꽂아 지연·비용·품질을 실측해볼 수 있다 (이슈 배경).
아직 안 밝혀진 것 — 쿼리 지연 수치·한국어 포함 여부·라이선스
⚠️ 미확인: late-interaction 특성상 쿼리 시점 연산량이 bi-encoder보다 클 수 있는데, 지연 수치는 초록에 없다 (arXiv). 다국어 범위에 한국어가 포함되는지 미확인이다 (arXiv). 라이선스 조건은 초록에 언급이 없다 (arXiv).
원문 이슈
이 글은 ax-trend 이슈 #3448을 바탕으로 작성됐다. 핵심 링크: arXiv:2610.29523 — pplx-embed-v2-late (2026-10-21 제출).