카카오 Kanana-2-vision-encoder 2종 공개: 지연 60% 감소한 비전 인코더
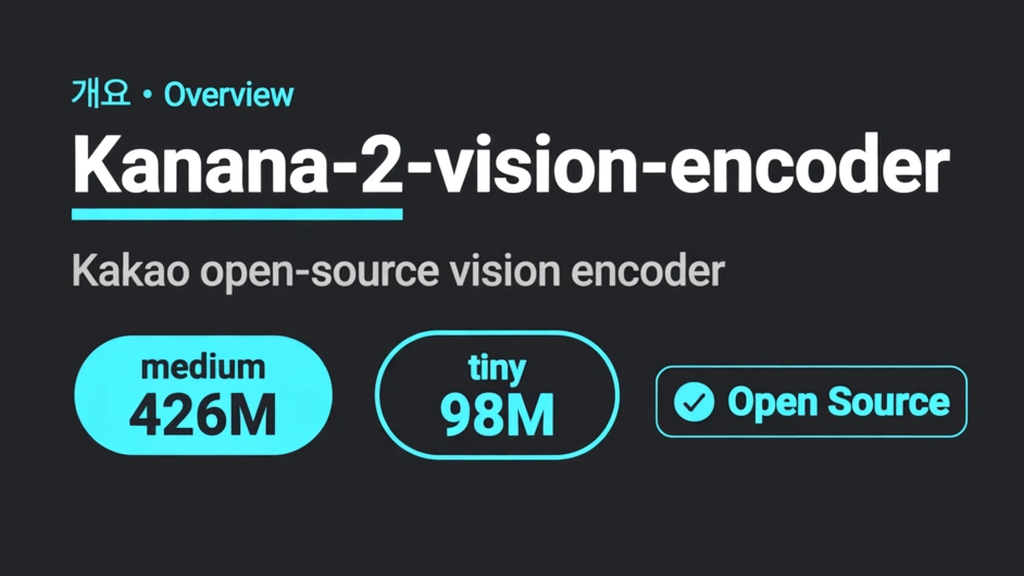
2026년 10월 21일, 카카오가 자체 개발 AI 비전 인코더 Kanana-2-vision-encoder 2종을 오픈소스로 공개했다. medium(4.26억 파라미터)과 tiny(9,800만 파라미터), 두 가지 크기로 나왔다 (뉴스핌, 2026-10-21).
카카오는 성능을 기존 오픈 비전 모델인 SigLIP 2·Perception Encoder·AIMv2·Qwen3.5-ViT와 비교해 향상됐다고 주장한다. 라이선스는 Kanana Open License다.
아키텍처: 오픈 학습 패러다임
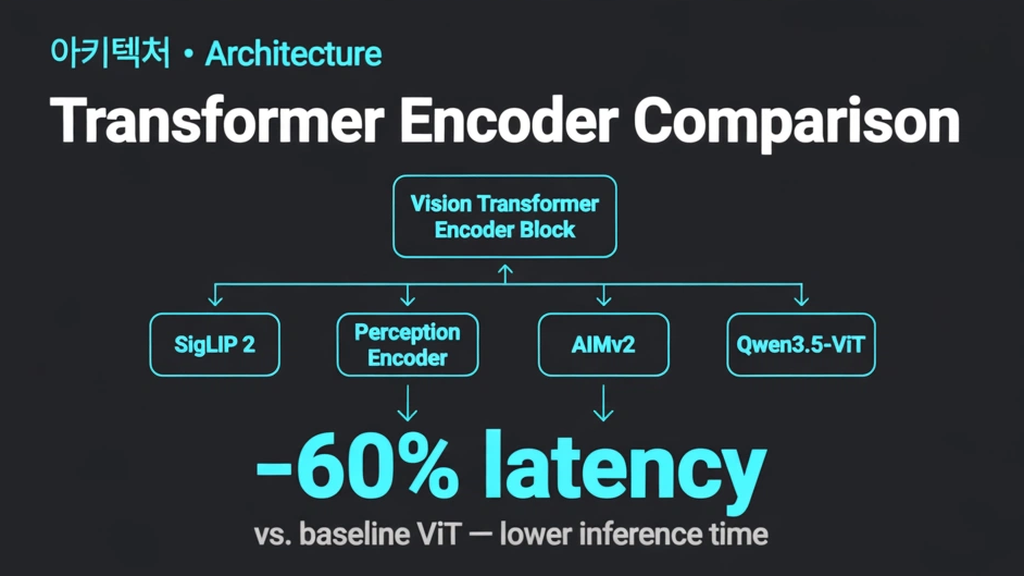
카카오는 오픈 학습 패러다임 기반 아키텍처라고 설명했다. 구체적인 구조 상세는 공개 자료에 자세히 나와 있지 않다. 비교 대상에 SigLIP 2·Perception Encoder·AIMv2·Qwen3.5-ViT를 직접 올린 건, 멀티모달 스택의 비전 쪽 표준 인코더들과 붙어서 평가받겠다는 뜻이다.
비전 인코더는 멀티모달 모델의 "눈"이다. 이미지·영상을 이해해 언어 모델에 넘기는 역할을 맡는다. 인코더를 바꾸면 멀티모달 모델 전체의 속도와 품질이 바뀐다. 그래서 카카오는 지연 감소를 앞세운 것으로 보인다.
숫자로 읽는 카나나 비전 인코더
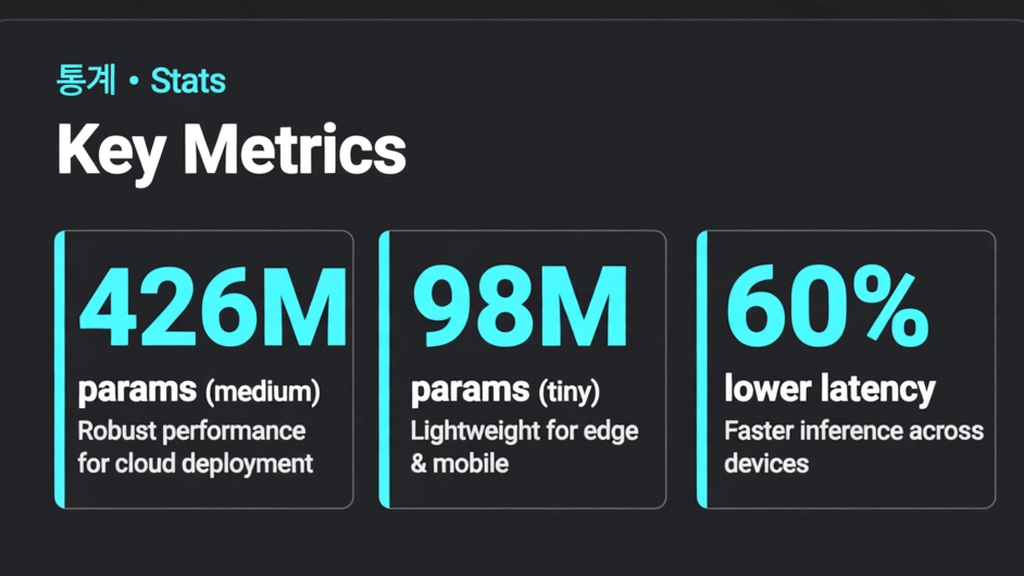
| 항목 | 값 |
|---|---|
| medium | 4.26억 파라미터 |
| tiny | 9,800만 파라미터 |
| 지연 | 60% 감소 주장 (카카오 발표 기준) |
| 라이선스 | Kanana Open License |
| 비교 대상 | SigLIP 2·Perception Encoder·AIMv2·Qwen3.5-ViT |
tiny 9,800만이 눈에 띈다. 모바일·엣지에서 돌릴 수 있는 무게다. 기존 오픈 비전 인코더 중에서도 이 정도 크기에 오픈소스인 선택지는 많지 않다. 지연 60% 감소 주장이 맞다면, 온디바이스 비전 파이프라인에서 바로 체감할 수 있는 차이다.
온디바이스 적용 포인트
Android 개발자 관점에서 tiny 모델의 쓰임새는 분명하다. 온디바이스 비전 파이프라인의 개념 구조는 이렇다.
// 개념 코드: 온디바이스 비전 인코더 파이프라인
val encoder = VisionEncoder.load("kanana-2-tiny")  // tiny 9,800만

fun onFrame(frame: Bitmap) {
    val embedding = encoder.encode(frame)  // 지연 60%↓ 주장
    val result = localModel.query(embedding)
    if (result.confidence < threshold) {
        cloudModel.query(frame)            // fallback
    }
}
이 구조의 포인트는 두 가지다. 첫째, 지연 감소는 클라우드 왕복을 피하는 것보다 파이프라인 내부에서 이득이다. 카메라 프레임을 실시간으로 처리하는 앱에서는 인코더 1회 호출 시간이 전체 체감 속도를 정한다. 둘째, tiny급 오픈 인코더가 생기면 앱 번들에 넣는 선택지가 열린다. 기존에는 이 무게대의 오픈 비전 인코더가 드물어서 선택지가 좁았다.
배경: 카카오의 멀티모달 스택 확장
이번 공개는 갑작스럽지 않다. 카카오는 10월 중순 ifkakao 26에서 AI 에이전트 전략과 카나나 스페이스·칸바스를 공개했고(ax-trend #3232), 8월 COLM 2026에서는 학습 경량화 기술도 발표했다(ax-trend #3126). 자체 모델을 공개하며 생태계 참여를 유도하는 흐름이다.
연내 정식 출시를 예고한 '모두의 AI'(ax-trend #3246)와도 연결된다. 비전 인코더 공개는 카나나 모델 패밀리를 채우는 조각이다.
왜 중요한지
한국에서 만든 오픈소스 비전 인코더가 나왔다는 점 자체가 의미 있다. 멀티모달 모델을 만드는 팀은 "눈"을 직접 고를 수 있게 됐다. 특히 tiny 9,800만은 모바일·엣지에서 쓸 수 있는 무게라, 온디바이스 vision pipeline의 선택지가 하나 늘었다.
다만 성능 주장은 카카오 발표 기준이다. 가중치가 공개되는 대로 직접 돌려보고 숫자를 검증해야 한다. 그전까지는 "선택지가 늘었다" 정도로 받아들이는 게 맞다.
원문 이슈
이 글은 ax-trend 이슈 #3375를 바탕으로 작성됐다. 핵심 링크: 뉴스핌 — 카카오, Kanana-2-vision-encoder 2종 공개 (2026-10-21). 관련 이슈: #3232 — ifkakao 26 AI 에이전트 전략, #3126 — 카나나 학습 최적화·경량화, #3246 — '모두의 AI' 연내 정식 출시.