Baidu Unlimited OCR 2: 수백 페이지 문서를 한 번에 읽는 오픈 OCR, 단계별 비용 고정
수백 페이지 문서를 한 번의 호출로 파싱합니다
Baidu는 2026년 10월 27일 Unlimited OCR 2를 공개했습니다. 같은 날 초장문 문서 파싱 벤치마크 MarathonDocBench도 함께 공개했습니다. 코드와 가중치는 GitHub과 Hugging Face에서 baidu/Unlimited-OCR-2로 제공되며, 라이선스는 MIT입니다. Baidu Cloud와 ModelScope에서도 이용할 수 있다고 공개 기록에 적혀 있습니다.
긴 문서에서 진짜 문제는 어디에서 생깁니까. 페이지를 따로 읽고 뒤에서 이어 붙이면, 표가 페이지 경계를 넘을 때 맥락이 끊기기 쉽습니다. Baidu는 이 문제를 한 요청 안에서 처리하는 것으로 풀겠다고 내세웠습니다.
핵심은 페이지 수가 아니라 페이지 경계입니다. 경계를 넘는 표와 각주가 살아 있어야 긴 문서 파싱이 실무에서 쓸 만해집니다.
단계별 비용이 고정되는 이유: SR-SWA
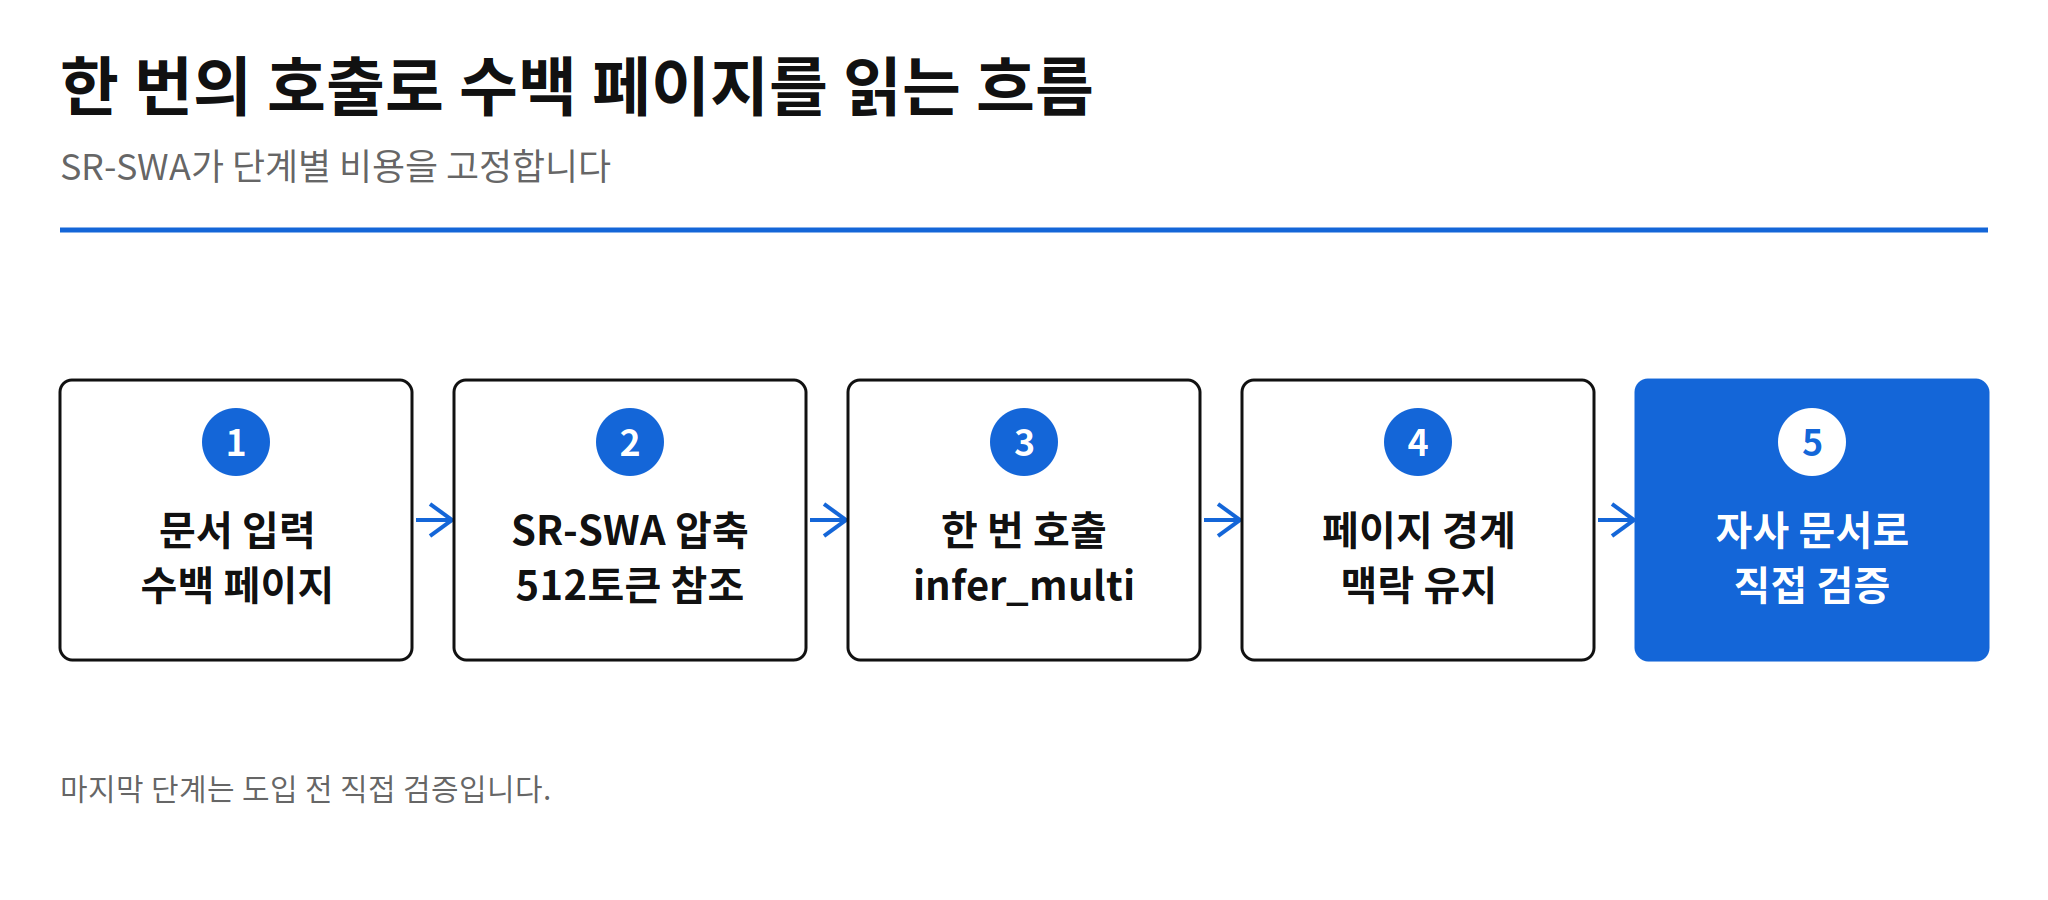
핵심 기술은 Sparse Reference Sliding Window Attention(SR-SWA)입니다. 초장문 시퀀스의 텍스트와 시각 어텐션을 고정된 크기의 작업 참조 집합으로 압축합니다. 예시로 든 크기는 512토큰입니다.
SR-SWA 덕분에 단계별 디코딩 지연과 메모리 사용량은 문서 길이에 관계없이 거의 일정하게 유지된다고 Baidu는 설명합니다. 문서가 길어져도 이차 어텐션 확장과 메모리 병목을 없앤다는 주장입니다. 다만 단계별 비용이 일정하다는 말과 전체 처리 시간까지 일정하다는 말은 다릅니다. 이 구분은 뒤에서 다시 짚겠습니다.
여러 페이지는 한 번에, 한 페이지는 타일링으로 읽습니다
여러 페이지는 infer_multi 호출 한 번으로 파싱합니다. 문서의 모든 페이지를 한 요청으로 처리해 페이지 경계를 넘는 맥락을 유지합니다. 기본 모드에서는 페이지마다 하나의 전역 뷰로 인코딩합니다.
- 단일 페이지는 기본적으로 동적 타일링(gundam 모드)으로 인코딩합니다.
- 빠른 테스트에는 Transformers를 권장합니다.
- 서빙에는 SGLang을 권장합니다.
첫 번째 Unlimited OCR은 2026년 6월에 나왔습니다. 당시에는 참조 슬라이딩 윈도우 어텐션으로 단일 페이지에서 수십 페이지 연속 파싱으로 범위를 넓혔습니다. 2버전은 그 방식을 SR-SWA로 바꿔 수백 페이지 규모까지 한 번에 처리하는 것을 목표로 합니다.
보도 기준 점수와 속도 주장
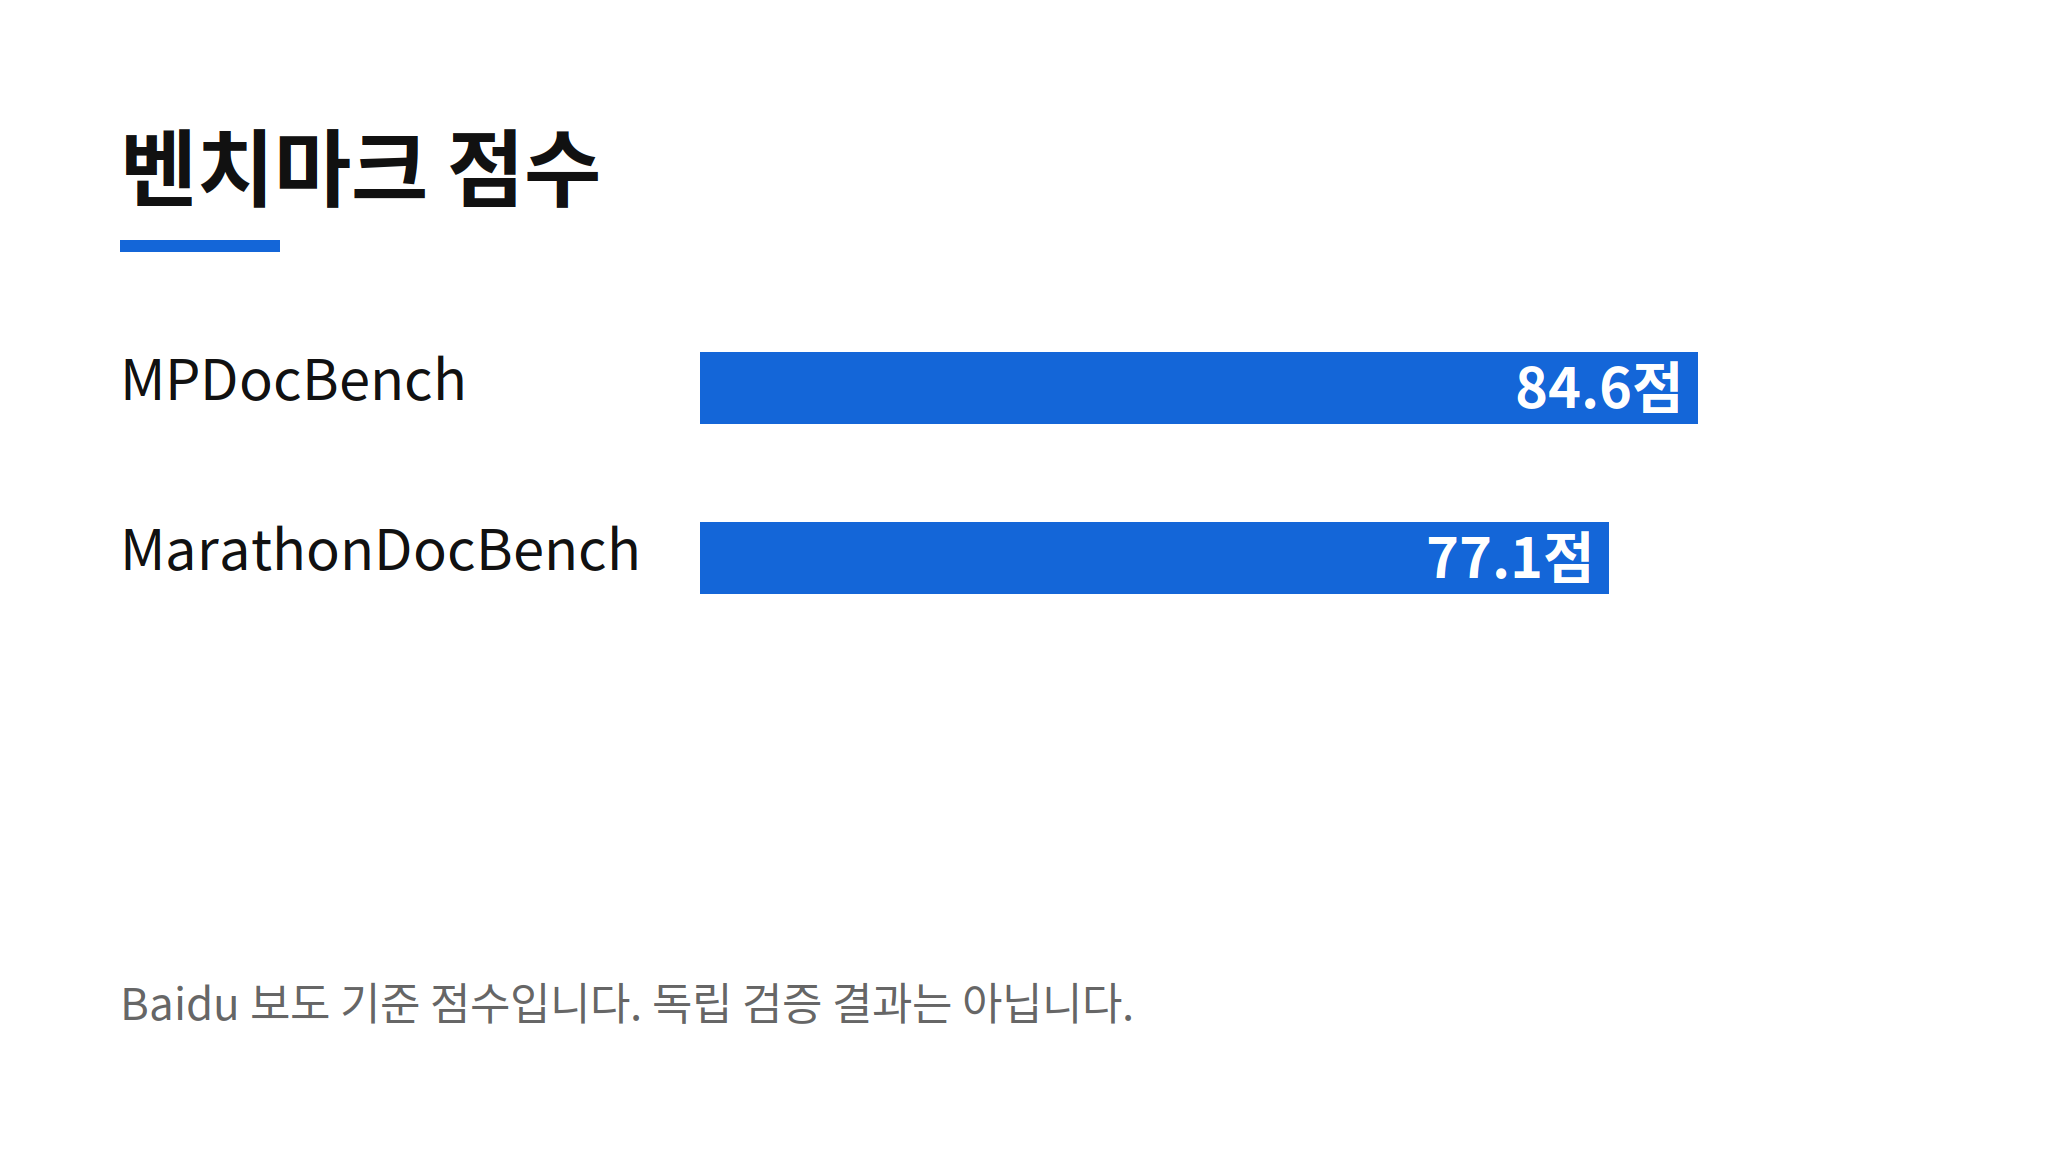
보도 기준 벤치마크 점수는 MPDocBench 84.6, MarathonDocBench 77.1입니다. 두 점수는 서로 다른 벤치마크에서 나온 수치이므로, 어느 쪽이 더 높다고 우열을 매길 수 없습니다.
| 비교 대상 | 100페이지 설정 속도 주장 |
|---|---|
| 전체 어텐션 | 7배 빠름 |
| 기존 R-SWA | 5.6배 빠름 |
100페이지 설정에서 단계별 디코딩 속도는 전체 어텐션보다 7배, 기존 R-SWA보다 5.6배 빠르다는 것이 Baidu의 주장입니다. Baidu 자체 시연에서는 해리포터 전집 7권, 3,600페이지가 넘는 분량을 한 번의 실행으로 파싱했다고 보도되었습니다. 이는 회사 시연 주장이며 독립 검증 결과는 아닙니다.
아직 확인되지 않은 점
MPDocBench와 MarathonDocBench 점수는 모두 회사 주장입니다. 보도 시점에 독립 평가는 공개되지 않았고, MarathonDocBench는 Baidu가 직접 만든 벤치마크이므로 SOTA 주장은 독립 검증이 필요합니다. 2버전의 파라미터 규모는 Hugging Face 본문에서 별도로 확인되지 않았습니다. 1버전 규모를 2버전에 그대로 적용할 근거는 없습니다. 한국어와 같은 비영어 문서에서의 정확도도 이번 공개 자료에서 따로 확인되지 않았습니다. Hugging Face 본문은 작은 페이지 윈도우가 페이지 경계를 넘는 블록의 맥락을 잃어 페이지 간 병합 품질을 떨어뜨릴 수 있다고 경고합니다.
실무 판단: 자사 문서로 먼저 확인합니다
실무 판단은 이렇게 정리됩니다. 계약서, 논문, 스캔 아카이브처럼 수백 페이지 문서를 다루는 팀에는 바로 시험해 볼 만한 오픈 모델입니다. MIT 라이선스에 Transformers와 SGLang 실행 경로가 함께 제공돼 문서 파싱 파이프라인에 넣어 시험하기 쉽습니다. 도입 전에는 자사 문서로 페이지 경계 표와 각주를 직접 확인하는 과정이 먼저 와야 합니다. 벤치마크 점수가 아니라 자사 문서에서의 경계 처리 결과가 도입 결정의 근거가 됩니다.