Weight-Space Programming — 가중치 0.016%로 수학 성능 6배 개선
MIT CSAIL 연구진(Rikiya Takehi, Jayden Teoh, Alex Zhang, Omar Khattab)이 Weight-Space Programming이라는 개념과 초기 실험 결과를 연구 블로그에 공개했습니다. 범용 프론티어 LLM이 옵티마이저나 그래디언트 없이 신경망 가중치를 직접 읽고 쓰는 방식입니다.
지금까지 LLM은 프롬프트와 코드 같은 텍스트 산출물을 다뤄 왔고, 가중치 자체는 Adam이나 Muon 같은 옵티마이저의 영역으로 여겨졌습니다. 이번 결과는 추론으로 가중치를 읽고 고치는 방식이 작은 네트워크를 넘어 0.8B 언어모델까지 닿았다는 초기 증거입니다.
가중치는 지금까지 LLM이 직접 다룰 수 없는 영역으로 여겨졌습니다.
가중치만 보고 맞힌 네트워크 식별 결과
실험 모델은 블로그에서 GPT-6 Astra로 표기됩니다. 이 모델은 가중치 17,253개의 MLP 원시 가중치만 보고 PPO로 학습된 게임을 확인했습니다.
- Breakout·Pong·Pac-Man·Freeway 4개 전부를 맞혔습니다.
- 중간층만 남은 문자 단위 언어모델 3개에서는 학습 언어와 복사 헤드(induction head)를 전부 식별했습니다.
- Kinetix 자동차 과제에서는 실패 원인을 설명한 뒤 가중치 3.5%를 한 번에 고쳐 성공률을 0%에서 1,024 에피소드 전부 성공으로 바꿨습니다.
MinAtar 3개 게임에서는 가중치를 처음부터 새로 써서 PPO 1억 스텝 학습 네트워크를 모두 이겼습니다. Breakout 점수는 517.4점으로, 5억 스텝 PPO의 25.3점보다 약 20배 높게 기록됐습니다.
Qwen3.5-0.8B 수정 과정
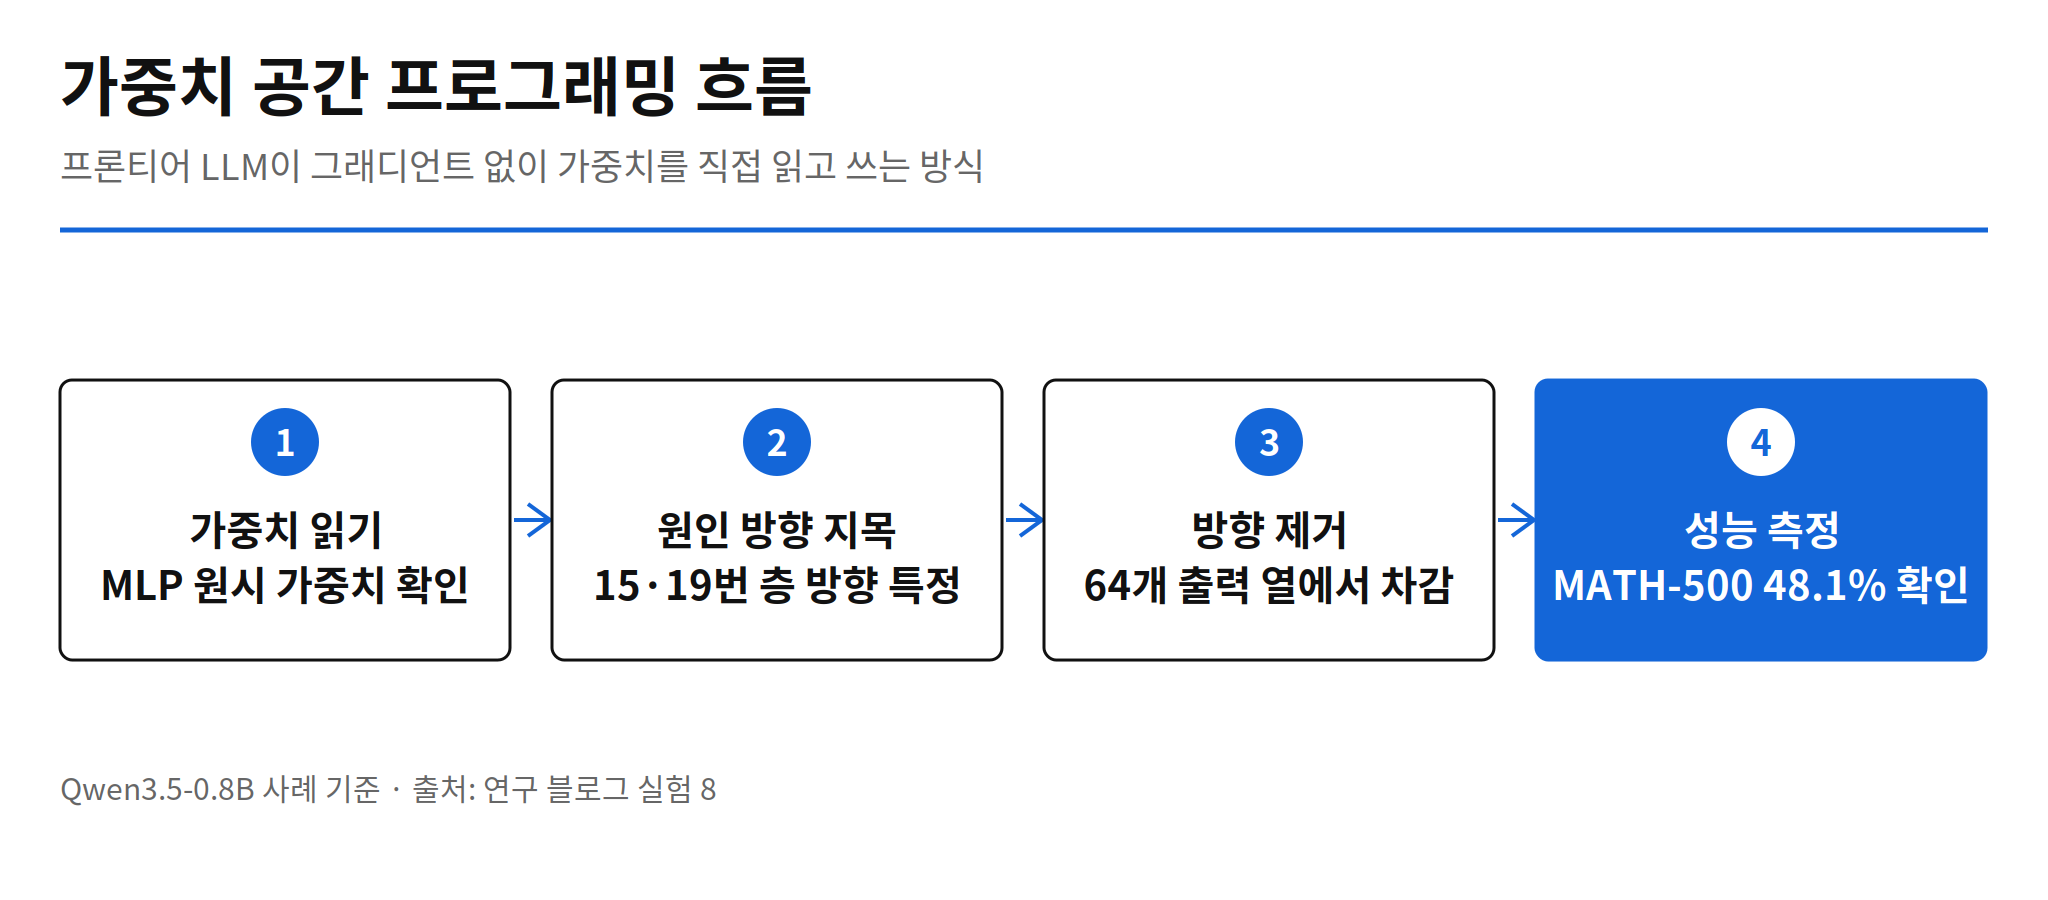
수학 성능 개선에서는 반복 루프의 원인이 먼저 지목됐습니다. 연구진은 15번·19번 층 MLP가 쓰는 한 방향을 원인으로 특정했습니다.
수정 방식은 그 방향을 빼는 형태로 이뤄졌습니다. 64개 출력 열에서 해당 방향을 제거해 전체 가중치의 0.016%(131,072개)만 바꿨습니다.
수정 전후 성능 수치
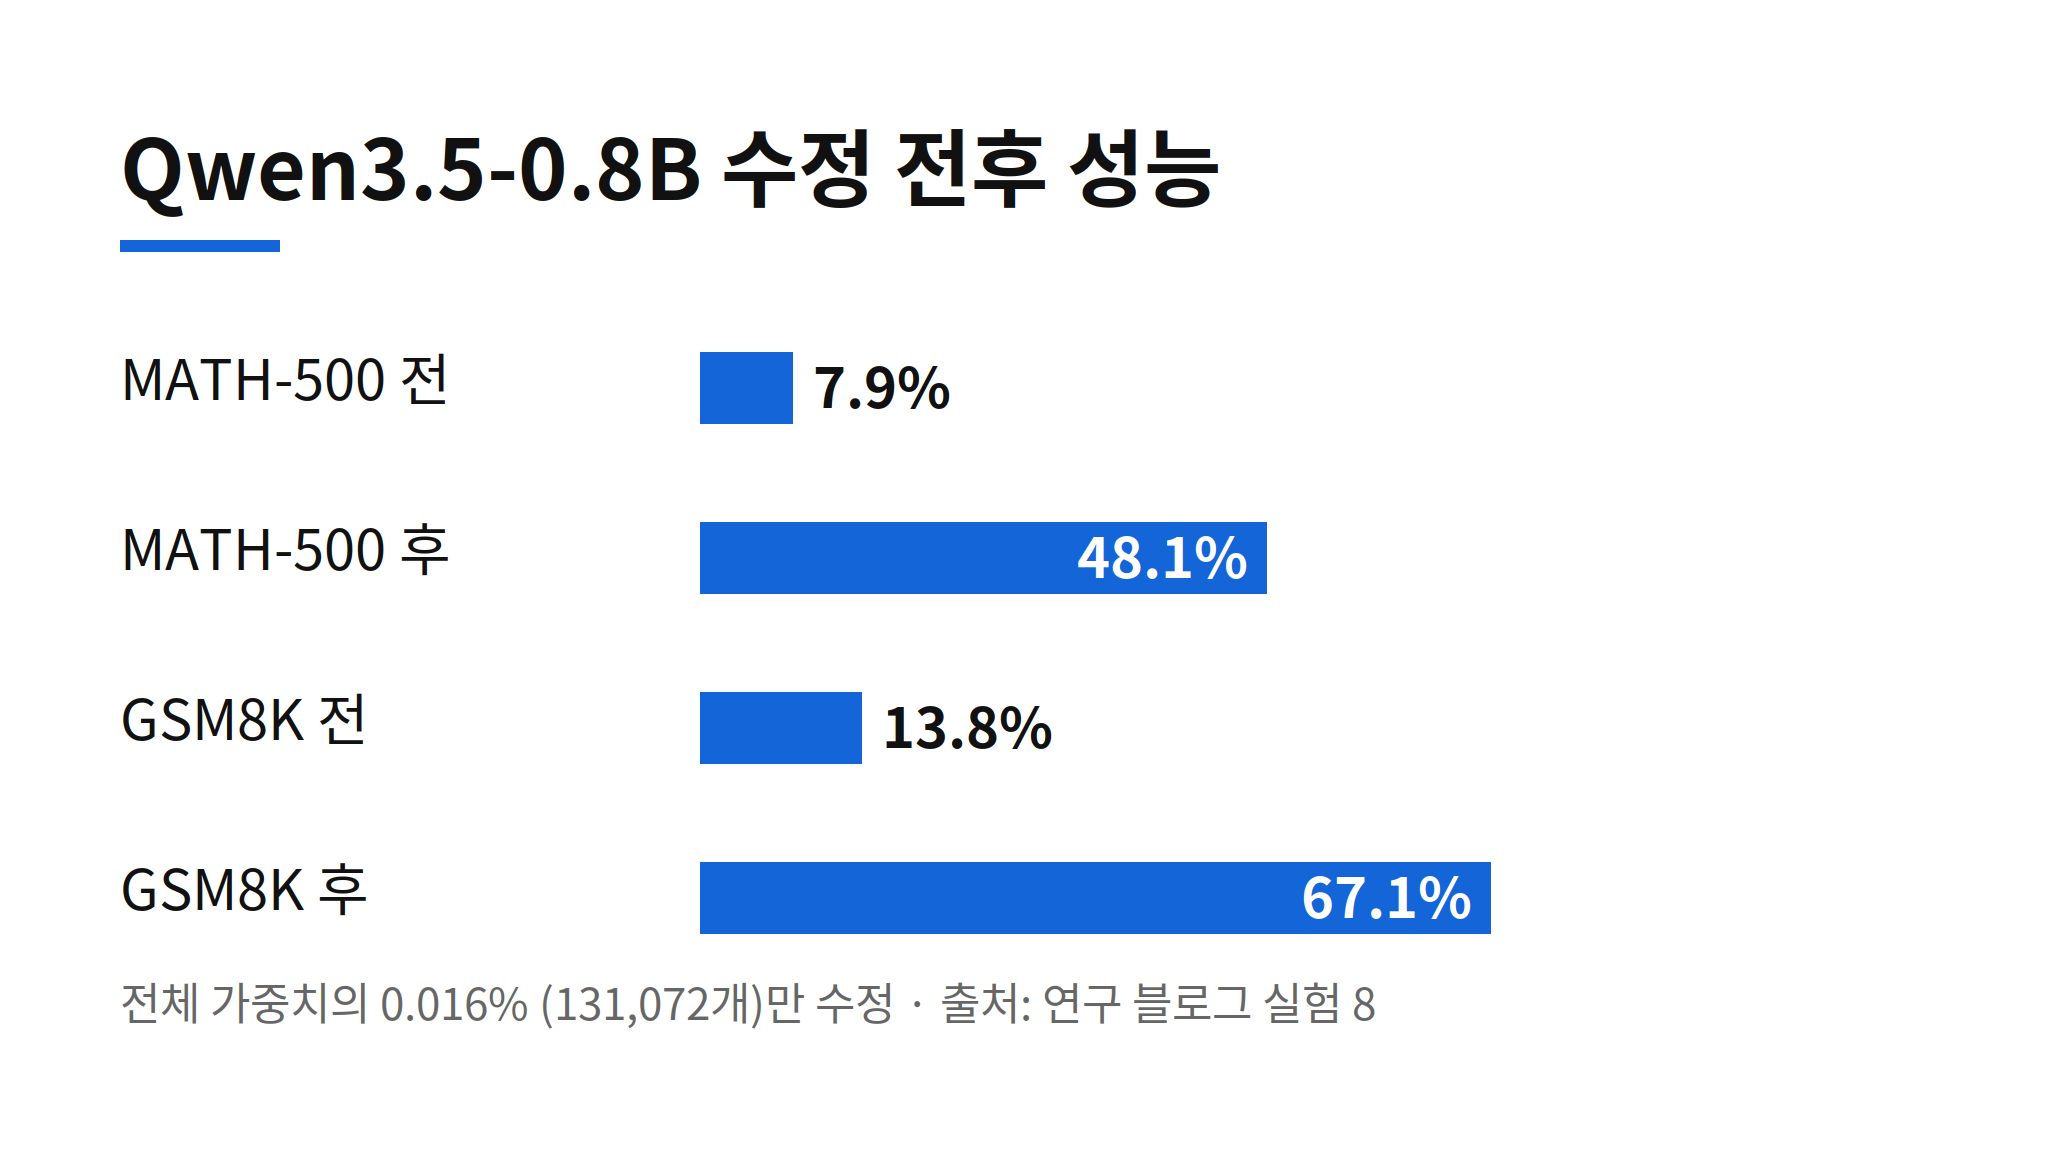
- MATH-500은 7.9%에서 48.1%로 올랐습니다.
- GSM8K는 13.8%에서 67.1%로 올랐습니다.
- 지시 따르기 지표 IFEval도 21.0%에서 62.3%로 약 3배가 됐습니다.
- 토큰 상한에 걸리는 답변 비율은 93%에서 33%로 줄었습니다.
전체 실험 로그는 GitHub에 공개됐고, 수정된 Qwen3.5-0.8B는 Hugging Face에 올라와 있습니다. 블로그는 Hugging Face 측에서 로그를 바탕으로 모델을 재구축하고 평가를 다시 실행했다고 밝히고 있습니다.
확인되지 않은 지점과 한계
- GPT-6 Astra의 정체는 미확인입니다. 어떤 조직의 어떤 모델인지와 외부 접근 가능 여부가 블로그에 밝혀져 있지 않습니다.
- 동료 심사나 arXiv 논문은 아직 없습니다. 수치는 저자 팀의 자체 평가이며, Hugging Face의 재구축·재평가는 실험 8의 산출물에 대한 것입니다.
- 아첨(sycophancy) 모델 식별은 가중치만으로는 4회 모두 실패했고, 주의 패턴을 허용한 뒤에야 성공했습니다.
- 루프가 거의 없는 Gemma 3 270M에서는 MATH-500 개선이 약 1포인트에 그쳤습니다. 없는 능력을 가중치 편집으로 만들지는 못한다는 것이 저자들의 해석입니다.
실무 판단
옵티마이저 중심의 학습 방식에 대한 대안이 실측 결과와 함께 제시된 셈입니다. 가중치만으로 모델의 숨은 문제를 감사하거나, 재학습 없이 결함 방향 하나를 제거하는 운용이 가능해지면 해석 가능성과 모델 유지보수의 비용 구조가 달라집니다.
다만 재현 조건이 아직 닫혀 있다는 점이 판단의 중심입니다. 저자 팀이 측정용 벤치마크와 하네스를 만들고 있다고 밝힌 만큼, 후속 공개에서 같은 모델로 제3자가 재현할 수 있는지가 다음 확인 지점입니다.