ElevenLabs Eleven Realtime: 말로 듣고 바로 답하는 음성 에이전트 모델
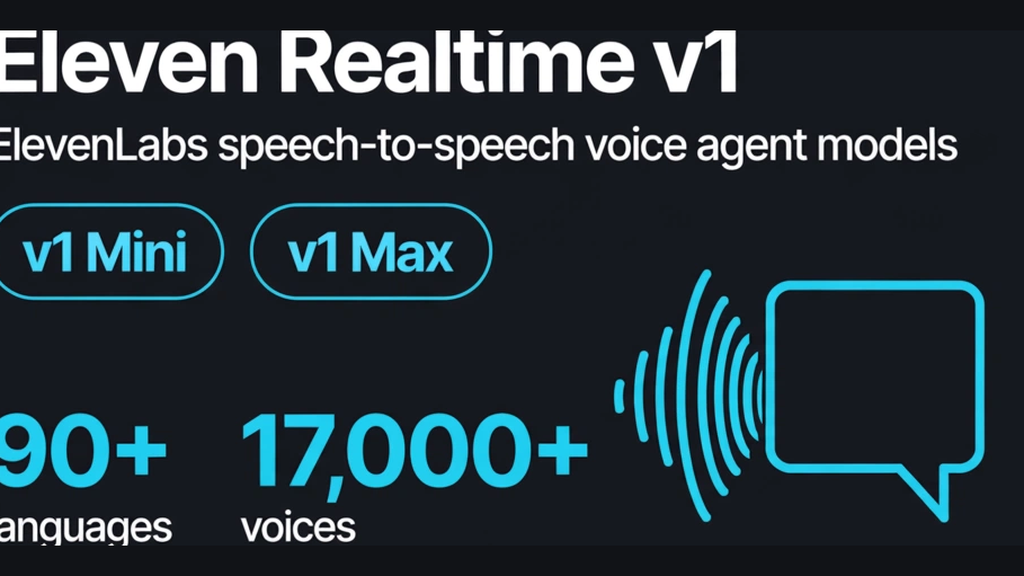
2026년 10월 20일, ElevenLabs가 실시간 음성 에이전트용 speech-to-speech(말→말) 모델 패밀리 Eleven Realtime을 공개했다. v1 Mini와 v1 Max 2종으로 출시됐다 (the-decoder, 2026-10-20).
음성 인식·턴테이킹·음성 활동 감지·음성 생성을 하나의 시스템으로 통합한 구조다. ElevenLabs는 "설정 전문가가 되지 않아도 자연스러운 음성 에이전트를 만들 수 있다"는 점을 내세운다.
모델 두 종: Mini는 대화용, Max는 추론용
- v1 Mini — AI 어시스턴트·교사·인터랙티브 캐릭터 같은 자연스러운 대화용
- v1 Max — 고객 지원·리드 검증·다단계 툴 사용 워크플로 같은 추론이 필요한 작업용
둘 다 90개 이상 언어를 지원하고, ElevenLabs 라이브러리의 17,000개 이상 음성을 쓸 수 있다 (analyticsindiamag).
숫자로 읽는 Eleven Realtime
| 항목 | 값 |
|---|---|
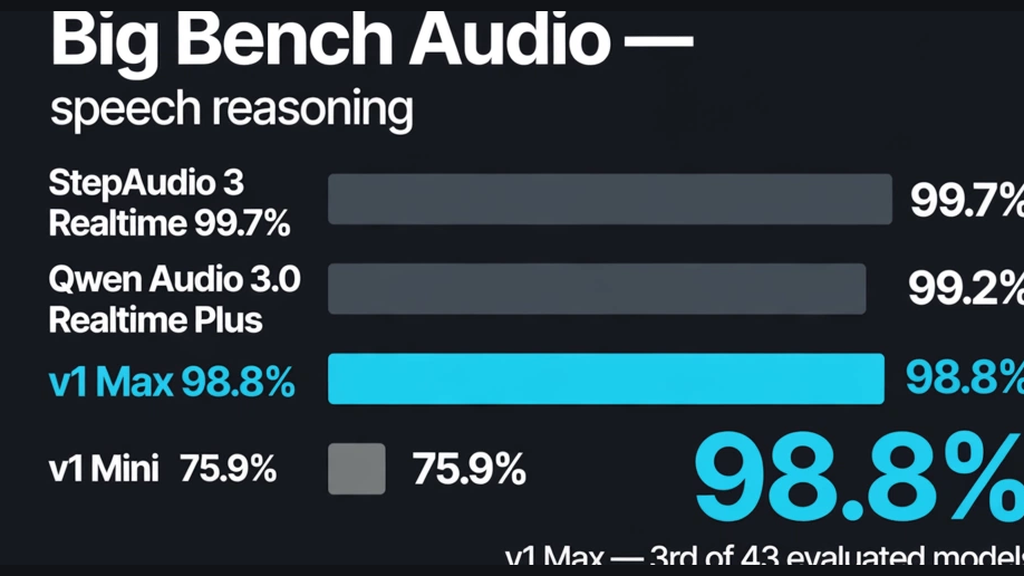
| Big Bench Audio (v1 Max) | 98.8% — 43개 평가 모델 중 3위 |
| Big Bench Audio (v1 Mini) | 75.9% |
| 앞서간 모델 | StepAudio 3 Realtime 99.7% · Qwen Audio 3.0 Realtime Plus 99.2% |
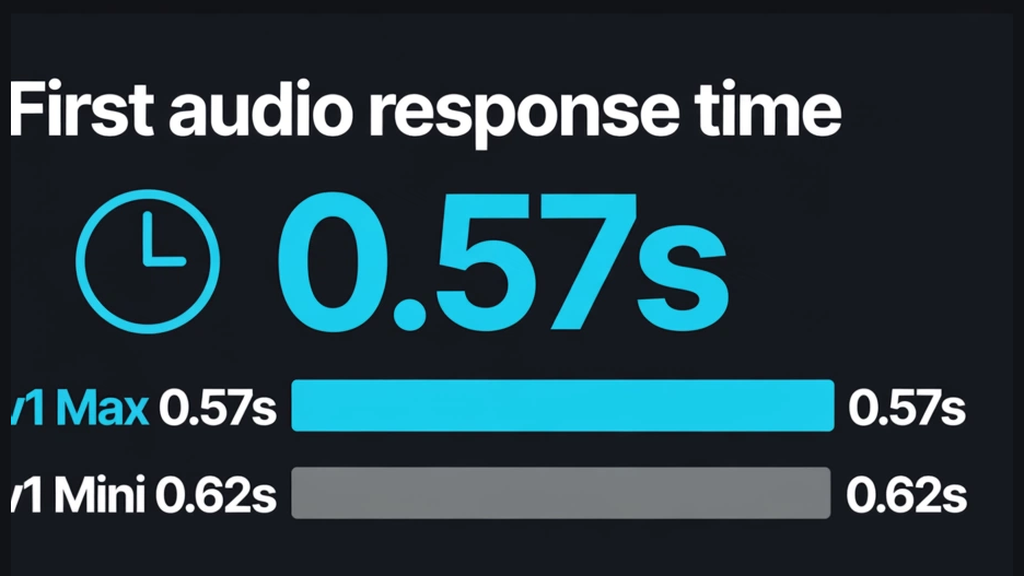
| 평균 첫 오디오 응답 | Max 0.57초 · Mini 0.62초 |
| Speech Agent Arena (블라인드 사용자 비교) | Max 998점 · Mini 988점 |
| Full-Duplex-Bench (턴테이킹·백채널) | Mini 95.8% · Max 94.1% |
ElevenLabs는 "Artificial Analysis 리더보드에서 Max보다 빠르고 정확한 모델은 현재 없다"고 주장했다. 단, 43개 평가 모델 중 Max는 3위다. StepAudio 3 Realtime(99.7%)과 Qwen Audio 3.0 Realtime Plus(99.2%)가 앞섰다 (the-decoder; iaenunminuto).
OpenAI 호환: 코드 2줄로 갈아타기
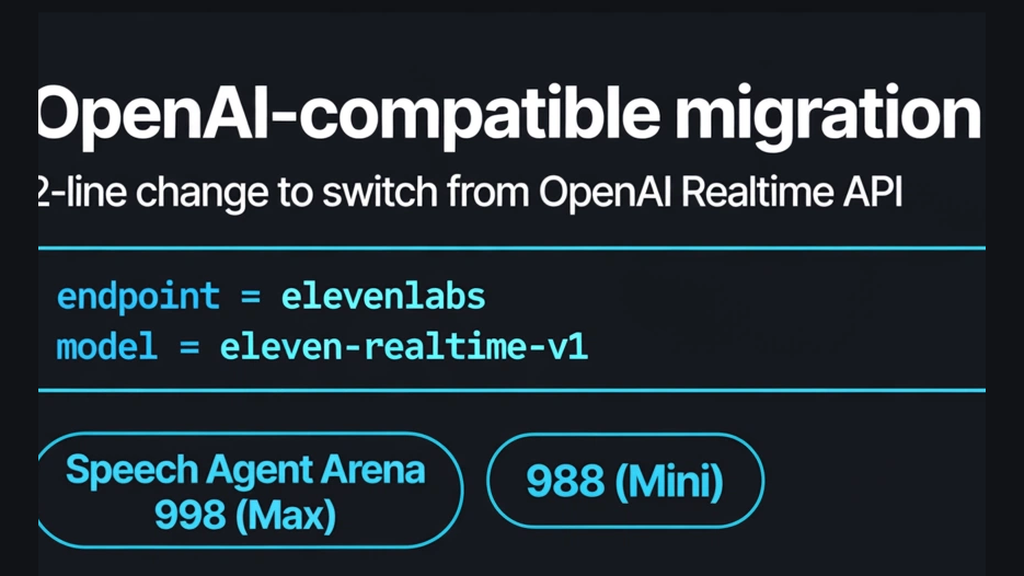
ElevenAgents 플랫폼과 OpenAI 호환 Realtime API(WebSocket, WebRTC는 출시 시점 미지원)로 제공된다. OpenAI Realtime API를 쓰던 팀은 엔드포인트와 모델명 2가지만 바꾸면 마이그레이션할 수 있다. OpenAI SDK도 그대로 쓴다 (journaldunet).
// 개념 코드: OpenAI Realtime API → Eleven Realtime 마이그레이션
val client = RealtimeClient(
    endpoint = "https://api.elevenlabs.io/v1/realtime",  // ① 엔드포인트만 변경
    model    = "eleven-realtime-v1",                      // ② 모델명만 변경
)
// OpenAI SDK 호출부는 그대로
요금: 분당 과금 + 토큰 과금 — 단가는 미공개
요금은 분당 오디오 연결 시간 + 토큰 사용량 기준이다. v1 Max가 v1 Mini보다 비싸다. 구체적인 토큰 단가는 아직 공개되지 않았다 (the-decoder; journaldunet). 이중 과금 구조에서 에이전트 워크로드의 총비용 산정은 검증이 필요하다.
배경: 10월 셋째 주, 음성 AI 릴리스가 몰렸다
음성 에이전트는 그동안 STT→LLM→TTS를 따로 붙이는 조립식 구조가 표준이었다. ElevenLabs는 하나로 튜닝한 단일 시스템으로 맞섰다. 같은 날 Mistral이 Voxtral 3(음성 에이전트 스택)을 내놓았다. 10월 셋째 주는 음성 AI 릴리스가 몰린 주간이 됐다 (관련 글: Mistral 'Voxtral 3').
원문 이슈
이 글은 ax-trend 이슈 #3379를 바탕으로 작성됐다. 핵심 링크: the-decoder.com — ElevenLabs, speech-to-speech 모델 2종 공개 (2026-10-20), analyticsindiamag — 최대 98.8% 음성 추론 정확도 (2026-10-21), journaldunet — 더 빠르고 정확한 speech-to-speech (2026-10-20). 관련 이슈: #3376 — Mistral 'Voxtral 3', #3115 — ElevenLabs 'Architect', #3250 — debpalash 'VoiceStudio'.