#음성 에이전트
7개의 글
#3697
Hex 3.0.0 로컬 음성 입력 — 메모리 900MB에서 160MB로, Linux ARM64 패키지까지
anomalyco가 로컬 음성 입력 도구 Hex 3.0.0을 공개했습니다. 로컬 모델 메모리는 약 900MB에서 약 160MB로 줄었고, Linux ARM64 빌드와 .deb·.rpm 패키지, Vocabulary와 hex 명령이 추가됐습니다.
#3643
Deepgram, Pipecat 제작사 Daily 인수 발표 — 오픈소스 유지·독립 재단 설립
Deepgram이 2026년 10월 29일 Pipecat 제작사 Daily 인수를 발표했습니다. Pipecat은 BSD V2 라이선스로 오픈소스와 무료 이용을 유지하고, 독립 재단이 새로 설립됩니다. 실시간 컨텍스트 표준 RCS도 함께 공개됐습니다.
#3637
AssemblyAI 첫 TTS 모델 TTS-1 출시 — 음성 에이전트 스트리밍, 100만 자당 15달러
AssemblyAI가 첫 텍스트 음성 변환 모델 TTS-1을 출시했습니다. 실시간 통화용 스트리밍, 100만 자당 15달러의 사용량 요금, 동시 접속 구간 없음, 그리고 자체 수치와 독립 벤치마크 사이의 간극을 정리했습니다.
#3608
NVIDIA Nemotron 3.5 Transcribe 공개 — 40개 언어 전사·8명 화자 구분
NVIDIA가 2026년 10월 28일 오픈웨이트 음성 모델 Nemotron 3.5 Transcribe를 공개했습니다. 40개 언어 전사와 8명 화자 구분, 1시간 녹음 처리를 하나의 체크포인트에 묶었고, 46만 시간 규모의 Granary v2 데이터셋도 함께 열었습니다.
#3383
Underdog Bark 3.0: 163MB 음성 모델이 Whisper보다 낮은 오류율 주장
Underdog AI가 163MB 음성 인식 모델 Bark 3.0을 출시했다. 회의 녹음 단어 오류율 자사 측정 7.82%로 Whisper large-v3(13.63%)보다 낮다고 주장했다. CC-BY 4.0 오픈소스, 영어 전용.
#3379
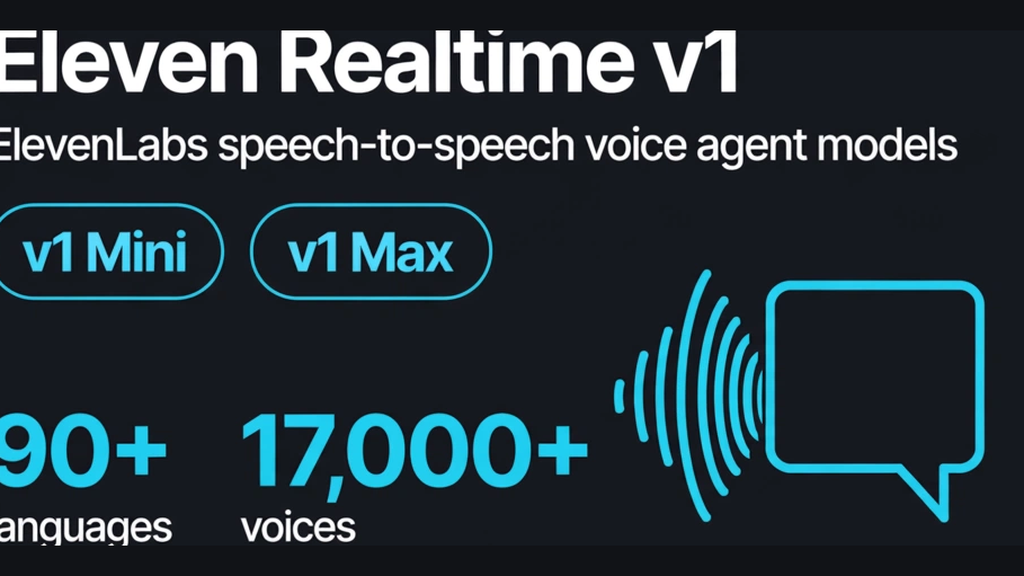
ElevenLabs Eleven Realtime: 말로 듣고 바로 답하는 음성 에이전트 모델
ElevenLabs가 실시간 음성 에이전트용 speech-to-speech 모델 'Eleven Realtime v1'(Mini/Max)을 공개했다. v1 Max는 Big Bench Audio 98.8%, 첫 오디오 응답 0.57초. OpenAI Realtime API 호환이라
#3376
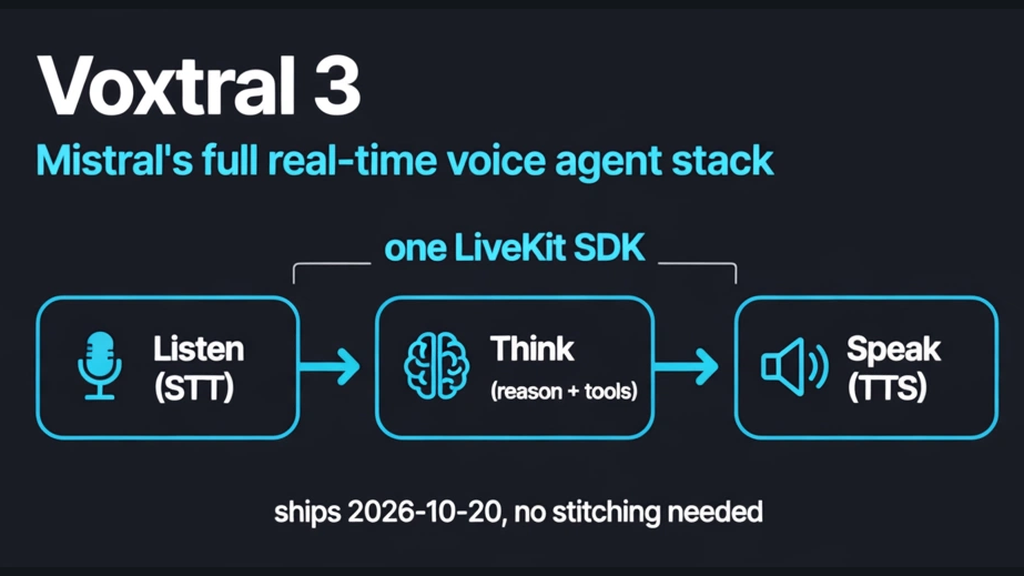
Mistral Voxtral 3: STT·TTS·SDK를 묶은 실시간 음성 에이전트 스택와 SDK 통합
Mistral이 실시간 음성 에이전트 스택 Voxtral 3를 출시했다. STT/TTS 모델군 + LiveKit 기반 SDK. FLEURS WER 4.1%(Whisper large-v3 16.0%) 주장, 분당 $0.0035부터.