NVIDIA Nemotron 3.5 Transcribe 공개 — 40개 언어 전사·8명 화자 구분
공개 내용
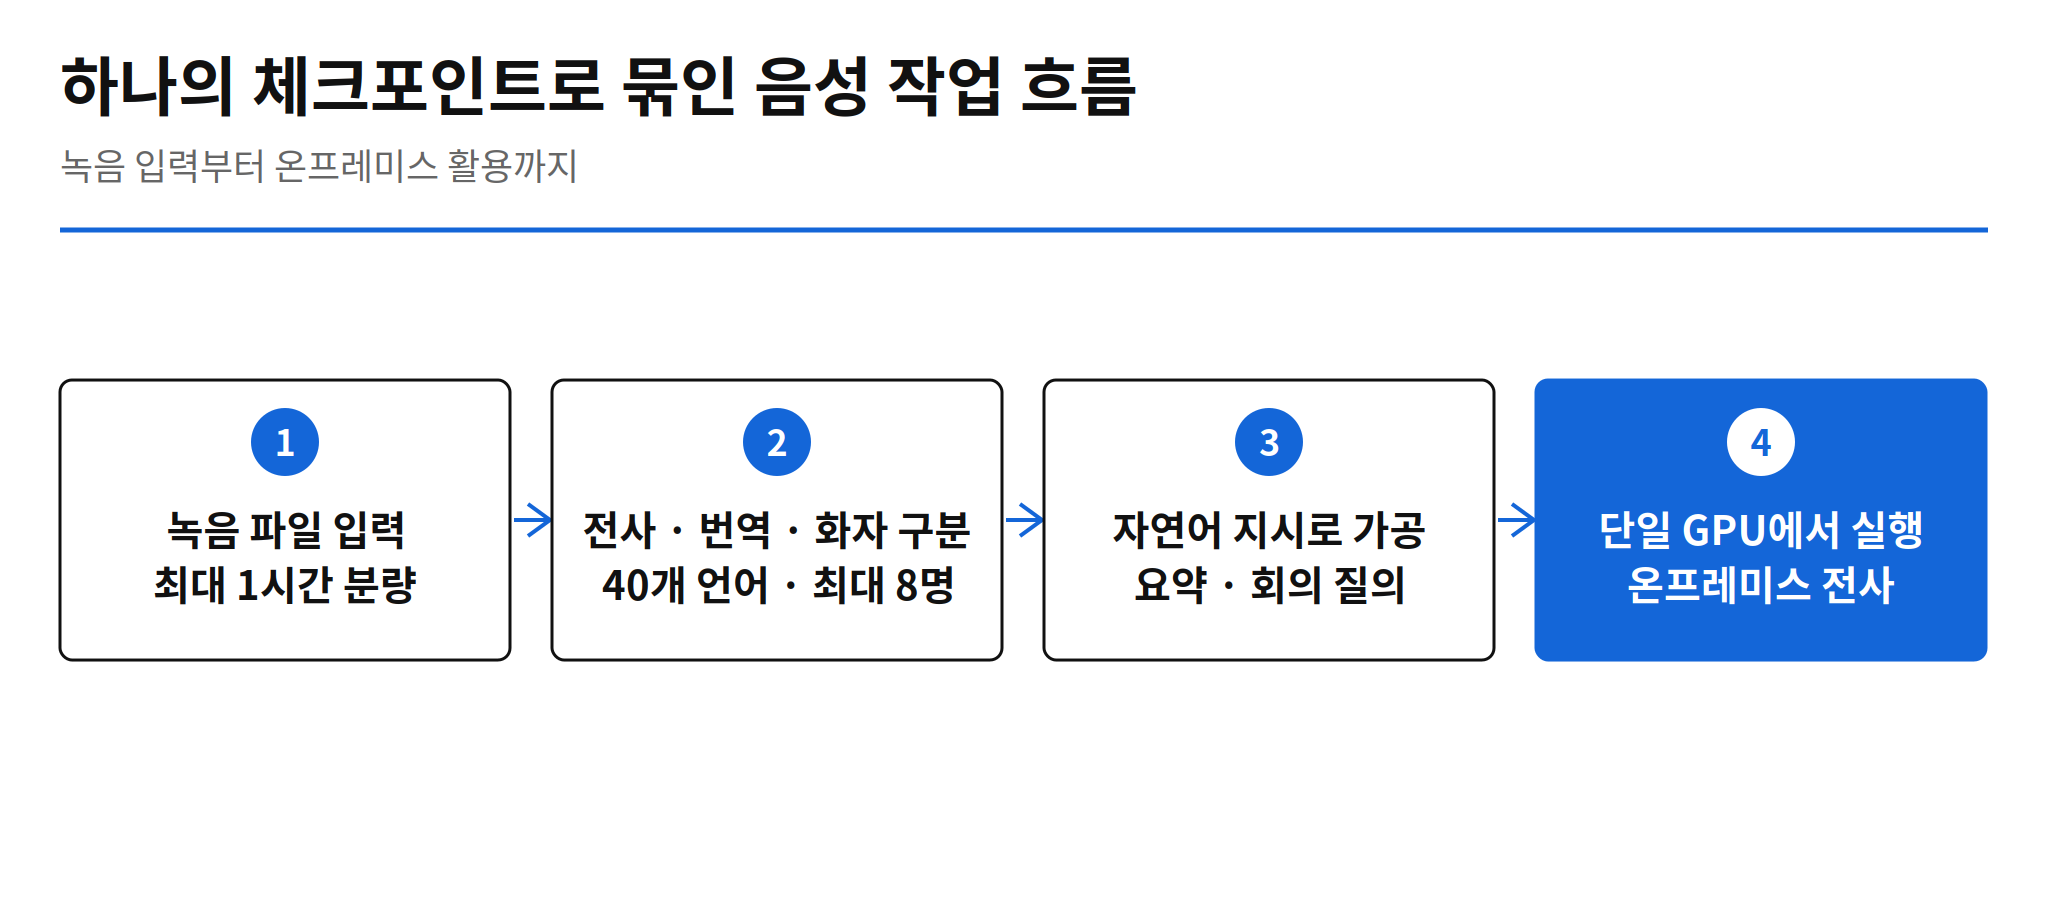
NVIDIA는 2026년 10월 28일 오픈웨이트 음성 모델 Nemotron 3.5 Transcribe를 공개했습니다. 녹음된 음성을 텍스트로 바꾸는 모델이며, 전사·번역·화자 구분·음성 질의응답을 하나의 체크포인트에 합친 것이 특징입니다. 자연어 지시로 그대로 받아쓰기, 요약, 회의 내용 질의를 만들 수 있습니다.
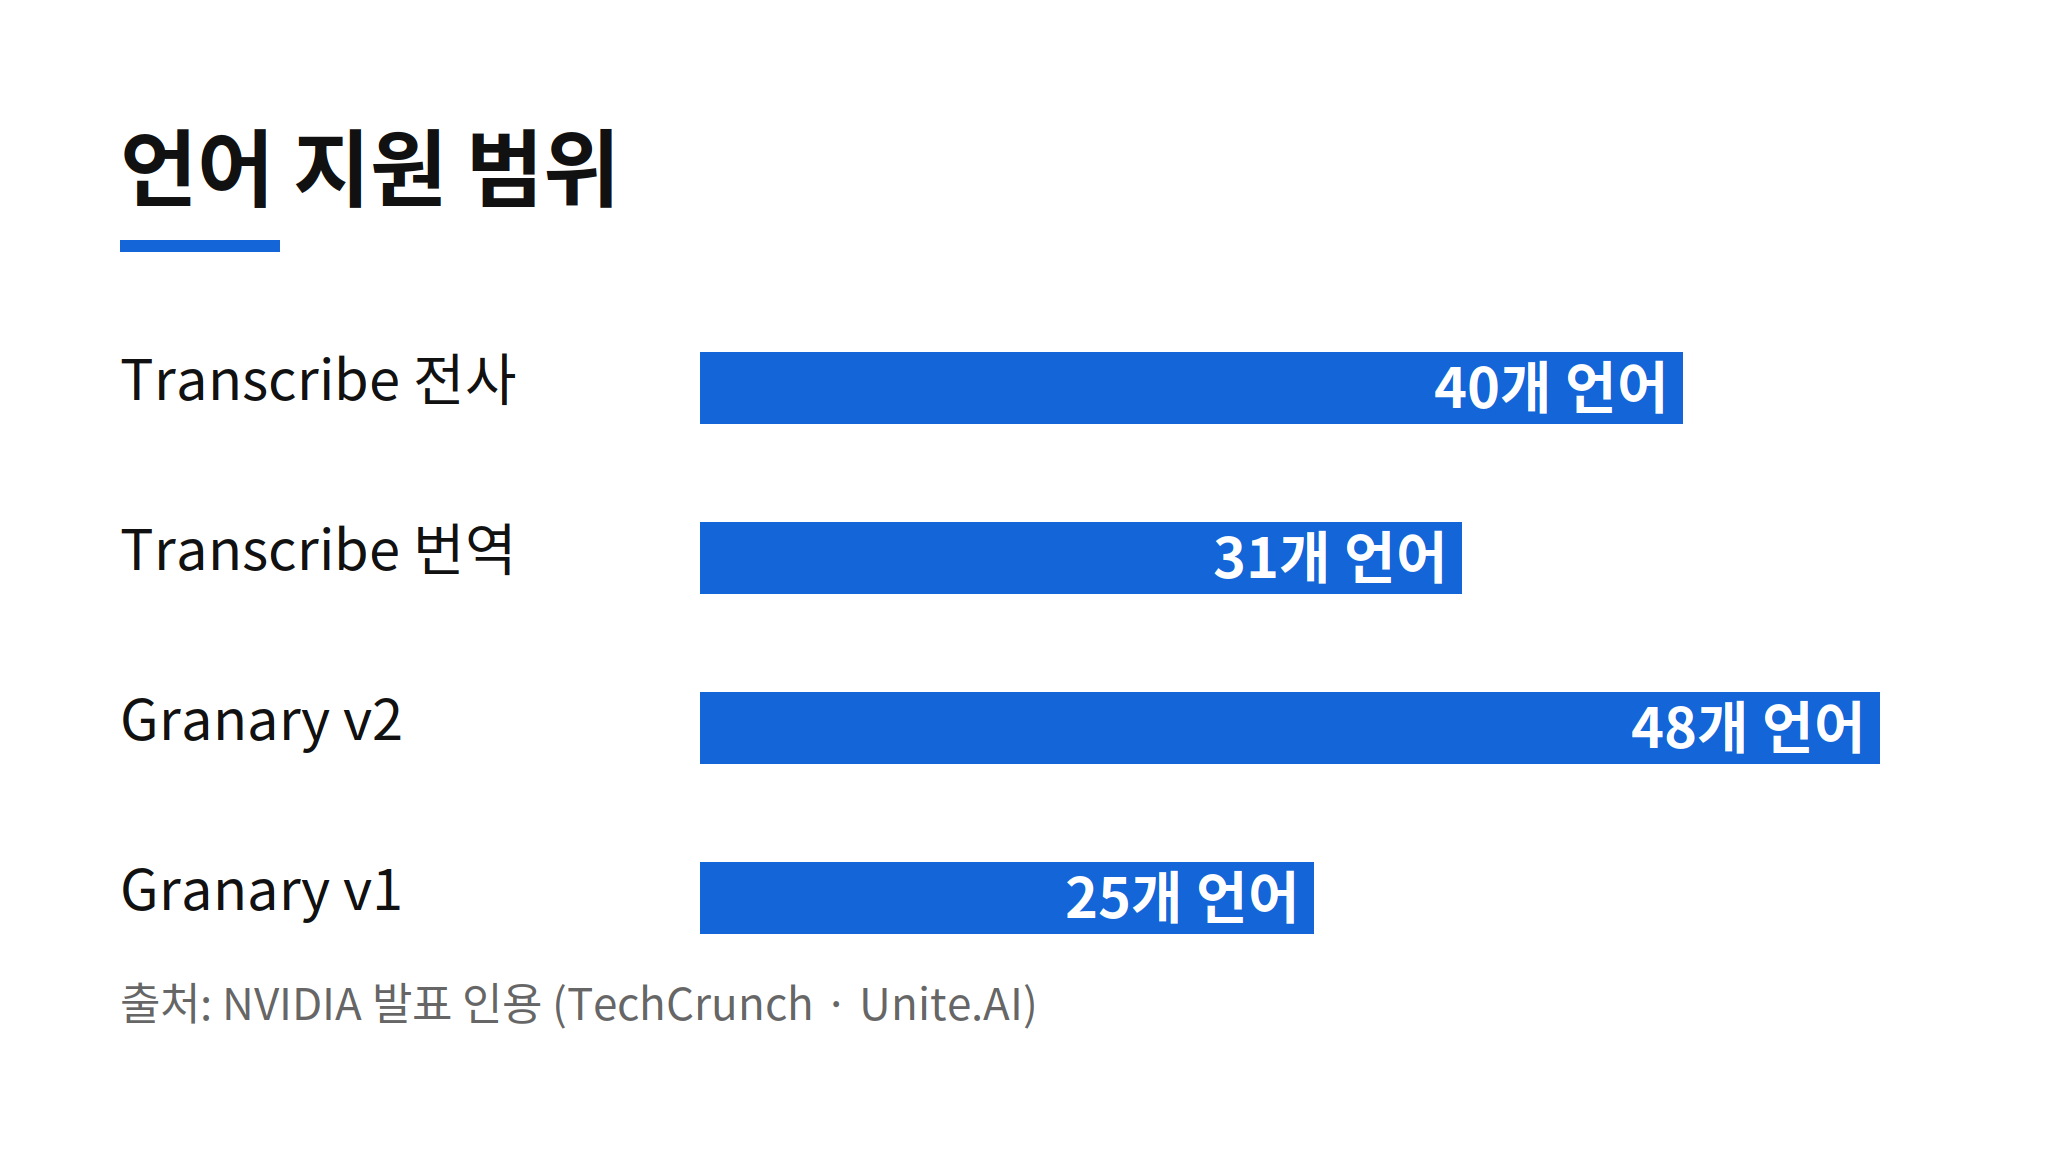
지원 범위는 40개 언어 전사, 31개 언어와 영어 사이 번역, 최대 8명 화자 구분, 최대 1시간 녹음 처리입니다. 구조는 300억 개 파라미터의 혼합 전문가(MoE)이며, 토큰당 약 40억 개 파라미터만 활성화합니다. Jetson AGX Thor부터 DGX Spark, Blackwell 데이터센터 칩까지 단일 GPU에서 동작합니다.
핵심 수치
| 항목 | 수치 | 비고 |
|---|---|---|
| 모델 규모 | 300억 개 파라미터 (MoE) | 토큰당 약 40억 개 파라미터만 활성화 |
| 처리 속도 | 100시간 분량을 3분 안에 처리 | RTX PRO 6000 Blackwell Server Edition, NVFP4 정밀도, NVIDIA 자체 벤치마크 |
| 전사 정확도 | AA-WER 2.8% | Artificial Analysis 외부 벤치마크, 오픈웨이트 모델 중 1위 동점 |
| 동점 상대 | 240억 개 파라미터 활성화 모델 | Transcribe는 토큰당 약 40억 개만 활성화 |
| 데이터셋 규모 | 463,062시간 | Granary v2, 48개 언어 (v1은 25개 언어) |
속도 수치는 NVIDIA 자체 벤치마크 기준이며, 정확도 수치는 Artificial Analysis의 외부 측정입니다. 두 수치는 출처가 다르므로 같은 잣대로 직접 비교하기보다는 각각의 측정 조건을 따로 확인하는 편이 안전합니다.
함께 공개된 것
- Granary v2 — 463,062시간 분량의 오픈 음성 데이터셋으로, 48개 언어를 다룹니다. v1의 25개 언어에서 크게 늘었습니다.
- OpenMDW-1.1 라이선스 — 가중치가 이 라이선스로 공개됐으며, Hugging Face 모델 카드에 10월 28일 출시일이 적혀 있습니다.
- 호스팅 엔드포인트 — Baseten, DeepInfra, Simplismart가 호스팅 엔드포인트를 제공합니다.
- 경쟁 구도 — 같은 달에 Mistral이 Voxtral 3를, ElevenLabs는 실시간 음성을, Salesforce는 Launa-Omni를 내놓았습니다. NVIDIA는 이미 Parakeet(11억 개 파라미터) 같은 오픈웨이트 음성 모델을 내놓은 상태입니다.
중요성
회의 녹음을 받아쓰고 화자를 구분하고 요약을 뽑는 작업이 하나의 오픈 모델로 묶였습니다. 단일 GPU에서 돌아간다는 점이 온프레미스 전사 도구를 만드는 개발자에게 직접 쓸모가 있습니다. 46만 시간 규모의 데이터셋까지 함께 열렸으니, 전문 용어에 맞춘 파인튜닝 재료도 확보됐습니다.
이 글의 핵심은 모델 하나보다 묶음에 있습니다. 전사·번역·화자 구분·질의응답을 따로 붙이던 파이프라인이 체크포인트 하나로 줄어들면, 회의 기록과 의료 전사처럼 음성 AI가 일터에 자리 잡은 분야의 도입 문턱이 낮아집니다.
아직 확인되지 않은 점
Hugging Face Open ASR Leaderboard 1위 주장은 NVIDIA의 자체 발표 기준이며, 해당 리더보드가 API 모델을 제외한 순위인지 원문 차트에서 확인이 필요합니다. 실시간 스트리밍은 지원하지 않고 녹음 파일만 처리합니다. 언어별 지원 범위가 작업마다 다르며, 음성 질의응답 학습은 영어로만 이뤄졌습니다. 한국어 전사 품질이 어느 수준인지, 40개 언어 목록에 한국어가 포함되는지는 원문에서 별도 확인이 필요합니다.
실무 판단: 온프레미스 전사부터, 한국어 품질은 직접 재고 도입합니다
실무 판단은 이렇게 정리됩니다. 회의·전사 도구를 사내에서 돌리려는 팀이라면 단일 GPU 구성을 먼저 써보는 것이 순서입니다. 다만 한국어 전사 품질이 미확인인 상태에서는 한국어 회의록을 곧바로 맡기기보다, 자기 팀의 실제 녹음으로 정확도를 먼저 재는 것이 좋습니다. 실시간 스트리밍이 필요하면 이 모델이 아니라 스트리밍 지원 모델을 고르는 편이 맞습니다. Granary v2는 전문 용어 파인튜닝 재료로 가치가 있으나, 48개 언어 중 한국어 비중은 따로 확인해야 합니다.
원문 이슈
- TechCrunch, 2026-10-28
- Silicon Report, 2026-10-28
- Unite.AI, 2026-10-28
- ax-trend 이슈 #3608
- 관련 이슈 #3376 — Mistral, 실시간 음성 에이전트 스택 'Voxtral 3' 출시
- 관련 이슈 #2934 — Microsoft, 실시간 음성 모델 MAI-Transcribe-2-Streaming + MAI-Voice-2.1(Flash) 공개
- 관련 이슈 #3278 — NVIDIA, Nemotron 3.5 Super VL 120B 공개 + Bolt 74B-A9B 정식 출시