Behavioral Localization: 스킬 효과 국소화로 소프트 프롬프트를 학습한다
설명이 길어질수록 매 호출마다 비용이 붙는다 — 왜 짧게 만들어야 하나
text skill은 tool-using agent의 능력을 확장해줍니다. 자연어로 쓴 설명을 에이전트에게 건네는 방식이죠. 그런데 설명이 길어지면 계산 비용도 함께 커집니다. 매 호출마다 긴 설명을 읽어야 하니까요.
soft prompt는 compact한 대안으로 제시돼 왔습니다. 문제는 학습 방식에 있습니다. 전체 성공 trajectory로 학습하면, 필요한 부분 외의 불필요한 행동 변화까지 함께 생긴다고 합니다. 외워야 할 것을 통째로 외우게 하니, 엉뚱한 행동까지 따라 배우는 셈이죠.
이 연구의 출발점은 한 가지 관측입니다. text skill의 유용한 효과는 trajectory positions의 작은 subset에 집중돼 있다는 것이죠. 전체가 아니라 일부 위치라는 말입니다. 그렇다면 그 위치만 골라 학습시키면 되지 않을까요?
효과가 있는 위치만 찾는다 — 켜고 끄며 비교하는 법
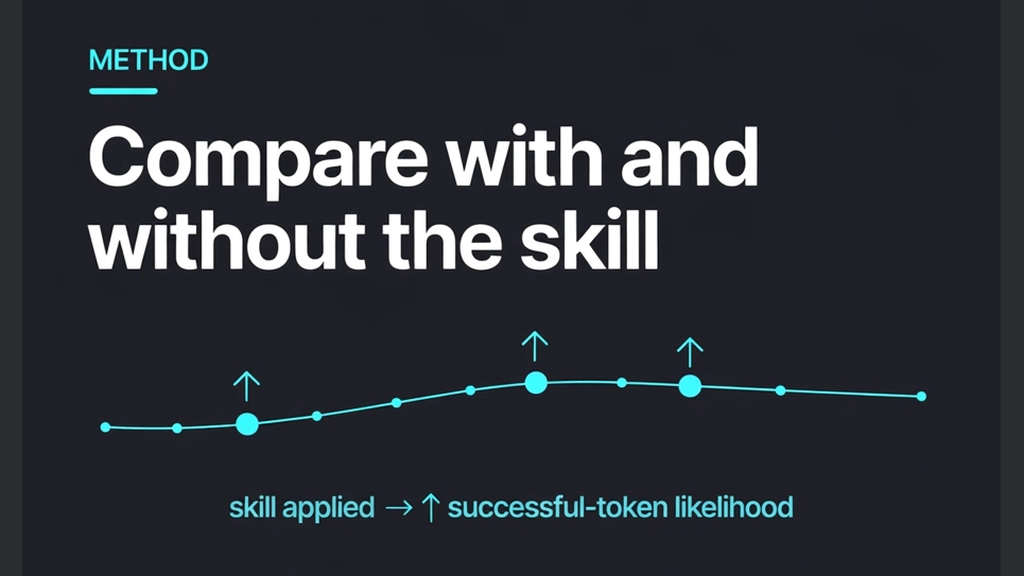
Behavioral Localization은 frozen agent를 text skill 유무로 비교합니다. 스킬이 successful tokens의 likelihood를 높이고, next token distribution을 의미 있게 바꾸는 위치를 찾는 방식입니다.
찾아낸 국소 위치들로 short soft prompt를 supervision합니다. 작지만 행동 관련성이 높은 위치 집합이 효과적인 supervision을 제공한다는 것이 연구의 주장입니다.
- 비교 대상: 스킬을 준 frozen agent와 주지 않은 frozen agent입니다.
- 선정 기준: 스킬이 성공 토큰의 likelihood를 높이는 위치, 그리고 다음 토큰 분포를 의미 있게 바꾸는 위치입니다.
- 학습 대상: 궤적 전체가 아니라, 국소화된 위치만으로 짧은 소프트 프롬프트를 학습시킵니다.
상위 10%가 96.12%를 품는다 — 숫자로 보는 결과
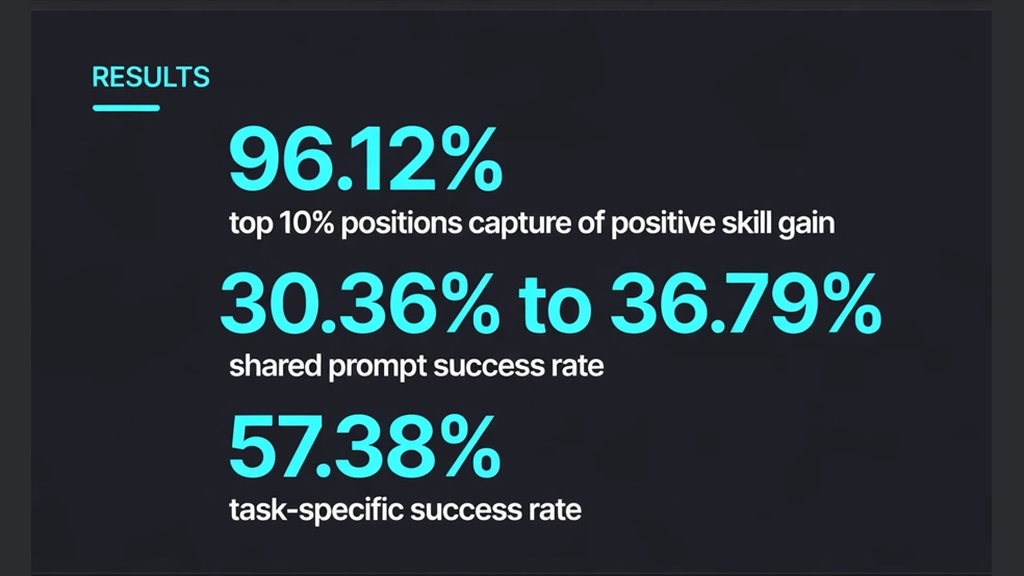
실험은 SpreadsheetBench와 frozen Qwen3.6-35B-A3B로 진행됐습니다. 결과부터 정리하면, top 10% trajectory positions가 total positive skill gain의 96.12%를 포착했습니다. 효과의 대부분이 10%에 몰려 있다는 관측이 숫자로 확인된 것이죠.
학습 결과도 함께 봐야 합니다. shared prompt setting에서 selective supervision은 success rate를 30.36%에서 36.79%로 올렸습니다. full trajectory 전체로 학습한 경우와 비교한 결과입니다.
task-specific 조건에서는 더 강합니다. top 10% localized positions로 57.38%를 달성했고, full text skill과 on-policy OPCD baseline을 앞섰다고 합니다.
전체 궤적을 학습시키는 것은 필요한 행동만 가르치는 방법이 아니었습니다. 효과가 집중된 위치만 골라 가르치는 편이, 더 적게 가르치면서도 더 잘하는 길이었습니다.
아직 가려진 것들 — 길이도, 일반화도 미확인이다
설계가 깔끔한 만큼, 확인되지 않은 항목도 또렷합니다. 섣불리 메우지 않고 미확인으로 남겨두는 편이 맞습니다.
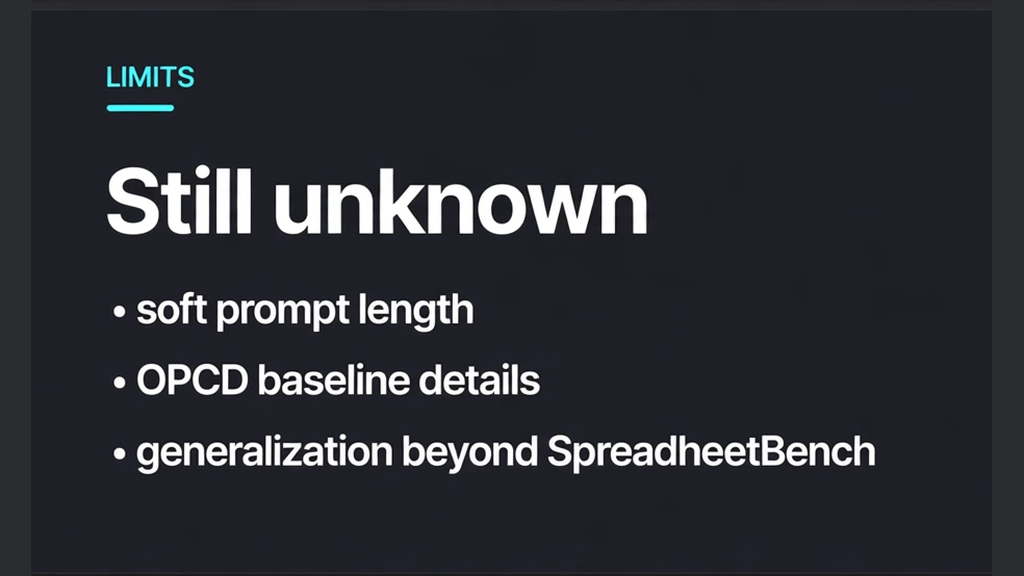
- supervision에 쓴 short soft prompt의 길이(토큰 수)는 미확인입니다.
- 비교 대상인 on-policy OPCD baseline의 full name과 세부는 미확인입니다.
- SpreadsheetBench 외 태스크에서의 일반화는 미확인입니다.
- full trajectory 학습 대비 selective supervision의 학습 비용 차이는 미확인입니다.
우리 팩토리에 무엇을 가져올까 — 프롬프트 다이어트의 기준점
이슈 본문이 짚은 실무적 가치는 비용과 직결됩니다. 스킬과 프롬프트 주입 비용은 토큰 비용과 직결돼, 설명이 길수록 매 호출마다 비용이 붙는다고 합니다. “효과는 10%에 집중된다”는 관측은 우리 크론 프롬프트 다이어트의 정량 근거가 될 수 있죠. 길게 쓰던 스킬 설명을 어디서 잘라야 할지 알려주는 셈입니다.
soft prompt 전환을 검토할 때도 마찬가지입니다. Behavioral Localization처럼 효과가 집중된 위치만 골라 학습시키는 방식을 기준으로 삼을 수 있지 않을까요? 다만 아직은 한 벤치마크, 한 frozen 모델에서의 결과입니다. 우리 환경의 스킬과 태스크에서 직접 재보는 것이 순서겠죠. 숫자는 가져오되, 판단은 우리 과제로 검증하는 게 맞지 않을까요?