CATS: 에이전트별 기여도 계산으로 멀티에이전트 토폴로지를 탐색하는 연구와 슈퍼그래프 팀 탐색
핵심 — 팀 점수로는 누가 돕는지 알 수 없다
- LLM 멀티에이전트 시스템의 정확도와 비용은 토폴로지에 달린다. 어떤 에이전트를 쓰고 어떻게 연결하는지가 결과를 바꾼다.
- 문제는 단일 작업 점수만으로는 누가 돕고 누가 해치는지 알 수 없다는 점이다. 팀 전체가 잘했다고 해서 구성원 모두가 잘한 것은 아니다.
- CATS(Contrastive Attribution Topology Search)는 이 문제를 에이전트별 기여도 계산으로 푼다. 전문가 에이전트들의 고정 슈퍼그래프 안에서 컴팩트한 팀을 탐색한다.
- 멀티에이전트 코딩 도구가 늘면서 에이전트를 몇 개 붙이고 어떻게 연결할지가 성능과 비용을 좌우하는 지금, 팀 구성 방식을 바꾸는 접근이다.
동작 — 트레이스를 비교해 기여도를 매긴다
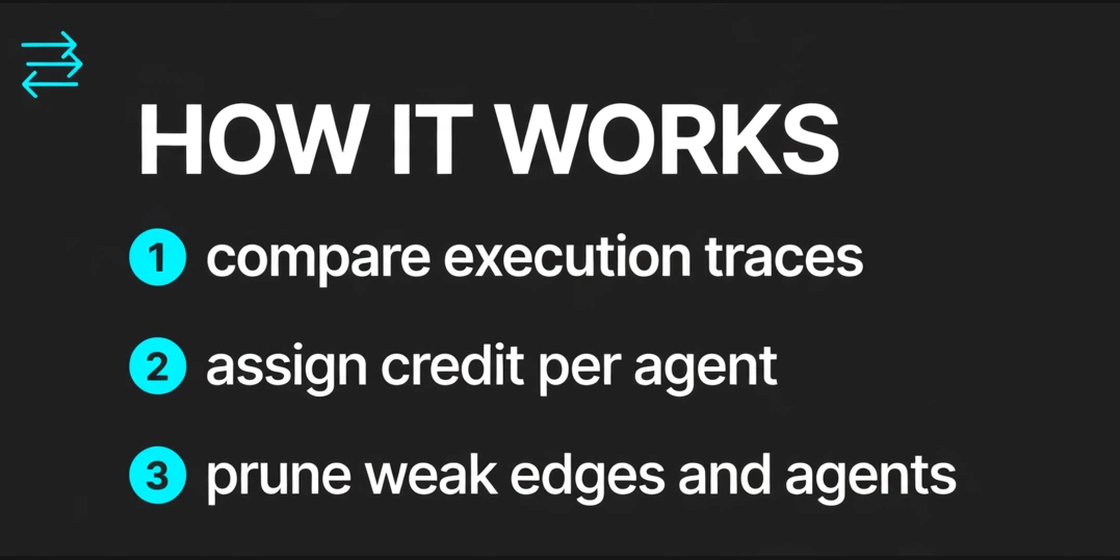
- LLM attributer가 후보 토폴로지들의 실행 트레이스를 비교하면서 에이전트 개개인에게 기여도를 부여한다.
- CATS는 이 기여도로 슈퍼그래프 간선을 업데이트한다. 약한 간선과 에이전트를 점진적으로 가지치기해 배포용 소규모 팀을 만든다.
- 즉 탐색의 단위가 팀 전체가 아니라 에이전트 한 명, 간선 하나다. 기여도가 낮은 연결부터 덜어내는 방식이다.
이 글의 수치는 이슈 본문과 논문 초록에 나온 그대로다. MBPP의 "가장 강한 베이스라인과 동점"은 정확도 동점이라는 뜻이지, 토큰까지 같다는 뜻이 아니다.
수치 — 정확도는 올리고 토큰은 절반 가까이 줄였다
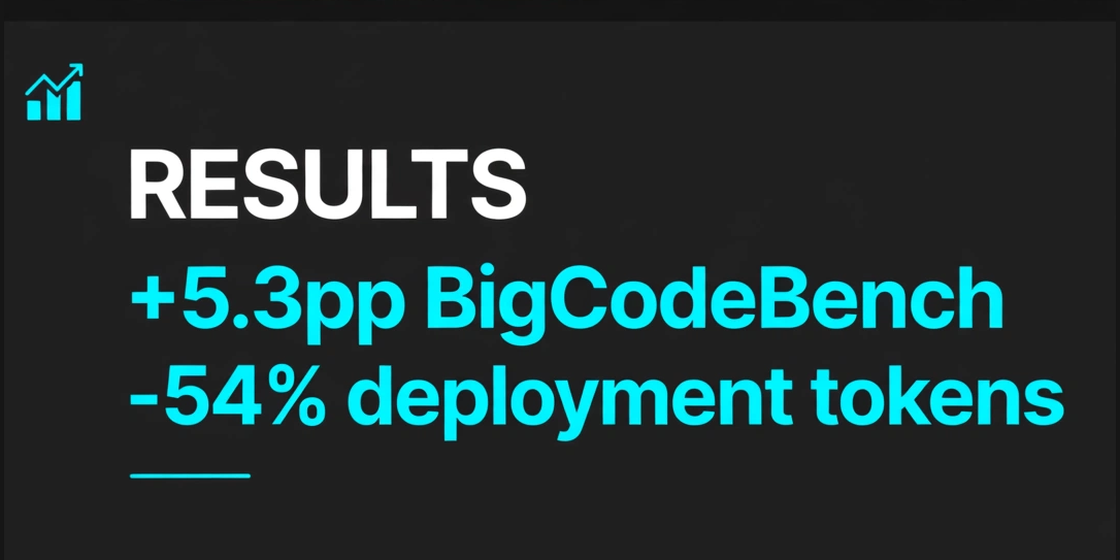
- 작은 open-weight 모델과 동일한 수의 후보 평가 조건에서 BigCodeBench 평균 정확도를 score-only heuristic search보다 5.3 percentage points 높였다. 이때 배포 토큰은 54% 적게 썼다.
- MBPP에서는 가장 강한 베이스라인과 동점의 정확도를 내면서 다른 탐색 방식보다 토큰을 적게 썼다.
- 비교 기준을 정리하면, +5.3pp의 비교 대상은 score-only heuristic search이고, 토큰 절감의 비교 대상은 같은 후보 평가 조건이다. 두 수치를 서로 다른 베이스라인과 섞어 읽으면 안 된다.
스트레스 테스트 — 악성 에이전트를 전부 걸러냈다
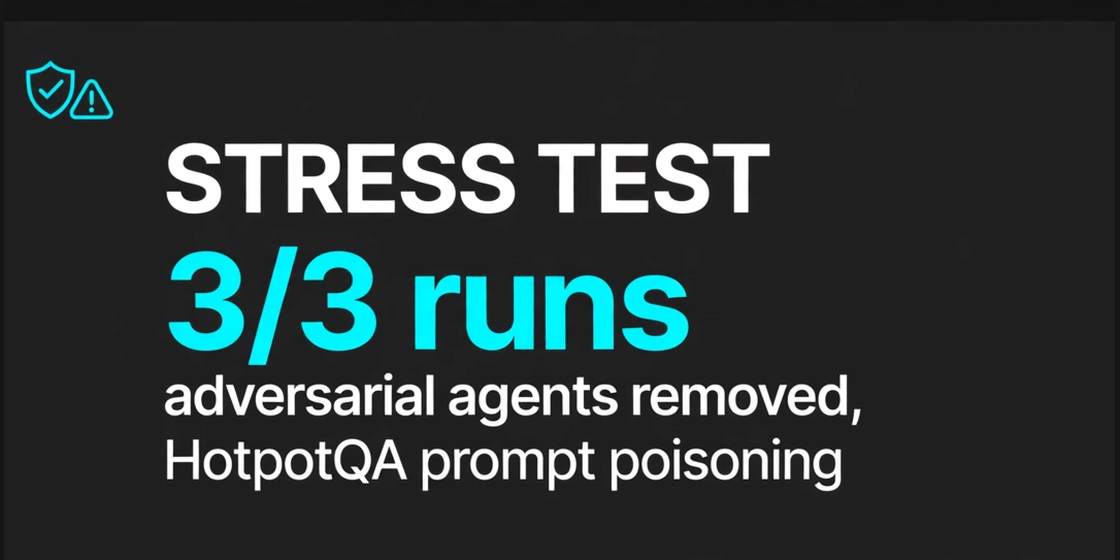
- HotpotQA prompt-poisoning 스트레스 테스트에서는 3번의 run 모두에서 adversarially prompted agents를 전부 제외했다.
- 같은 테스트에서 random search는 비슷한 정확도에서 일부 악성 에이전트를 유지했다. 정확도만 보면 비슷해 보이지만, 팀 안에 악성 에이전트가 남아 있느냐가 다르다.
- 적대적 프롬프트를 단 에이전트를 자동으로 걸러낸다는 점은 프롬프트 인젝션 방어에도 힌트가 된다. 실무 환경에 가까운 테스트를 포함한 점이 이 논문의 강점이다.
왜 중요한지 — AX 에이전트 설계에 바로 응용된다
멀티에이전트 시스템을 실제 서비스에 올릴 때 토큰 비용이 발목을 잡는 경우가 많다. CATS처럼 배포 토큰을 절반 가까이 줄이면서 정확도를 올리는 토폴로지 탐색은 AX 에이전트 설계에 바로 응용할 수 있다. 에이전트를 추가할수록 좋아지는 것이 아니라, 기여도가 낮은 에이전트를 덜어내는 것이 비용과 정확도를 함께 잡는 길일 수 있다. 악성 프롬프트를 단 에이전트를 걸러내는 성질까지 갖추면, 팀 구성 자체가 일종의 방어층이 된다.
아직 안 밝혀진 것 / 쟁점
- 슈퍼그래프 자체는 고정되어 있다. 초기 에이전트 풀의 구성이 최종 결과에 얼마나 영향을 미치는지는 미확인이다.
- HotpotQA 외에 실제 서비스 로그나 다른 도메인에서의 검증 결과는 미확인이다.
- LLM attributer의 계산 비용이 전체 탐색 비용에서 차지하는 비중도 미확인이다.
- 코드 공개 여부도 미확인이다. 초록에 언급이 없다.