TorchTPU: 구글·메타 공동 TPU 네이티브 PyTorch 백엔드 오픈소스 공개와 52% MFU 기록
2026년 10월 20일, Google이 PyTorch Conference 2026에서 TorchTPU를 오픈소스로 공개했다. Google TPU용 네이티브 PyTorch 백엔드로, Google이 2025년 중반에 시작한 프로젝트를 Google과 Meta의 PyTorch 팀이 공동 개발한 결과물이다. 발표는 Google Cloud 블로그(Mark Lohmeyer, VP & GM AI & Computing Infrastructure · Bill Jia, VP Engineering)와 pytorch.org 블로그를 통해 나왔다 (2026-10-20).
배경은 단순하다. TPU는 10년간 TensorFlow/JAX 생태계에 묶여 있었고, PyTorch 사용자는 PyTorch/XLA의 마찰을 감수해야 했다. 같은 행사·같은 블로그 포스트에서 분산 추론 스택 llm-d 1.0(ax-trend #3369)도 함께 발표됐다 — Google이 "TPU를 PyTorch의 GPU·CPU 옆 네이티브 옵션"으로 만드는 패키지 전략이다. 밑바탕에는 CUDA 락인의 소프트웨어 비용을 낮추려는 움직임이 있다.
해결하려는 문제: PyTorch/XLA의 마찰
기존 PyTorch/XLA(2020년 도입)는 세 가지가 아팠다. 명시적 컴파일 영역 정의 등 소스 코드의 침습적 수정이 필요했고, 컴파일 지연이 심했으며, PyTorch의 네이티브 명령형(eager) 실행을 지원하지 않았다. 분산 컴퓨팅 프리미티브 지원도 뒤처졌다.
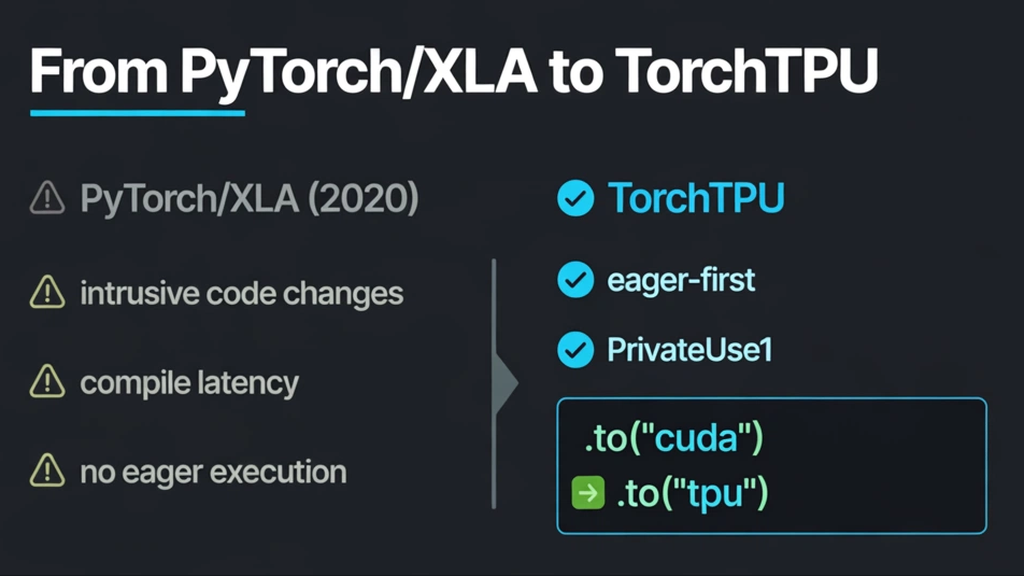
TorchTPU는 eager 실행을 최우선으로 하고 PyTorch의 PrivateUse1 메커니즘 위에 구축됐다. 기존 PyTorch 코드는 .to("cuda") → .to("tpu") 수준의 최소 변경으로 TPU에서 동작한다. 컴파일 경로는 TorchDynamo → StableHLO → XLA로, 디버그는 eager 모드에서 하고 프로덕션 성능은 torch.compile로 전환하는 표준 PyTorch 워크플로우를 그대로 따른다.
import torch

model = load_qwen3_8b()
model = model.to("tpu")          # 기존 .to("cuda")에서 한 글자 차이
# 디버그: eager로 그대로 돌린다
loss = train_step(model, batch)
# 프로덕션: torch.compile으로 TorchDynamo → StableHLO → XLA
model = torch.compile(model)
성능 수치: 52% MFU, 8,192 칩 스케일링
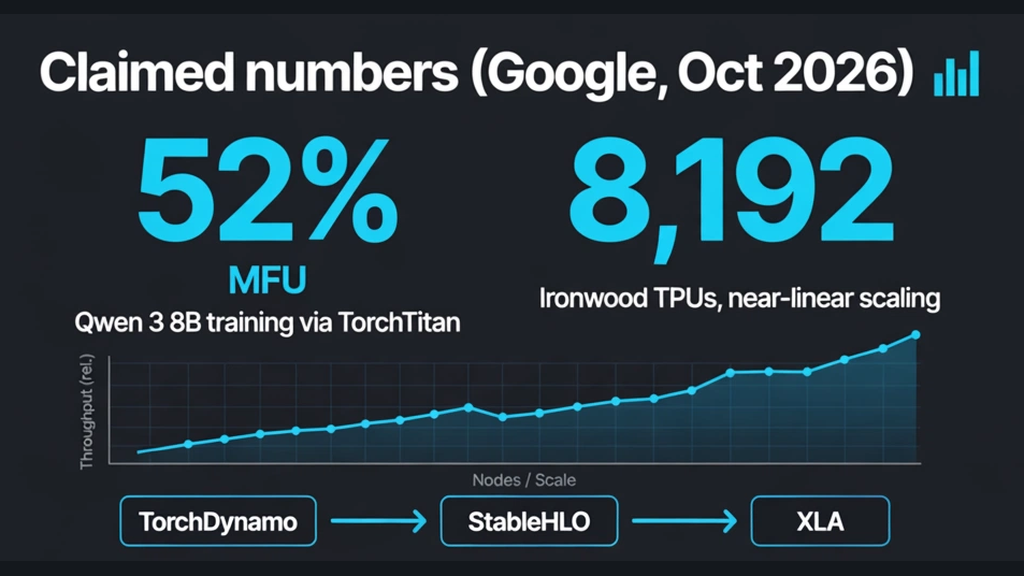
Google이 제시한 두 축의 수치는 의미가 있다. 학습 효율 지표(MFU) 52%는 TPU가 "GPU 대비 싸지만 돌리기 어려운 칩"이라는 인식을 직접 겨냥하고, 8,192 칩 선형 스케일링은 대규모 학습 클러스터 설계에서 TPU를 1순위 후보로 올리는 근거가 된다. 둘 다 사실이라면 GPU 일변도의 학습 인프라 설계에 균열이 생긴다 — "만약"이 아직 붙지만 말이다.
생태계: 학습→서빙→온디바이스 한 줄기
서빙 스택 연동이 이번 발표의 진짜 무게다.
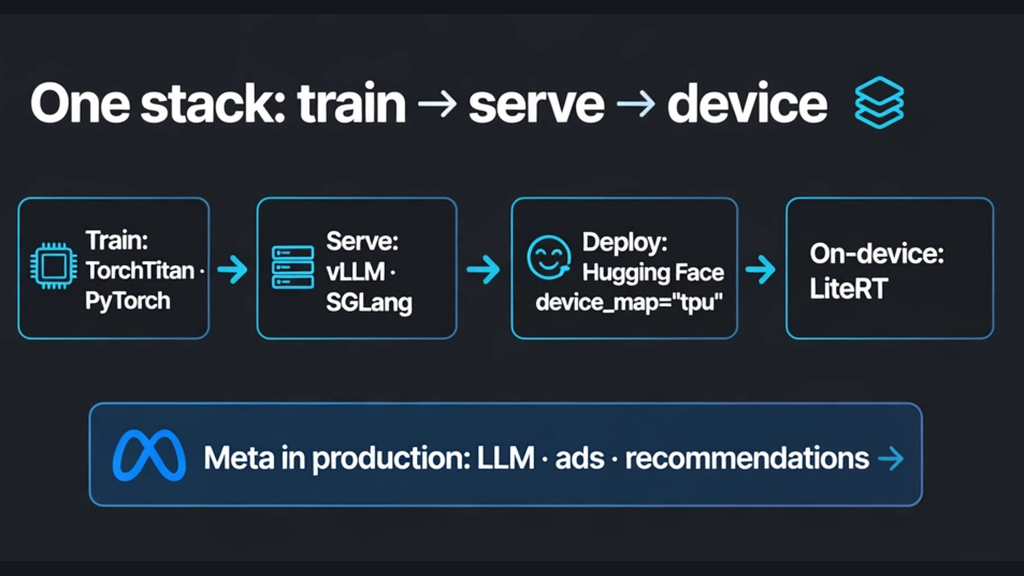
- 서빙: vLLM·SGLang이 각각 vLLM-TorchTPU·SGLang-TorchTPU로 연동. llm-d·TorchTitan·Ray·TorchRec·VeRL·Diffusers도 함께.
- 배포: Hugging Face Transformers v5에서는
device_map="tpu"전달만으로 TPU 배포가 가능하다 (webpronews.com, 2026-10-20). - 온디바이스: LiteRT(구 TFLite)가 PyTorch 생태계에 합류 — 모델 학습→서빙→온디바이스로 이어지는 파이프라인을 PyTorch 단일 스택으로 통일하는 그림.
- 프로덕션 사용: Meta가 실제 프로덕션에서 사용 중. Jana van Greunen(Meta PyTorch 엔지니어링 디렉터)은 "단일 하드웨어 아키텍처에 묶일 수 없다"며 LLM·광고·추천 워크로드를 TorchTPU로 올린다고 밝혔다 (unite.ai). 다만 Meta의 프로덕션 사용 범위(모델 규모·워크로드 비중)는 구체적으로 공개되지 않았다.
- 라이선스: Apache 2.0 (marktechpost.com, 2026-10-20). TPU 에이전트 스위트(온보딩·진단·추론 튜닝 자동화)는 GitHub에서 프리뷰 중.
from transformers import AutoModelForCausalLM

model = AutoModelForCausalLM.from_pretrained(
    "Qwen/Qwen3-8B",
    device_map="tpu",   # Transformers v5: 한 줄로 TPU 배포
)
실무 함의
서빙 스택(vLLM·SGLang)이 TPU를 네이티브로 지원하면, 추론 비용 설계에서 GPU 일변도에서 벗어날 선택지가 생긴다. HF Transformers의 device_map="tpu" 한 줄 지원은 실험 진입 장벽을 크게 낮춘다. 온디바이스(LiteRT가 PyTorch 생태계 합류)까지 같은 흐름이라, 모델 학습→서빙→온디바이스로 이어지는 파이프라인을 PyTorch 단일 스택으로 통일하는 그림이 보인다.
이 글은 ax-trend 이슈 #3377을 바탕으로 작성됐다. 핵심 링크: Google Cloud 블로그 — TorchTPU 오픈소스 발표 (2026-10-20), pytorch.org — TorchTPU 소개 (2026-10-20). 관련 이슈: #3369 — Google·Red Hat·IBM, 분산 LLM 추론 스택 'llm-d 1.0' 출시.