Claude Code 속도 개선: 첫 토큰 지연 4.07초에서 1.33초로 단축한 방법과 전송 최적화
Anthropic의 개발자 공식 계정(@ClaudeDevs)이 2026년 10월 17일 X에 짧은 발표를 올렸다. 내용은 한 줄로 요약하면 "Claude Code가 눈에 띄게 빨라졌다"이다. 별도 릴리스 노트나 블로그 포스트는 없었고, 수치는 Crypto Briefing이 정리했다. 그런데 이 수치들이 꽤 극적이다.
개발자 관점 한 줄 요약: 모델 가중치는 손대지 않고, 전송 경로(gzip)와 시작 시점(프리워밍)만 최적화해 로컬 세션 첫 토큰 p90을 4.07초→1.33초로, 클라우드 세션을 16.99초→6초로 단축했다. 지연 개선의 고전적 교훈 — "네트워크 병목은 프로토콜 최적화로, 콜드스타트는 추측 워밍업으로" — 을 대형 코딩 에이전트에 적용한 사례다.
수치: 구간별로 전부 빨라졌다
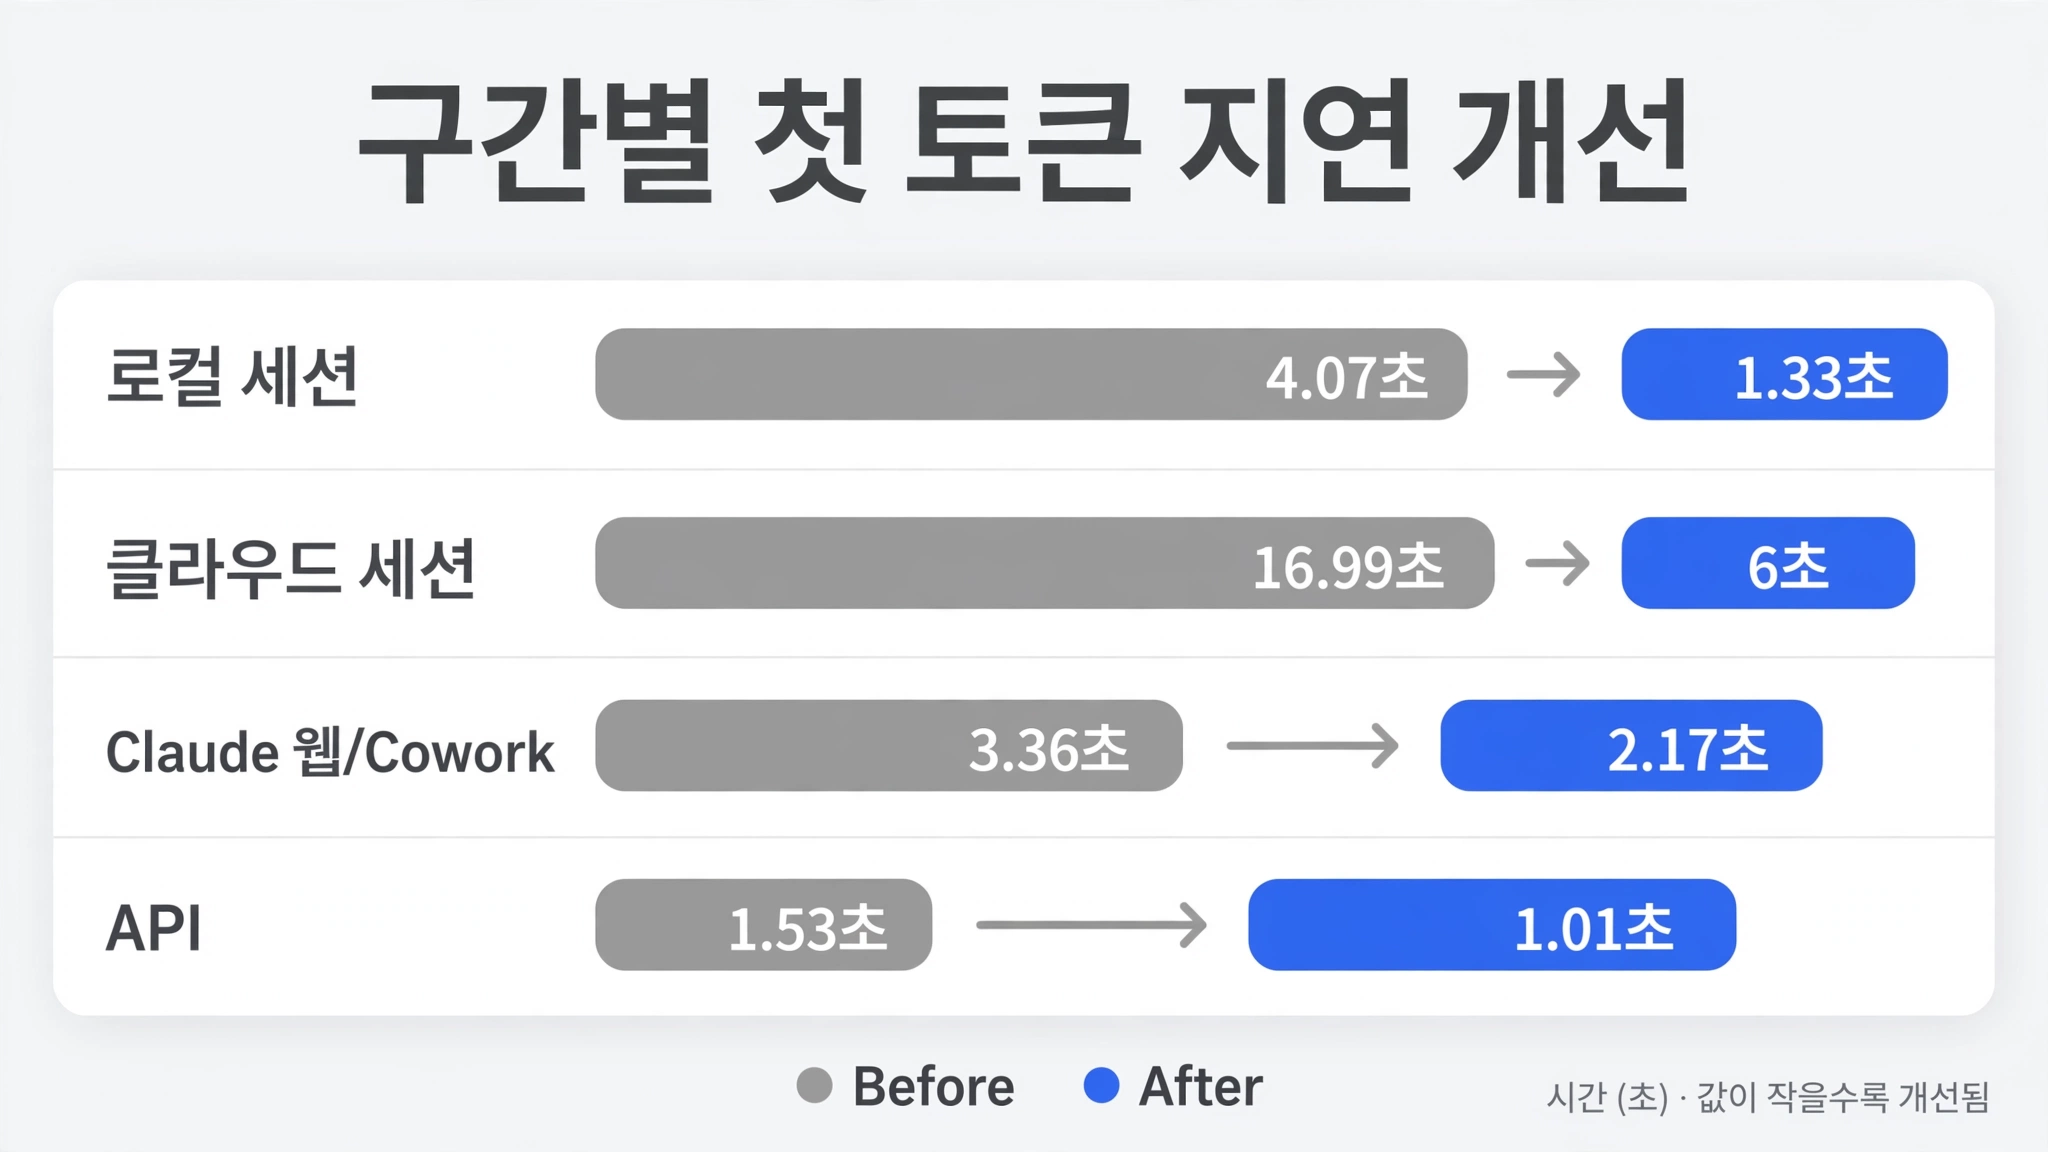
발표된 수치는 2026년 8월부터 10월까지의 변화다:
| 구간 | 이전 | 현재 | 개선 |
|---|---|---|---|
| 로컬 세션 첫 토큰 (p90) | 4.07초 | 1.33초 | 약 3.1배 |
| 클라우드 세션 첫 토큰 | 16.99초 | 6초 | 약 2.8배 |
| Claude 웹 / Cowork | 3.36초 | 2.17초 | 약 1.5배 |
| API 첫 토큰 | 1.53초 | 1.01초 | 약 1.5배 |
특히 클라우드 세션의 16.99초 → 6초는 절대 개선 폭이 11초로 가장 크다. 코딩 에이전트가 "묻고·읽고·고치고·다시 묻기"의 빠른 반복 루프에서 쓰인다는 걸 생각하면, 턴당 11초 절감은 하루 수백 턴에 걸쳐 복합적으로 쌓인다. 16초대 지연은 흐름(flow)을 깨는 수준이지만 6초는 "기다림"으로 받아들일 수 있는 경계선이다.
방법 1: 턴마다 보내는 대화 데이터를 gzip 압축
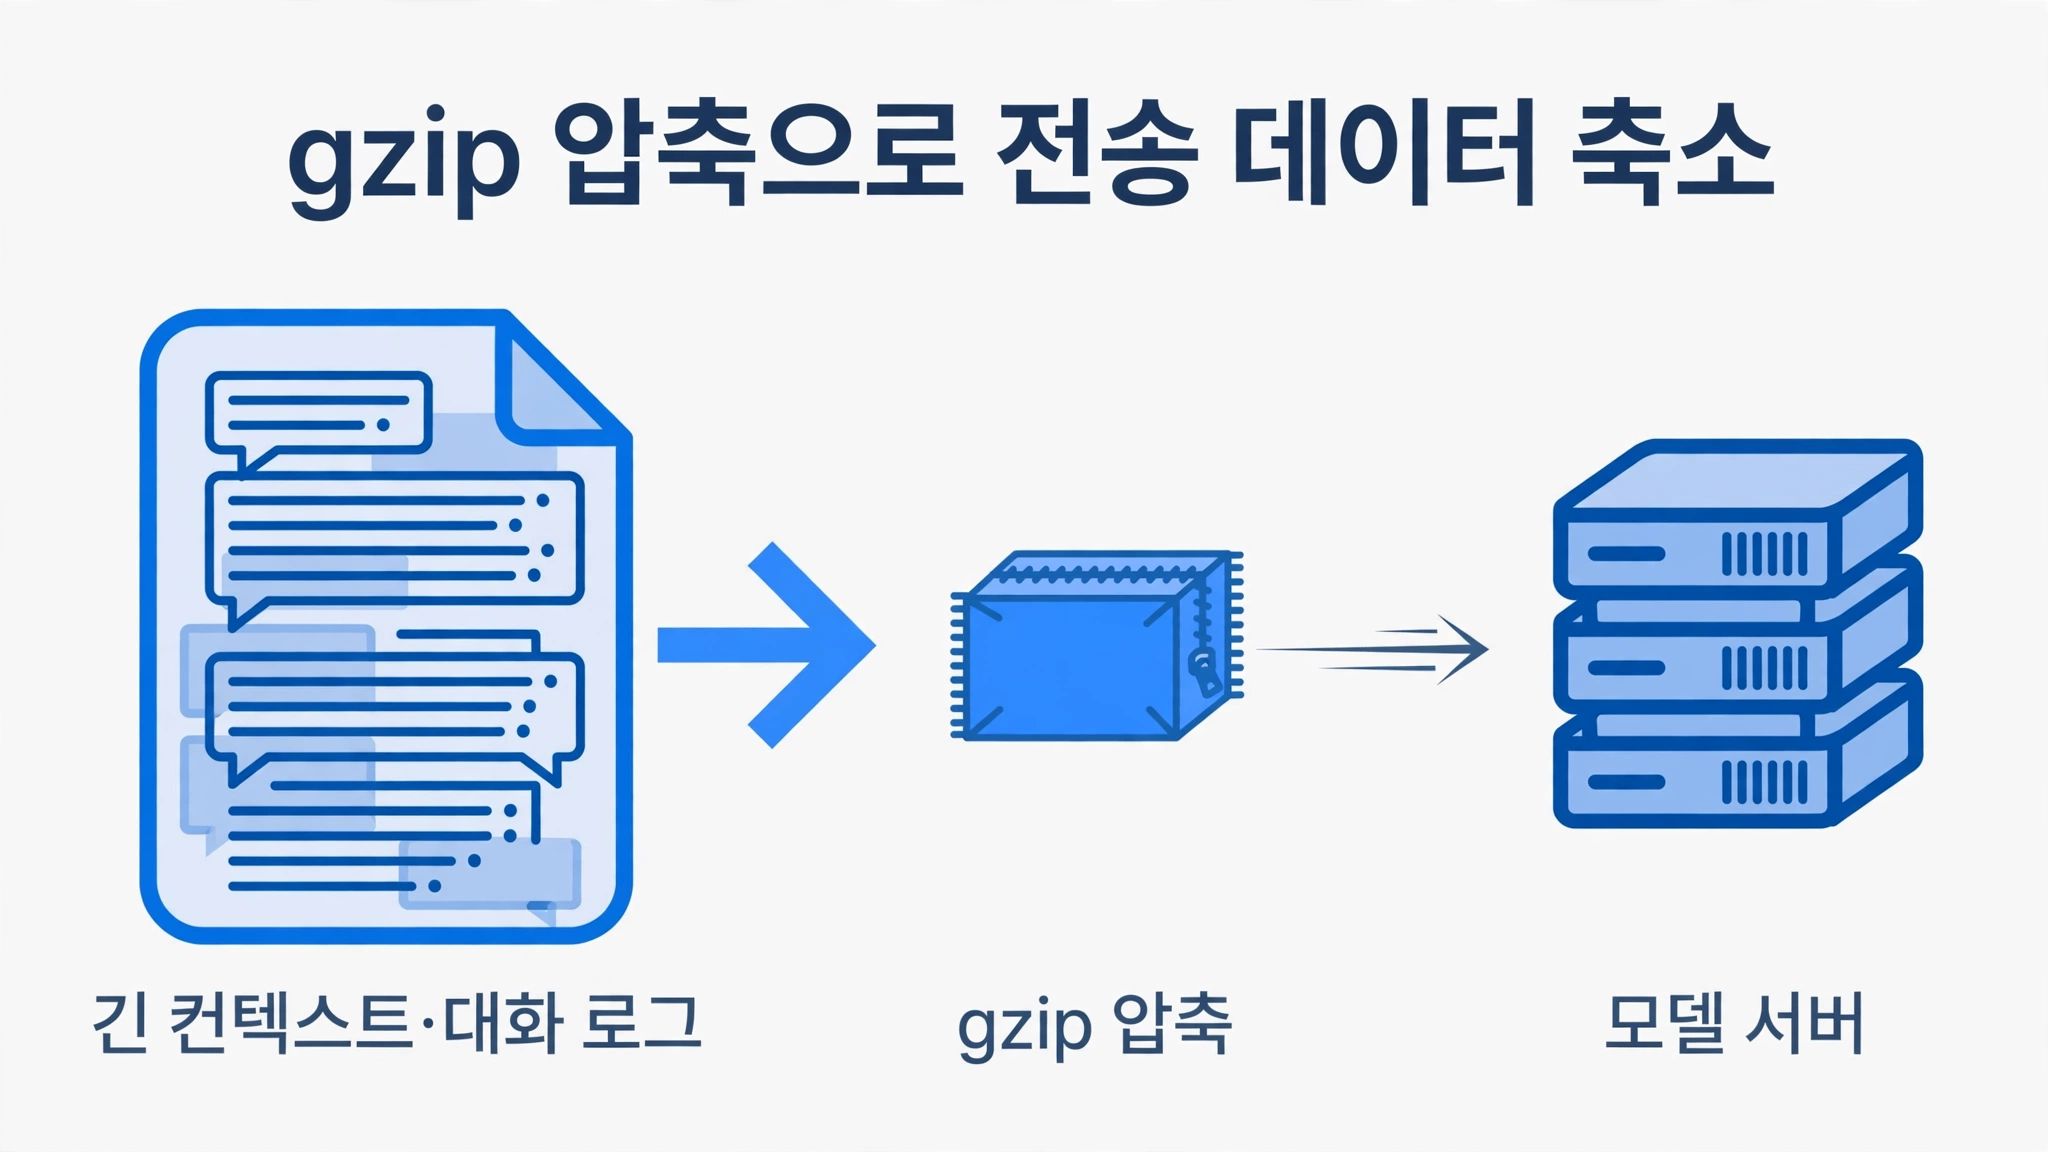
Claude Code는 매 턴마다 누적된 대화 컨텍스트를 모델에 다시 보내는 구조다. 대용량 파일을 읽거나, 긴 로그를 붙여 넣거나, 수십 턴 대화가 쌓이면 페이로드가 수 MB 단위로 불어난다. 업로드 대역폭이 병목이 되면 첫 토큰까지의 시간(TTFT)이 늘어나는 게 당연하다.
Anthropic의 해법은 지극히 고전적이다 — 페이로드를 gzip으로 압축해 전송한다. 텍스트성 컨텍스트는 gzip 압축률이 70~90%에 달하므로, 수 MB 페이로드도 수백 KB로 줄어든다. 구조를 의사코드로 표현하면:
# 턴마다 전송되는 페이로드 압축 (개념적 재구성)
def build_request(messages: list[Message]) -> Request:
    payload = json.dumps(messages).encode("utf-8")
    # 텍스트성 컨텍스트 → gzip 압축률이 70~90%
    compressed = gzip.compress(payload, compresslevel=6)
    return Request(
        body=compressed,
        headers={"Content-Encoding": "gzip"},
    )
흥미로운 점은 이 개선이 긴 컨텍스트에서 가장 크다는 설명이다. 압축의 효과를 예측할 수 있는 곳에 정확히 걸맞는 처방이다 — Claude Code 사용자는 대용량 파일·로그·긴 대화를 붙여 넣는 경우가 일상적이니, 전송량이 줄수록 TTFT 개선 체감도 커진다. 모델 추론 자체를 건드리지 않고도 첫 토큰이 빨라지는 이유다.
방법 2: 사용자가 입력을 "시작하는 순간" 클라우드 세션 프리워밍
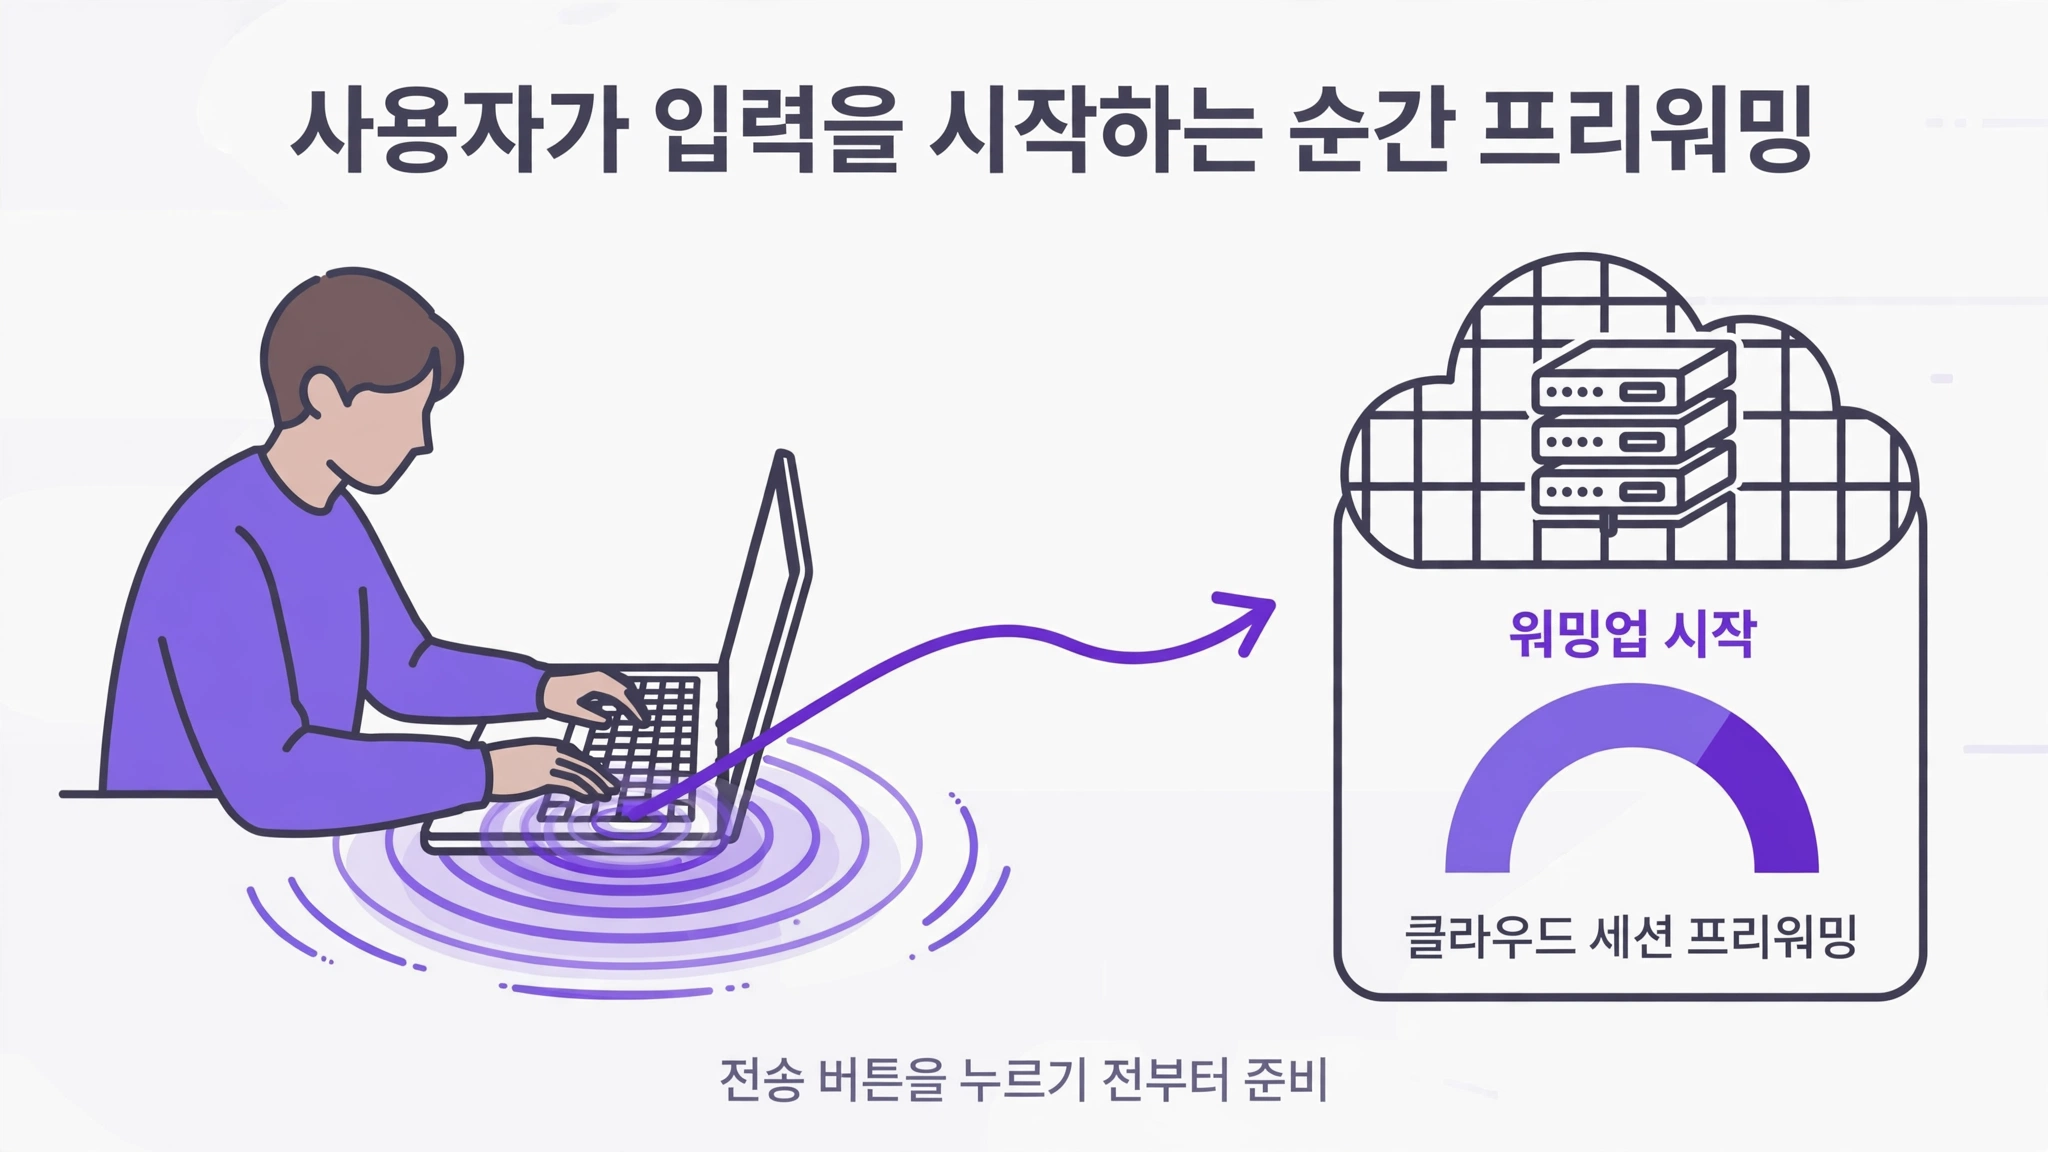
두 번째 수단은 더 교묘하다. 클라우드 세션은 기존에 사용자가 프롬프트를 전송한 뒤에야 워밍업(모델 로딩·컨테이너 준비 등)이 시작됐다. Anthropic은 이를 사용자가 입력창에 타이핑을 시작하는 순간으로 앞당겼다.
타이핑 평균 시간(약 수초~수십 초) 동안 백그라운드에서 세션을 미리 준비해 두면, 전송 버튼을 누르는 순간 콜드스타트 비용이 이미 상쇄된 상태가 된다. 타임라인으로 그리면:
# 프리워밍 타임라인 (개념적 재구성)
# 기존: [타이핑......] → [전송] → [워밍업 6~17초] → 첫 토큰
# 개선: [타이핑......] →  └─ 워밍업 시작 (병렬)
#                       → [전송] → [워밍업 거의 완료] → 첫 토큰
클라우드 세션 16.99초→6초 개선의 핵심이 바로 이것이다. "사용자의 무의미한 대기"를 "유용한 작업과 겹치는 시간"으로 바꾼 것 — 클라이언트 개발자가 익숙한 추측 프리페칭(speculative prefetching) 패턴과 같은 철학이다.
비용의 반대급부: 프리워밍은 사용자가 실제로 전송하지 않는 프롬프트에도 컴퓨팅을 소모한다. 타이핑만 하고 닫아 버린 입력창 하나에도 서버 리소스가 한 번씩 타는 셈이다. 발표에는 이 비용 효율성에 대한 언급이 없었고(Crypto Briefing), 공식 버전 번호·롤아웃 일정도 공개되지 않았다 — 어떤 세션·지역부터 적용되는지는 미확인이다. 6초의 클라우드 대기 시간도 여전히 체감되는 수준이다.
실무 관점: 속도를 제품 기능으로 내세운 전략
이 발표의 시점도 의미심장하다. "Claude Code 코드의 약 90%를 Claude가 작성 중"이라는 소식이 나온 바로 직후다(관련 이슈 #3337). 멀티 세션을 동시에 돌리는 사용자가 늘면서 턴당 응답 속도가 생산성을 직접 좌우하는 병목으로 부상했고, Anthropic은 속도를 제품 기능으로 내세우기 시작했다.
지난 한 달간 내부 성능 스프린트로 Claude 제품군 전반에 3,000건 이상의 업데이트가 적용됐다고 한다 — 이번 개선이 단일 릴리스가 아니라 전사적 성능 투자의 일부라는 신호다. 우리(AX TF·앱 개발자) 관점의 시사점:
- TTFT 최적화의 체크리스트 — API 클라이언트 페이로드 압축, 추측 워밍업, 병렬 초기화. 자사 에이전트·챗봇 앱의 첫 응답 지연에도 그대로 적용 가능한 패턴이다.
- 측정이 곧 기능 — p90 수치로 8월→10월 변화를 공개한 방식 자체가 참고할 만하다. 성능 개선을 릴리스 노트에 수치로 명시하면 사용자 체감이 커진다.
- 장기적 추세 — 에이전트 워크플로우가 보편화될수록 "턴당 지연"이 UX의 핵심 지표가 된다. Android 개발 환경에서도 긴 컨텍스트를 다루는 에이전트가 늘어나고 있어, 전송 경로 최적화는 지금부터 고려할 만한 항목이다.