MicroPerf-Bench: 마이크로서비스 성능 최적화로 코딩 에이전트 실력 재기와 42% 회복 한계
핵심 — 최고 구성도 주입된 성능 저하의 42.0%만 회복했다
- 기존 코딩 벤치마크는 함수·리포지토리 수준 평가에 머물렀다 (arXiv).
- 마이크로서비스에서는 종단간 성능이 독립 실행 서비스 간 상호작용에서 생긴다 (arXiv).
- MicroPerf-Bench는 마이크로서비스 시스템의 종단간 성능 최적화를 평가한다 (arXiv).
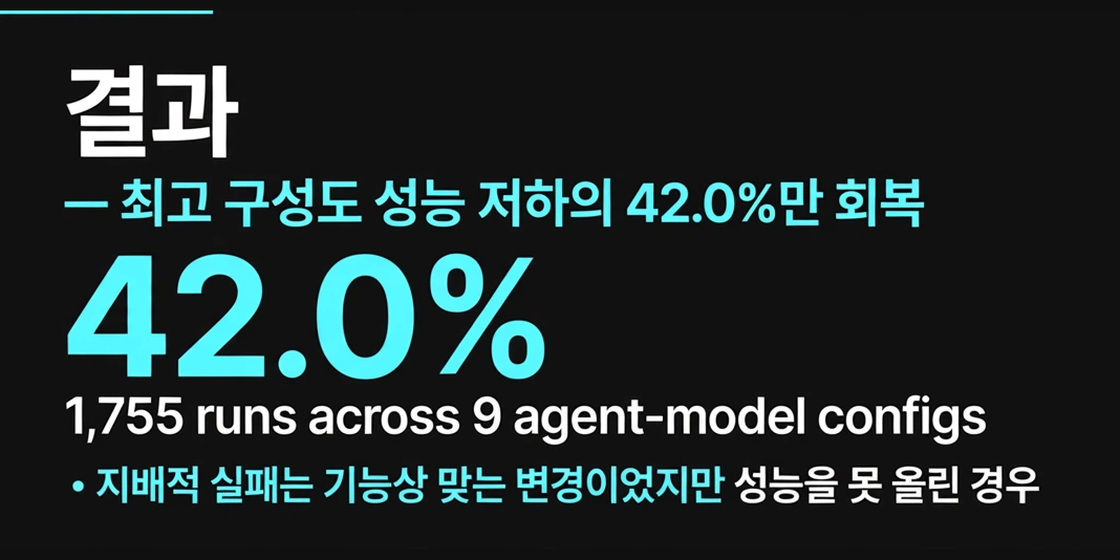
- 9개 에이전트-모델 구성의 1,755회 실행에서 최고 구성도 주입된 성능 저하의 42.0%만 회복했다 (arXiv).
- 코딩 에이전트를 성능 최적화 업무에 투입하기 전에 이 벤치마크로 먼저 재보는 게 순서다. 42.0%라는 수치는 아직 맡기기 이르다는 신호다 (이슈 배경).
방법 — 안티패턴을 실제 시스템에 주입해 재현 가능한 과제를 만든다
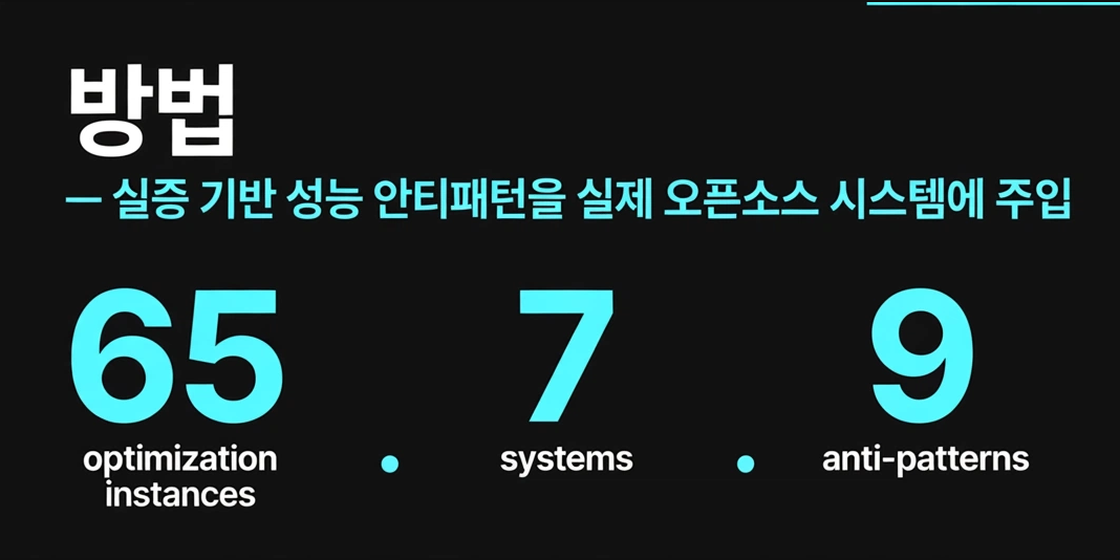
- 실증 기반 성능 안티패턴을 실제 오픈소스 시스템에 주입했다. 기능은 유지하고 측정 가능한 성능 저하를 보장했다 (arXiv).
- 65개 최적화 인스턴스, 7개 시스템, 9개 안티패턴을 담았다 (arXiv).
- 안티패턴을 실제 시스템에 주입해 재현 가능한 성능 수정 과제를 만드는 것이 이 벤치마크의 아이디어다 (이슈 배경).
- 재현 가능한 시스템 수준 성능 수정은 희소하고 귀속이 어려웠다. 그 공백을 메우는 설계다 (이슈 배경).
수치 — 지배적 실패는 '돌아가지만 느린' 변경이었다
- 지배적 실패는 무효 코드가 아니었다. 기능상 맞고 제약을 지키지만 종단간 성능을 못 올리는 변경이었다 (arXiv).
- 이 패턴은 시사하는 바가 크다. 에이전트는 테스트를 통과하는 코드를 쓰지만, 병목이 어디 있는지 못 찾는 것이다.
- 소스코드와 데이터가 공개됐다 (arXiv). 사내 평가에 그대로 가져다 쓸 수 있다.
의미 — '병목을 찾을 수 있는가'가 먼저다
- 코딩 에이전트 평가에서 기능 정답률이 전부는 아니다. 시스템 수준 병목 위치 파악이 핵심 과제다 (이슈 배경).
- 성능 최적화 태스크를 에이전트에 넘기기 전에 이 벤치마크로 병목 위치 파악 능력을 먼저 검증하는 것이 순서다 (이슈 배경).
AX TF 관점. 사내에 코딩 에이전트를 성능 최적화 업무에 투입하기 전, MicroPerf-Bench 65개 인스턴스를 그대로 돌려 현재 구성의 회복률을 측정해둘 가치가 있다 (이슈 배경). 주입된 저하를 기준으로 삼으면, "에이전트가 실제로 빠르게 만든 것"과 "돌아가기만 하는 것"을 구분할 수 있다. 벤치마크 결과가 에이전트 도입의 기준선이 된다.
아직 안 밝혀진 것 — 7개 시스템 명단·9개 구성 명단·안티패턴 대표성
⚠️ 미확인: 7개 시스템·9개 안티패턴의 구체적 명단은 초록에 없다 (arXiv). 9개 에이전트-모델 구성의 명단도 초록에 없다 (arXiv). 주입 안티패턴이 실제 운영 병목을 얼마나 대표하는지는 검증이 필요하다 (이슈 배경). 시스템 수준 병목 위치 파악이 핵심 과제라는 결론의 정량 근거는 논문 본문 확인이 필요하다.
원문 이슈
이 글은 ax-trend 이슈 #3449을 바탕으로 작성됐다. 핵심 링크: arXiv:2610.29695 — MicroPerf-Bench (2026-10-21 제출).