#agentic benchmark
11개의 글
#3479
FrontierCS 2: CS R&D 기여도를 재는 48개 과제의 에이전트 벤치마크와 48개 과제 구조
FrontierCS 2는 논문의 기여도를 지운 코드에서 출발합니다. 동작하는 레포 위에서 패치를 반복 제출하고, 비공개 최종 스위트로 사람 기준과 겨룹니다. 최강 에이전트도 58% 통과에 그친 이유를 정리했습니다.
#3471
UserSWE: 동적 사용자 시뮬레이션으로 멀티턴 코딩 에이전트를 평가한다와 매 턴 테스트 판정
코딩 에이전트 평가를 싱글턴 이슈 리포트에서 실제 버그 수정 대화로. 동적 사용자 시뮬레이션과 매 턴 실행 기반 판정으로 11개 에이전트를 평가한 UserSWE.
#3449
MicroPerf-Bench: 마이크로서비스 성능 최적화로 코딩 에이전트 실력 재기와 42% 회복 한계
MicroPerf-Bench는 마이크로서비스 시스템의 종단간 성능 최적화로 코딩 에이전트를 재는 벤치마크다. 1,755회 실행에서 최고 구성도 주입된 성능 저하의 42.0%만 회복했다.
#3447
Agent Behavior Maps: 에이전트를 실행 없이 행동 궤적으로 위치시키는 지도와 롤아웃 불필요
Agent Behavior Maps는 LLM-하네스 조합을 공유 참조 궤적 위의 중심화된 행동 로그 가능도로 표현한다. 대상 에이전트의 새 환경 롤아웃이 필요 없다. 100개 LLM·4개 환경에서 ALFWorld 기반 좌표가 성능 예측을 지원하고 행동 유사도를 식별했다.
#3445
SysRB: 코딩 에이전트는 시스템 크래시 원인을 아직 제대로 못 읽는다와 크래시 해석 한계
소스 트리 쌍 개입 실험 SysRB에서 최고 코딩 에이전트도 실제 크래시 중 over a quarter를 놓쳤다. 단일 커밋 차이의 트리 쌍 934개로 의심 코드 발견과 진짜 실행 추론을 분리해 재는 벤치마크.
#3444
Self-Report Leakage: 에이전트 자기보고가 완성 판정을 오염시키는 현상와 감사 분리 필요
GUI 에이전트의 자기보고를 감사 판정에서 제외하면 dangerous-misreport 재현율이 Qwen3.5-35B-A3B에서 43.4pp 상승한다. report-trace 감사와 aware/blind 통제 개입으로 누수를 실측한 연구.
#3440
Your Benchmark: 벤치마크는 난이도 위의 경험적 측도라는 진단 연구와 25개 벤치마크 분석
25개 벤치마크를 7개 도메인에서 난이도 축 위에 올려 진단한 연구. 실패 모드 두 가지(measure mismatch·coverage gaps)와 난이도 표적 재작성 알고리즘 BenchFill을 내놨다.
#3378
Microsoft Scope: AI 코딩 에이전트 평가 오픈소스 플랫폼과 DevAx 개념와 평가 개념 제시
Microsoft가 AI 코딩 에이전트 평가 플랫폼 Scope를 오픈소스로 공개했다. 핵심 개념은 DevAx(Developer Agent Experience). 작업과 에이전트 설정(프로필)을 주고 Copilot·Claude Code 같은 기존 에이전트를 반복 투입해 채점하는 구조다
#3342
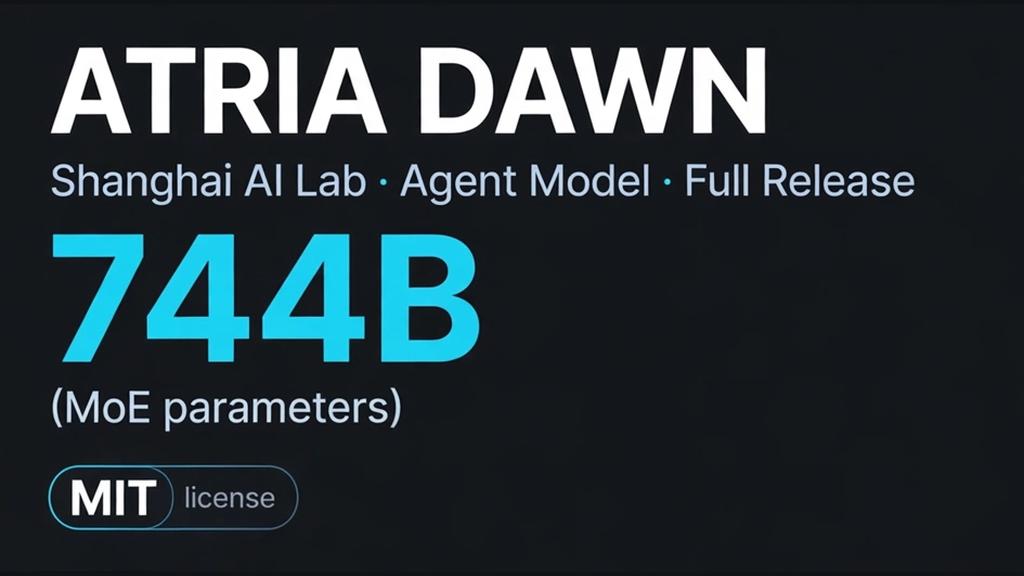
Atria Dawn 정식 버전: 744B MoE 에이전트 모델 MIT 라이선스 공개와 GLM-5.2 기반
Shanghai AI Lab이 에이전트 모델 Atria Dawn의 정식 버전을 공개했다. 744B MoE, 512K 컨텍스트(주장), MIT 라이선스. 다만 정식 가중치는 아직 'Coming soon'이고, 표기 불일치도 있다. 개발자 관점에서 따져본다.
#3341
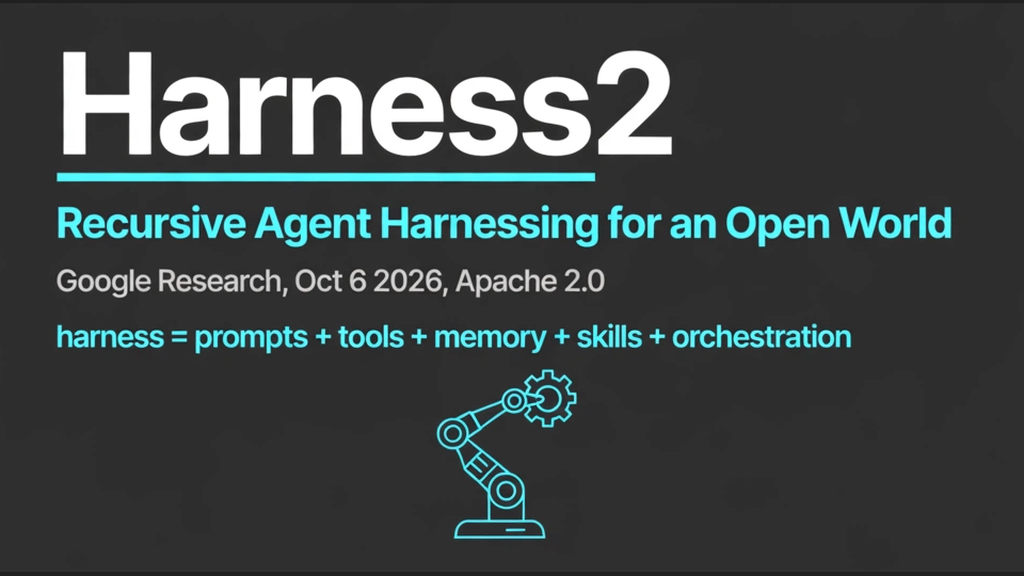
harness2: 하네스 자체를 재귀 최적화하는 프레임워크, 단일 스텝 +11.5점 주장과 구글 공개
Google Research가 에이전트 하네스 자체를 재귀 최적화하는 오픈 프레임워크 Harness²를 공개했다. Propose–Probe–Compose(태스크 수준 재귀)와 improvement harness(하네싱 수준 재귀)의 2단계 구조, 단일 스텝에
#3327
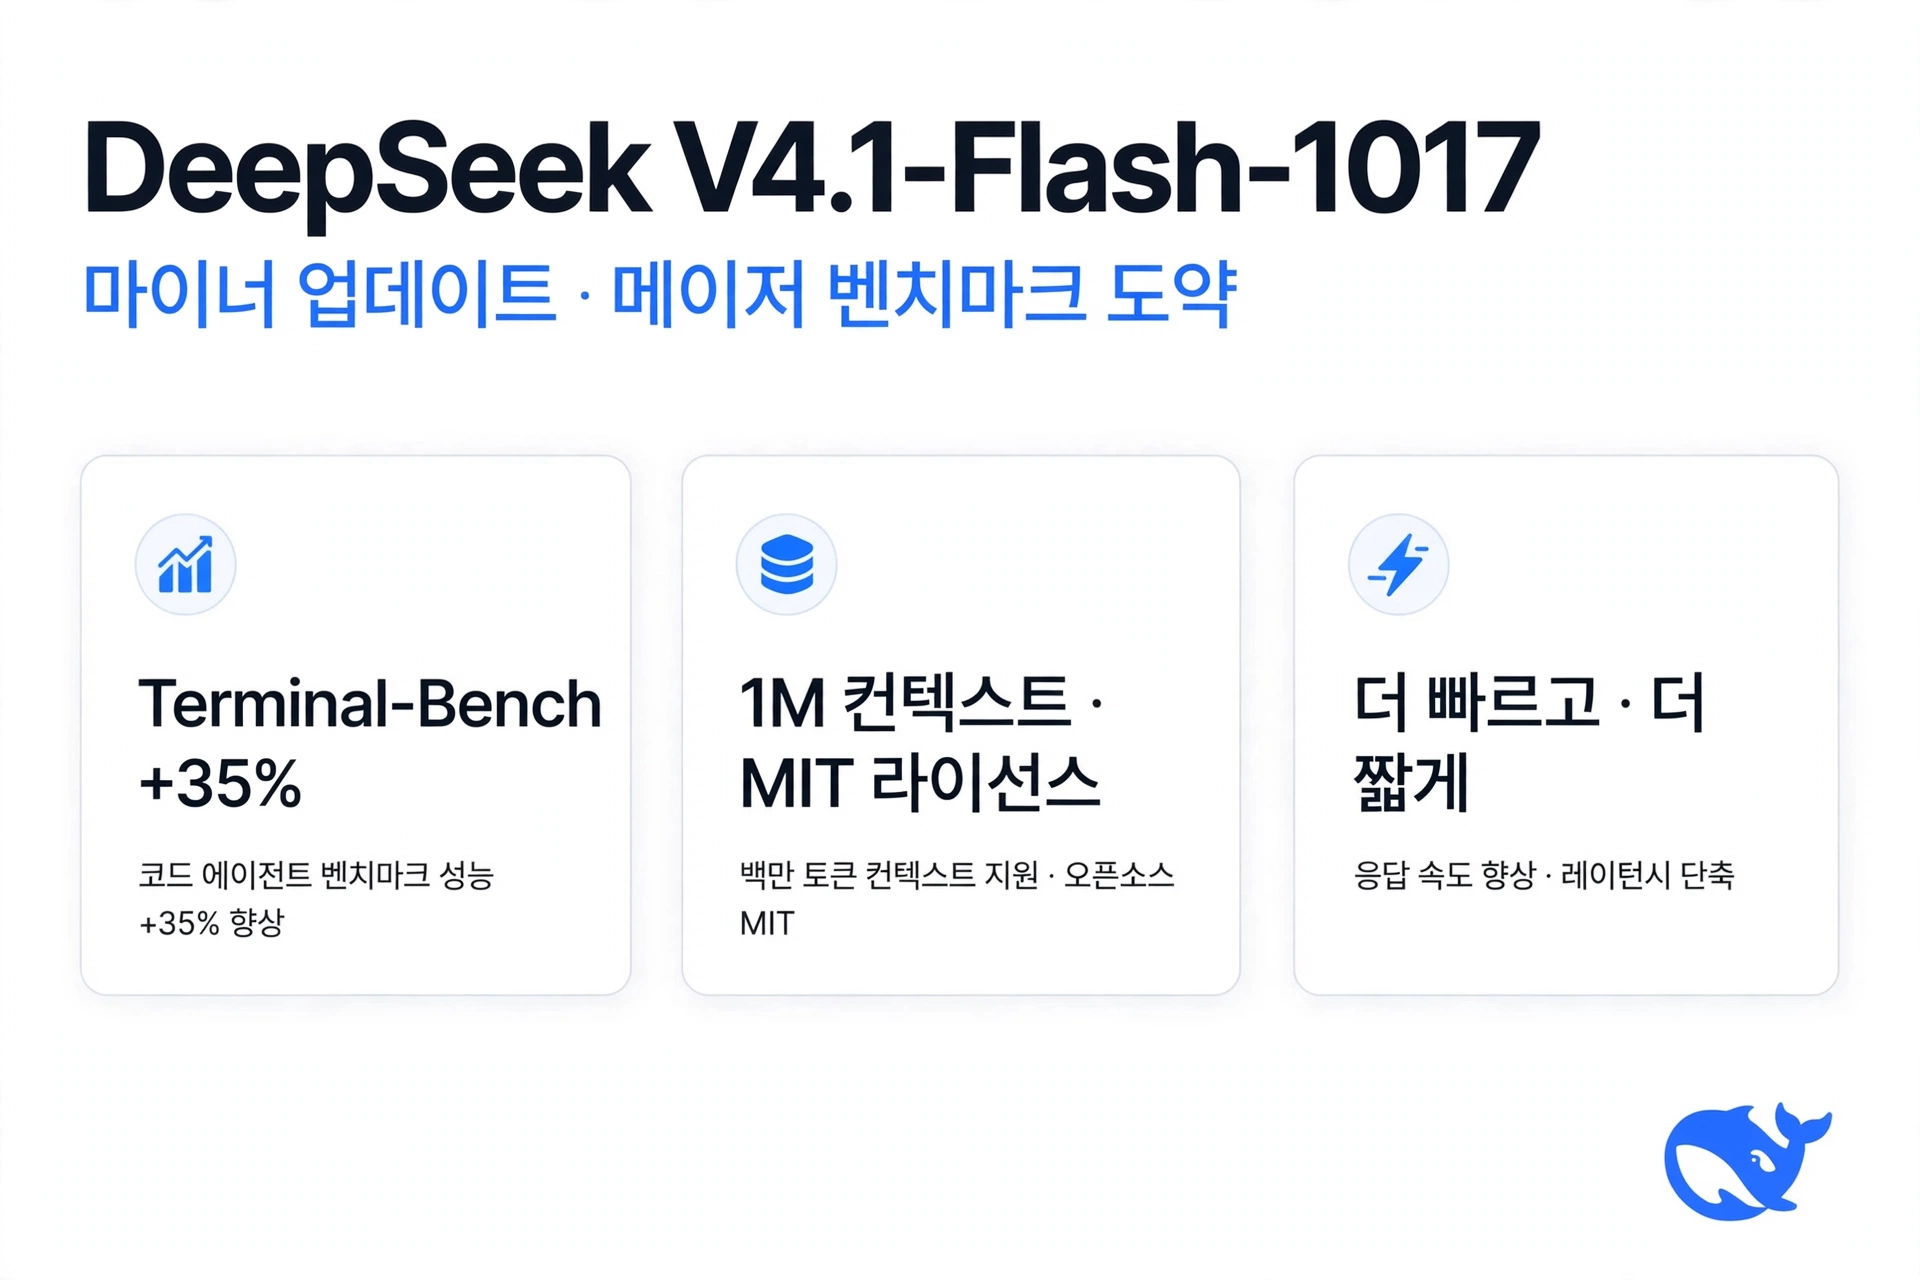
DeepSeek V4.1-Flash 1017: 마이너 업데이트로 Terminal-Bench 35% 향상
DeepSeek가 10월 17일 V4.1-Flash-1017 체크포인트를 MIT 라이선스로 공개했다. 스스로 'minor update'라 불렀지만 Terminal-Bench 42.3(+35%), DeepSWE 77.0으로 GPT-6급·Opus급을 넘나든다. 더 빠르고 짧은 출력