harness2: 하네스 자체를 재귀 최적화하는 프레임워크, 단일 스텝 +11.5점 주장과 구글 공개
에이전트 성능 경쟁의 전선이 모델 가중치에서 하네스로 이동하고 있다. Harness²는 README가 하네스를 이렇게 정의한다: "A harness is the system around a model that enables it to act as an agent: prompts, tools, memory, skills, orchestration, and more. Harnessing is the process of optimizing that system."
지금까지 하네스 최적화는 인간의 수동 튜닝 영역이었다. 프롬프트를 고치고, 툴 설명을 다듬고, 메모리 전략을 바꾸는 일. Harness²는 그 하네스 자체를 재귀 루프에 올리는 plug-and-play 프레임워크다. 모델 가중치는 고정한 채, 두 단계의 재귀를 연결한다.
두 단계 재귀: 태스크 수준 × 하네싱 수준
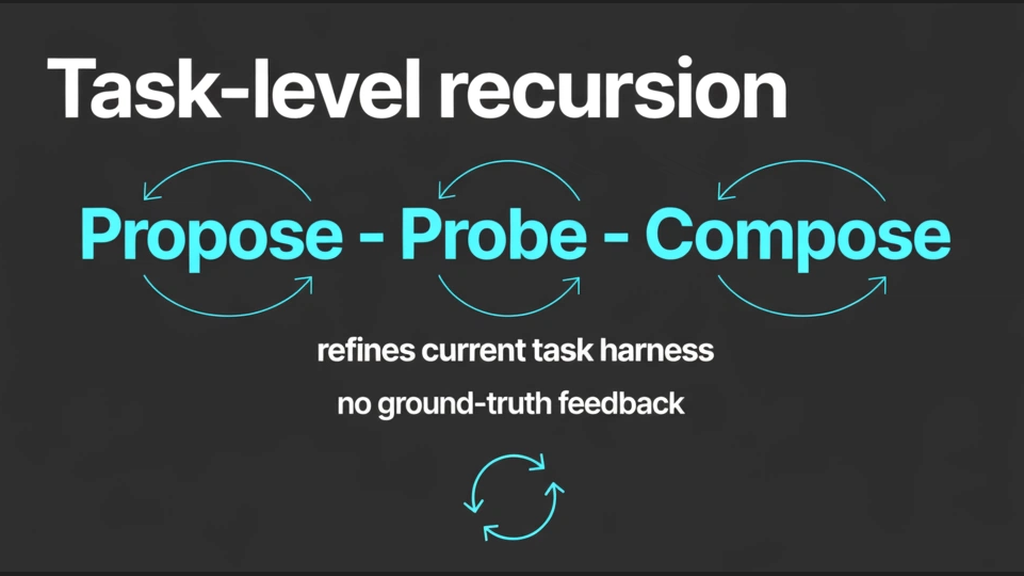
Task-level recursion은 현재 태스크의 실행 하네스를 contrastive Propose–Probe–Compose 단계로 정제한다. 편집안을 제안(propose)하고, 같은 태스크에 그 효과를 투입해 측정(probe)한 뒤, 실행 간 행동 대비(behavioral contrasts)에서 정제된 하네스를 합성(compose)한다. 핵심은 ground-truth 피드백 없이도 동작한다는 점이다.
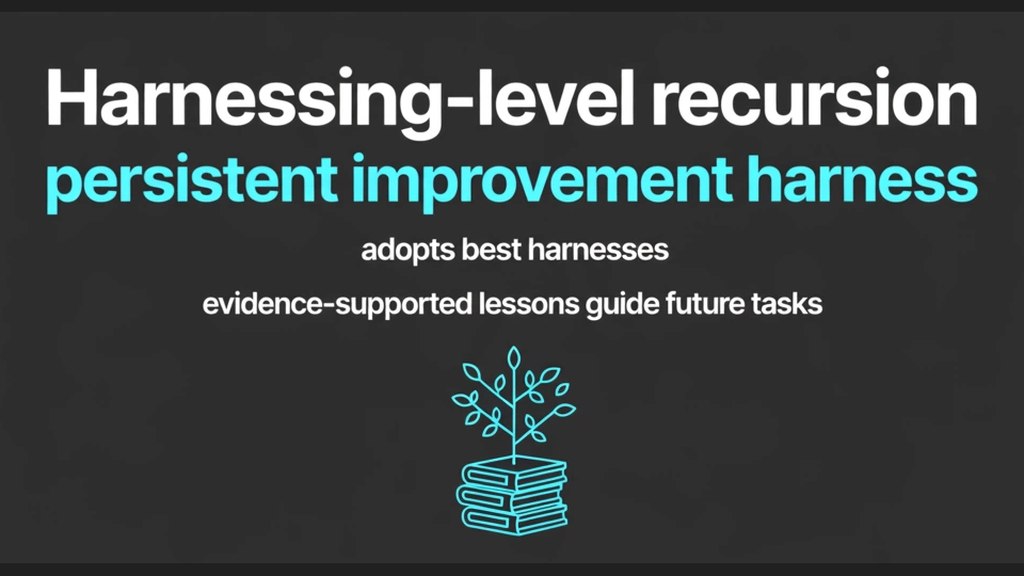
Harnessing-level recursion은 태스크를 넘어선 축적이다. 채택된 하네스와 "evidence-supported lessons"를 persistent improvement harness에 업데이트해서 다음 태스크의 정제를 안내한다. 1단계가 "이 태스크를 더 잘 푸는 법"이라면, 2단계는 "태스크를 풀며 배운 하네스 설계 교훈을 다음에 써먹는 법"이다.
하네스를 코드처럼 다루기: 8개 편집 컴포넌트
Harness²가 편집 대상으로 삼는 하네스 컴포넌트는 8종: system prompt, guardrails, memory, tool guidance, subagents, skills, scripts, plugins. Parallel/sequential recursion을 지원하고, OpenCode·Codex executor를 공식 지원한다 — 코딩 에이전트 워크플로에 바로 얹을 수 있는 이유다.
# 개념적 흐름 (README 발췌·재구성)
# 1. 현재 하네스 = {system_prompt, guardrails, memory,
#                   tool_guidance, subagents, skills, scripts, plugins}
# 2. Task-level: propose(edit_candidates)
#                → probe(each candidate on the SAME task)
#                → compose(refined_harness) from behavioral contrasts
# 3. Harness-level: improvement_harness.update(
#                       adopted_harness, evidence_supported_lessons)

$ uv pip install -e '.[render]'   # Linux · Python 3.12 · uv
설치는 uv pip install -e '.[render]' (Linux, Python 3.12, uv). 벤치마크는 JobBench·LAB·WorkBuddy-Bench 세트, Apache 2.0 라이선스다.
성능 주장: 단일 스텝에 +11.5점 (단, 저자 주장)
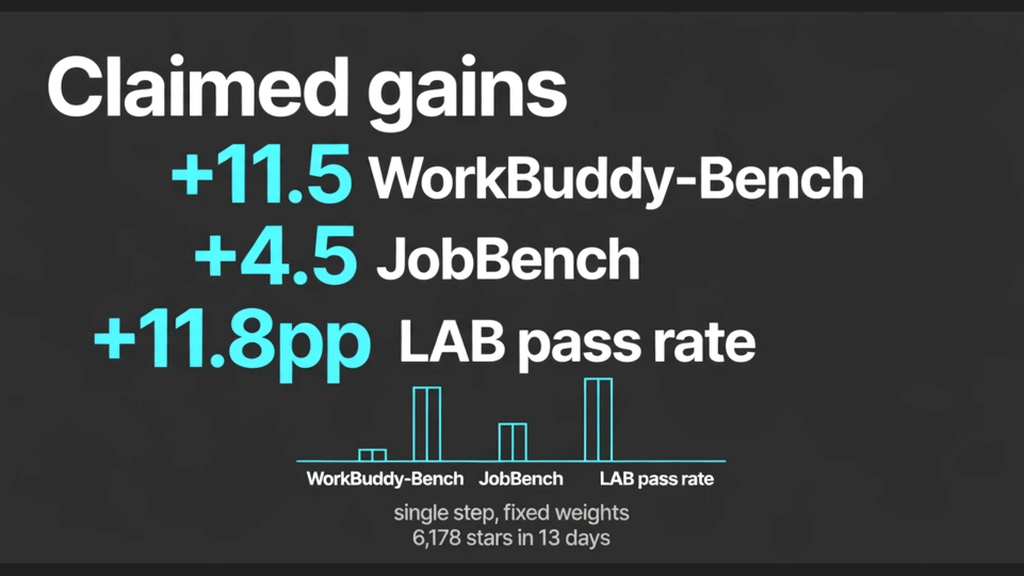
| 벤치마크 | 주장 개선폭 | 비고 |
|---|---|---|
| WorkBuddy-Bench | +11.5 pts | 최대치 |
| JobBench | +4.5 pts | |
| LAB partial pass rate | +11.8pp |
README의 원문: "a single Harness² step improves GLM-5 and Gemini 3.5 Flash over their base harnesses, with gains of up to 11.5 points on WorkBuddy-Bench, 4.5 points on JobBench, and 11.8 percentage points on LAB's partial pass rate." 모델 가중치 변경 없이, 하네스만 갈아끼워서 얻은 수치라는 게 핵심 주장이다.
급성장 중: 13일에 스타 6,178개
공개 약 13일 만에 스타 6,178개, 일평균 약 493개씩 증가하며 급성장 중이다. 배경 맥락도 분명하다: 같은 주에 DeepSeek Harness 데스크톱 앱(#3114)과 플러그인 생태계(#3314·#3267)가 급성장했고, Harness²는 "하네스 자체를 자동 최적화하는" 한 단계 위의 추상화다. Google Research 명의 + arXiv 논문 동시 공개로 학술 신호도 강하다.
AX TF 관점: 하네스 최적화를 수동 튜닝이 아닌 재귀 루프로 돌리는 첫 번째 구글발 오픈 프레임워크다. OpenCode·Codex executor 공식 지원이라 코딩 에이전트 워크플로에 바로 얹을 수 있고, 8개 컴포넌트 구조는 before/after 하네스 비교 시연으로 영상화하기 좋다. Propose–Probe–Compose가 ground-truth 없이 돌아간다는 건, "정답이 없는 태스크에서도 하네스가 스스로 좋아진다"는 뜻 — 에이전트 품질 게이트 설계에 직접 응용 가능하다.
주의 (미확인·쟁점): 벤치마크 수치(11.5점·4.5점·11.8%p)는 저자의 단일 실행 결과이며 제3자 재현 검증이 없다. Propose–Probe–Compose 루프의 실제 토큰 비용·지연 시간은 README에 언급이 없다. GLM-5·Gemini 3.5 Flash 외 다른 모델(Claude·GPT 계열)에서의 효과는 미공개다.
배경·맥락
하네스 전쟁의 다음 단계는 "더 좋은 하네스"가 아니라 "하네스를 자동으로 더 좋게 만드는 하네스"다. DeepSeek가 데스크톱 앱과 플러그인 생태계로 하네스 유통을 선점하는 사이, Google Research는 하네스 최적화 자체를 메타 레벨에서 자동화하는 프레임을 들고 나왔다. 모델이 아니라 모델을 감싸는 시스템을 최적화하는 흐름 — 에이전트 인프라의 경쟁축이 바뀌고 있다는 신호로 읽힌다.