UserSWE: 동적 사용자 시뮬레이션으로 멀티턴 코딩 에이전트를 평가한다와 매 턴 테스트 판정
핵심 — 벤치마크는 개발자처럼 대화하지 않는다
- 기존 벤치마크는 완성된 issue report를 한 턴에 주고 끝낸다. 상호작용 없이 single turn에 complete issue report를 제시하는 방식이다 (arXiv).
- 실제 개발자는 코딩 에이전트와 대화를 주고받으며 버그를 고친다. UserSWE는 바로 이 장면을 평가한다 (arXiv).
- 이 간극 때문에 단일 턴 평가는 false positive와 false negative를 낸다. 틀린 패치를 통과시키거나, 맞는 패치를 떨어뜨린다 (arXiv).
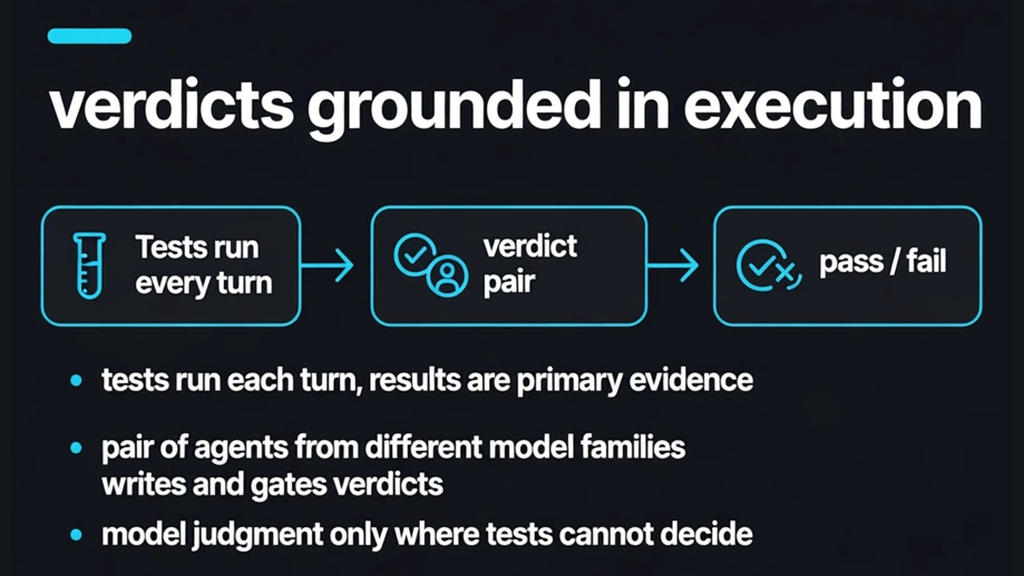
판정은 매 턴 테스트를 돌린다
- 매 턴 execution-grounded verdicts로 판정한다. 테스트가 매 턴 실행된다 (arXiv).
- verdict 작성·게이팅은 서로 다른 model family의 에이전트 한 쌍이 맡는다 (arXiv).
- test results가 1차 근거다. model judgment는 테스트로 해결 안 되는 측면에만 쓴다 (arXiv).
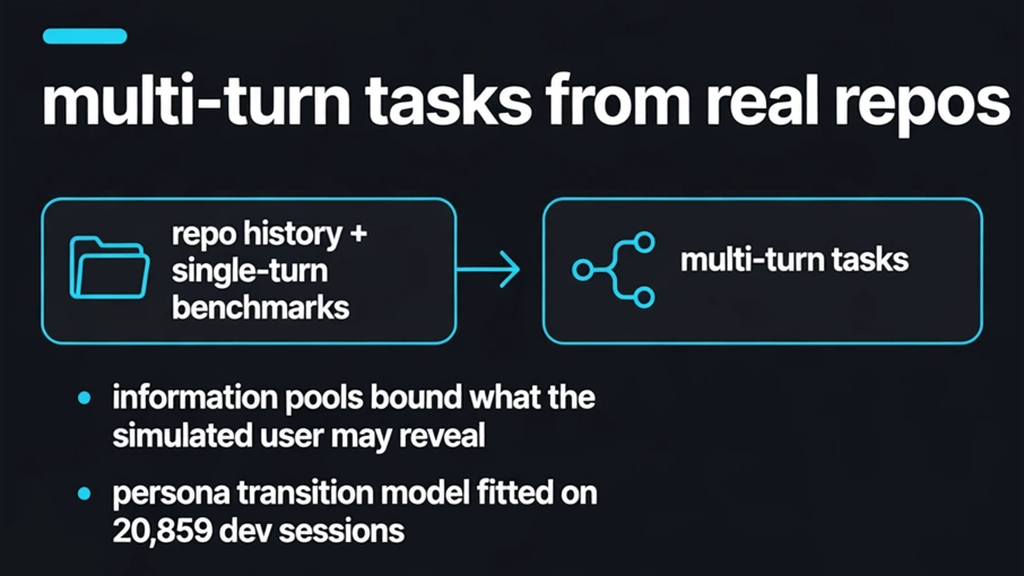
multi-turn 태스크 파이프라인
- 구축 파이프라인은 repository history와 기존 single-turn 벤치마크를 multi-turn 태스크로 바꾼다 (arXiv).
- information pools가 시뮬레이션된 사용자가 밝힐 수 있는 정보를 제한한다. 사용자가 모든 정보를 한 번에 주지 않게 설계한 장치다 (arXiv).
- persona chain은 20,859 development sessions으로 보정한 transition model에서 샘플링한다 (arXiv).
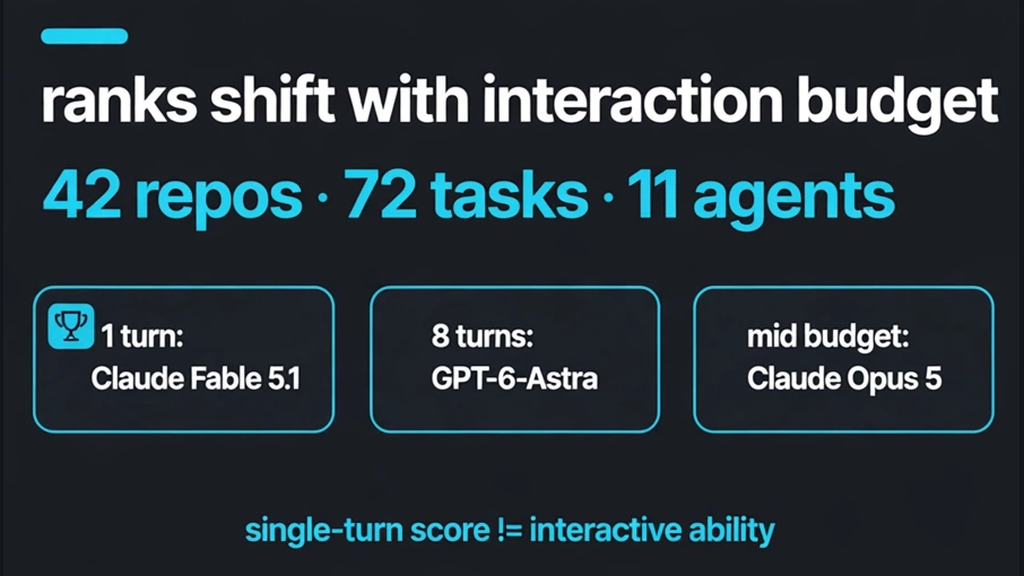
상호작용 예산에 따라 순위가 바뀐다
- 42개 repository의 72개 태스크에 11개 에이전트를 평가했다 (arXiv).
- Claude Fable 5.1은 1턴에서 최다 해결했다 (arXiv).
- GPT-6-Astra는 8턴까지 최다를 기록했다 (arXiv).
- Claude Opus 5는 중간 budget 다수를 리드했다 (arXiv).
single-turn performance로는 interactive coding ability를 설명할 수 없다는 게 논문의 지적이다. 턴 수가 허용되는 순간 순위가 바뀌니, 벤치마크 점수 한 줄로 에이전트를 고르면 안 된다.
왜 중요한지 — 도입 평가의 기준을 바꿔라
코딩 에이전트를 실무에 도입할 때 벤치마크 단일 턴 점수만 보면 안 된다. 우리 사용 패턴이 짧은 수정 요청 위주인지, 긴 디버깅 대화 위주인지에 따라 봐야 할 순위가 달라진다. 평가할 때는 1턴·8턴·중간 budget의 순위를 함께 보고, 우리 사용 패턴에 맞는 에이전트를 골라야 한다 (이슈 배경).
아직 안 밝혀진 것
- 42개 repository의 언어·규모 분포는 미확인이다.
- persona transition model의 구체 구조는 미확인이다.
- verdict pair를 구성한 model family의 조합은 미확인이다.
- multi-turn task 변환 파이프라인의 재현 가능성(코드 공개 여부)은 미확인이다.