FrontierCS 2: CS R&D 기여도를 재는 48개 과제의 에이전트 벤치마크와 48개 과제 구조
연구의 현장을 무대로 올리다 — 문제 진술 하나로 끝나던 평가를 넘어서
“에이전트가 연구에 기여할 수 있는가”라는 질문은, 사실 벤치마크 설계 문제이기도 합니다. 기존 방식은 문제 진술을 주고, 실행이 끝난 뒤 프로그램 하나를 채점했습니다. 연구 과정과는 거리가 멀죠.
실제 연구는 동작하는 코드베이스 위에서 진행됩니다. 가설을 세우고, 반복 제출하며, 비공개 기준으로 평가받습니다. FrontierCS 2는 바로 그 구조를 재현합니다. 48개 open-ended task로 “LLM 에이전트가 frontier CS R&D에 기여할 수 있는가”를 묻습니다.
무대가 달라지면 측정의 의미도 달라지지 않을까요? 답 하나가 아니라, 연구의 과정 자체를 보는 평가라는 점이 이 벤치마크의 출발점입니다.
- 기존 방식: 문제 진술 제시 후, 종료 시점의 프로그램 1개만 채점합니다.
- FrontierCS 2 방식: 동작하는 레포 위에서 반복 제출하고, 비공개 기준으로 평가합니다.
- 다루는 범위: 13개 도메인으로, 머신러닝 시스템과 고성능 컴퓨팅부터 데이터베이스, 보안, 로보틱스까지 아우릅니다.
삭제된 코드가 곧 과제다 — 논문을 지우고, 레포를 남긴다
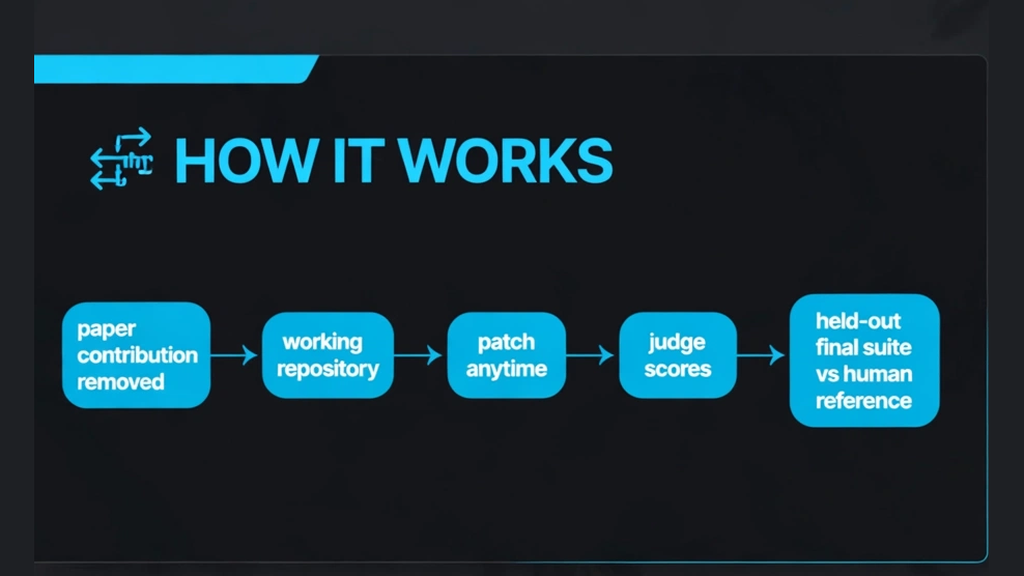
과제 만드는 법부터가 독특합니다. 논문과 공개 코드를 가져온 뒤, 논문의 기여도(contribution)를 삭제합니다. 삭제된 코드가 곧 사람 기준(human reference)이 됩니다.
에이전트는 연구 환경 안에서 동작하는 레포(working repository)를 물려받습니다. 언제든 패치를 제출할 수 있고, 패치마다 심사(judge)가 개발용 스위트 점수(development-suite score)를 돌려줍니다.
다만 평가자(evaluator)와 최종 보류 스위트(held-out final suite), 기준(reference)은 비공개입니다. 최종 제출은 보류 스위트에서 기준과 겨뤄 채점됩니다. 공개된 채점 기준에 맞추는 게임이 아니라, 끝까지 가려진 기준에 도전하는 구조죠.
- 출발점: 논문 + 공개 코드에서 기여도를 삭제한 상태입니다.
- 기준: 삭제된 코드가 사람 기준이 됩니다.
- 진행: 동작하는 레포를 물려받아, 언제든 패치를 제출합니다.
- 피드백: 패치마다 심사가 개발용 스위트 점수를 돌려줍니다.
- 최종 판정: 비공개 최종 스위트에서 기준과 겨룹니다.
58%라는 천장 — 최강 에이전트도 절반 남짓에 그쳤다
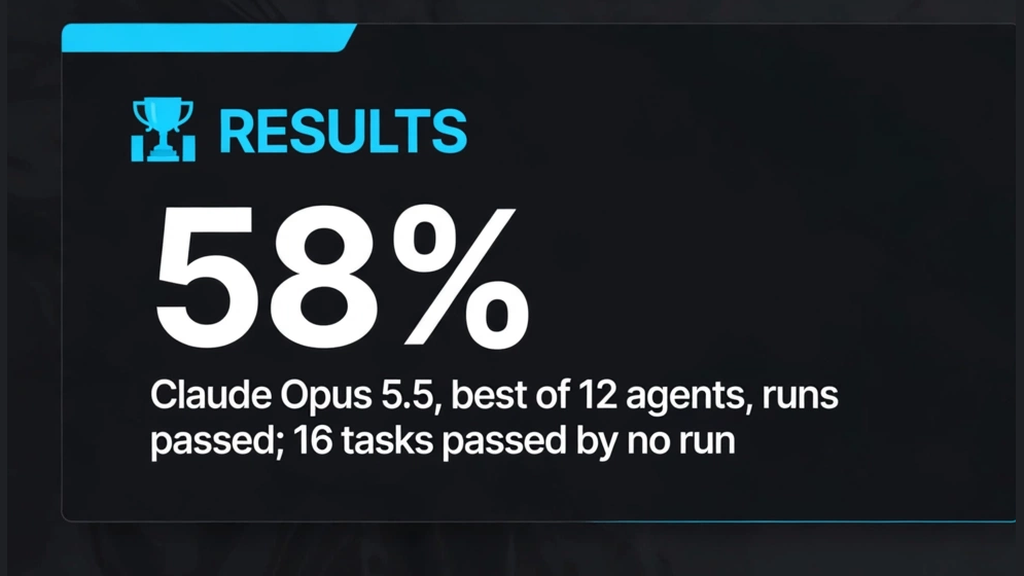
평가한 에이전트는 12개입니다. 가장 좋은 결과는 Claude Opus 5.5로, 실행(runs)의 58%를 통과했습니다. 절반을 조금 넘는 수준이죠.
더 눈에 띄는 숫자는 따로 있습니다. 16개 과제는 어떤 실행도 통과하지 못했습니다. 그리고 과제 난이도의 중앙값(median)은 최강 에이전트가 감당 가능한 수준과 비슷하다고 합니다.
이 두 문장을 함께 읽으면 그림이 잡힙니다. 최강 모델도 과제의 절반 언저리에 머물고, 아예 뚫리지 않은 과제가 3분의 1이나 됩니다. “연구 기여”라는 말이 아직은 천장에 닿아 있다는 뜻 아닐까요?
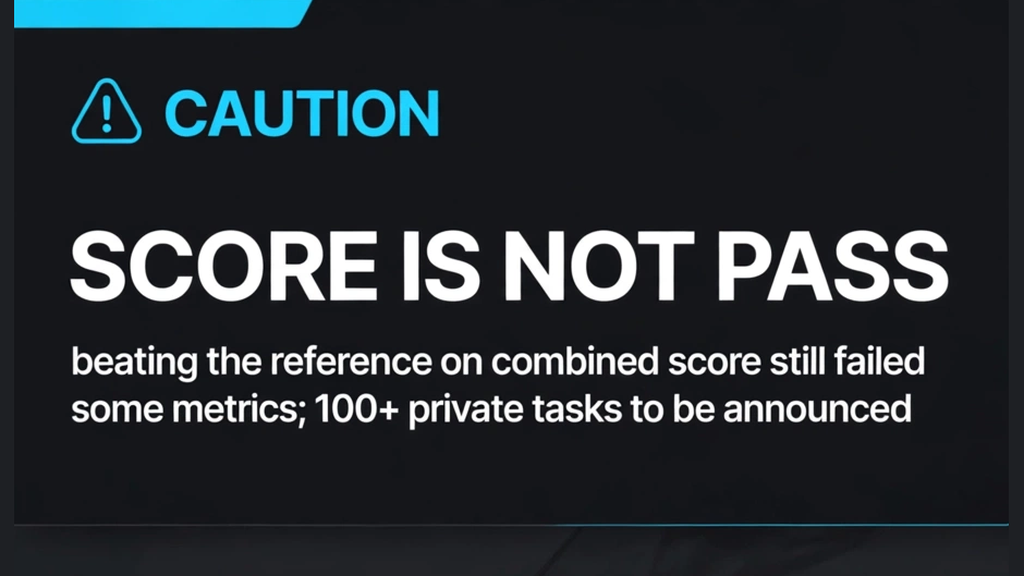
점수가 높다고 통과는 아닙니다. 종합 점수에서 기준을 이긴 실행 대부분도, 일부 지표나 워크로드에서는 미달했습니다.
이 대목이 이 벤치마크를 단순한 순위표와 갈라놓습니다. 높은 점수와 통과는 같은 말이 아니었습니다. 종합 최종 점수에서 기준을 이긴 실행 대부분도 일부 지표나 워크로드에서 미달했기 때문입니다.
아직 가려진 것들 — 기준을 끝까지 숨기는 설계의 대가
설계상 비공개가 많다 보니, 확인되지 않은 항목도 뚜렷합니다. 섣불리 메우지 않고, 미확인으로 남겨두는 편이 맞습니다.
- 평가한 12개 에이전트 중 최고 외 명단은 미확인입니다. 누가 어떻게 겨뤘는지 전체 그림은 아직 없습니다.
- 각 패치를 채점하는 심사의 구체 채점 방식은 미확인입니다. 개발용 스위트가 무엇을 어떻게 재는지 알 수 없습니다.
- 13개 도메인 전체의 목록은 미확인입니다. 예시로 든 분야 외의 나머지 도메인은 밝혀지지 않았습니다.
- 100개가 넘는 비공개 과제(private set)의 공개 시점은 미확인입니다. 향후 공개 예정이며, “to be announced in the future”라는 표현만 있습니다.
우리 팩토리에 무엇을 가져올까 — 기대치를 숫자로 세우는 일부터
이슈 본문이 짚은 실무적 가치는 기대치 설정입니다. “중앙값 과제의 난이도가 최강 에이전트 수준과 비슷하다”는 문장은, 에이전트 도입 시 어디까지 기대할지의 근거가 됩니다.
우리 팩토리에도 바로 적용할 수 있는 잣대가 있습니다. 에이전트를 어디까지 쓰고, 어디부터 사람이 개입해야 할지를 가늠하는 기준 말입니다. 종합 점수가 기준을 넘었다고 곧바로 통과로 받아들이지 않는 태도도 마찬가지입니다. 지표별, 워크로드별로 미달이 없는지를 따로 확인해야 합니다.
다만 아직은 벤치마크의 선언에 가깝습니다. 비공개 스위트와 심사 방식이 가려진 상태에서는, 우리 환경에서 직접 재보는 것이 순서겠죠. 숫자는 가져오되, 판단은 우리 과제로 검증하는 게 맞지 않을까요?