DeepSeek V4.1-Flash 1017: 마이너 업데이트로 Terminal-Bench 35% 향상
DeepSeek 공식 org가 10월 17일 Hugging Face에 DeepSeek-V4.1-Flash-1017을 공개했다 (HF API createdAt: 2026-10-17T02:40:38Z, MIT 라이선스). 모델 카드 표현은 겸손하다 — "minor update to DeepSeek-V4.1-Flash". 그런데 숫자 테이블을 펼치면 minor라고 부르기 민망한 구간이 나온다. agentic 벤치마크 전반에서 전임 대비 두 자릿수 도약, 일부 항목은 프론티어급을 넘나든다.
개발자 관점 한 줄 요약: 코딩 에이전트의 파일 탐색·터미널 작업을 "더 빠르고 더 짧게" 처리하는 MIT 오픈 모델의 새 체크포인트. Terminal-Bench 42.3(+35%), DeepSWE 77.0(GPT-6·Opus급 상회)이라 하네스 실험대에 올릴 만한 후보가 생겼다. 벤치마크는 전부 자사 측정이라는 전제는 달아둔다.
벤치마크: 'minor'라는 표현이 무색한 구간
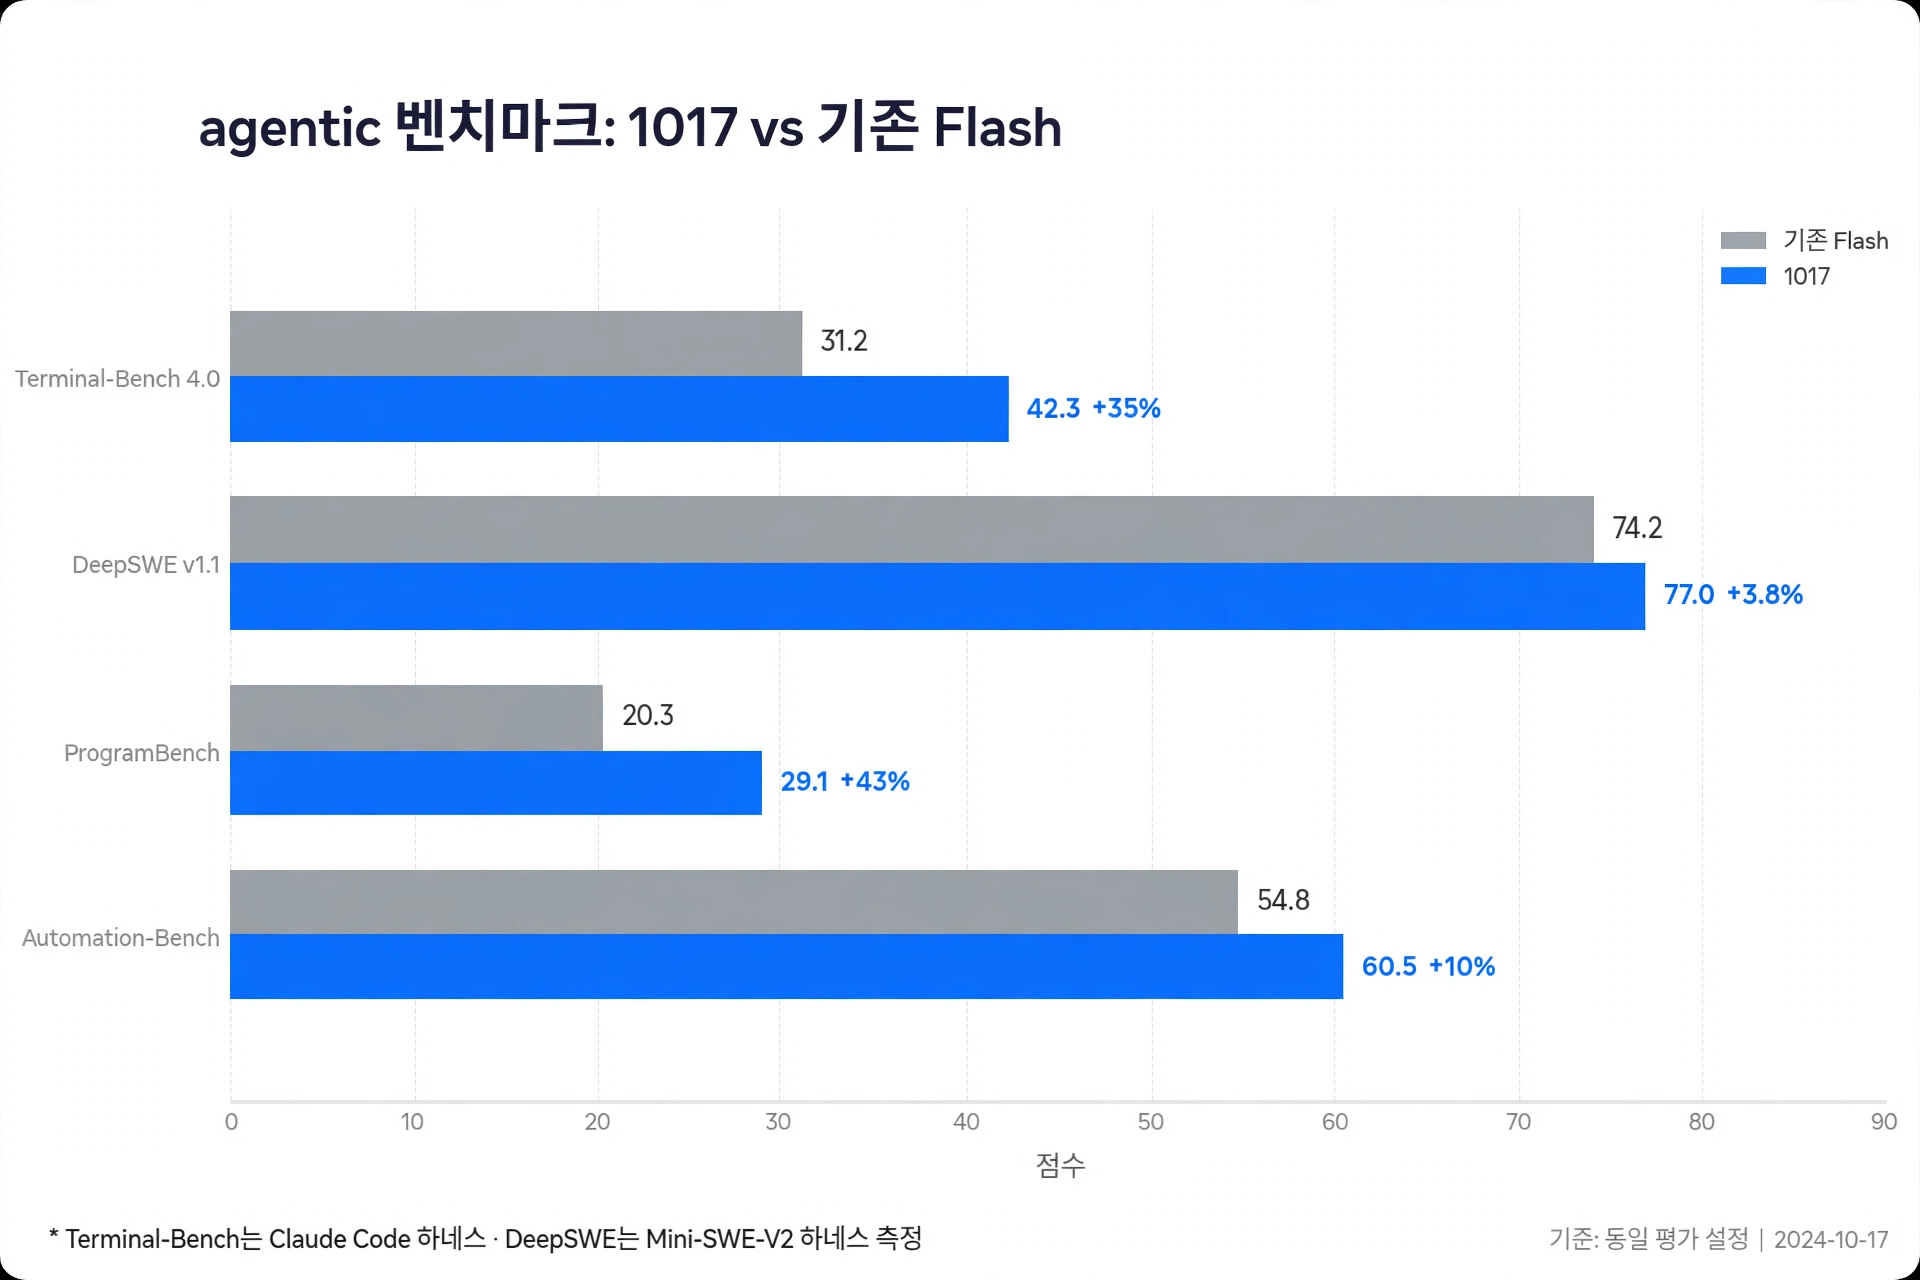
| 벤치마크 | 기존 Flash | 1017 | 경쟁 모델 참고값 |
|---|---|---|---|
| Terminal-Bench 4.0 | 31.2 | 42.3 (+35%) | GPT-5.6 Sol 39.9 · Opus 5 51.8 |
| DeepSWE v1.1 | 74.2 | 77.0 | GPT-5.6 Sol 73.0 · Opus 5 74.0 |
| ProgramBench | 20.3 | 29.1 | — |
| Automation-Bench v1.0.6 | 54.8 | 60.5 | — |
| NL2Repo-Bench | 65.4 | 68.2 | — |
| HLE w/o tools | 36.8 | 42.6 | GPT-5.6 Sol 44.5 · Opus 5 56.3 |
| BabyVision (w/tools) | 89.6 | 92.5 | — |
| ZeroBench-main (w/tools) | 49.0 | 51.0 | — |
두 가지 포인트가 눈에 띈다. 첫째, Terminal-Bench 4.0이 Claude Code 하네스에서, DeepSWE v1.1이 Mini-SWE-V2 하네스에서 측정됐다는 점 — "실제 에이전트 하네스에서의 수행 능력"을 주장하는 셈이다. 둘째, "complete tasks faster and at lower cost" — 벤치 점수만이 아니라 태스크 실행 시간과 출력 길이를 줄여 "여러 에이전트 하네스에서 성능-비용 파레토 프론티어를 전진시켰다"고 명시했다. agentic 워크로드 비용 최적화를 고민하는 팀이라면 이 문장에 밑줄을 그어야 한다.
인코딩이 바뀌었다: Jinja 아웃, Python 레퍼런스 인
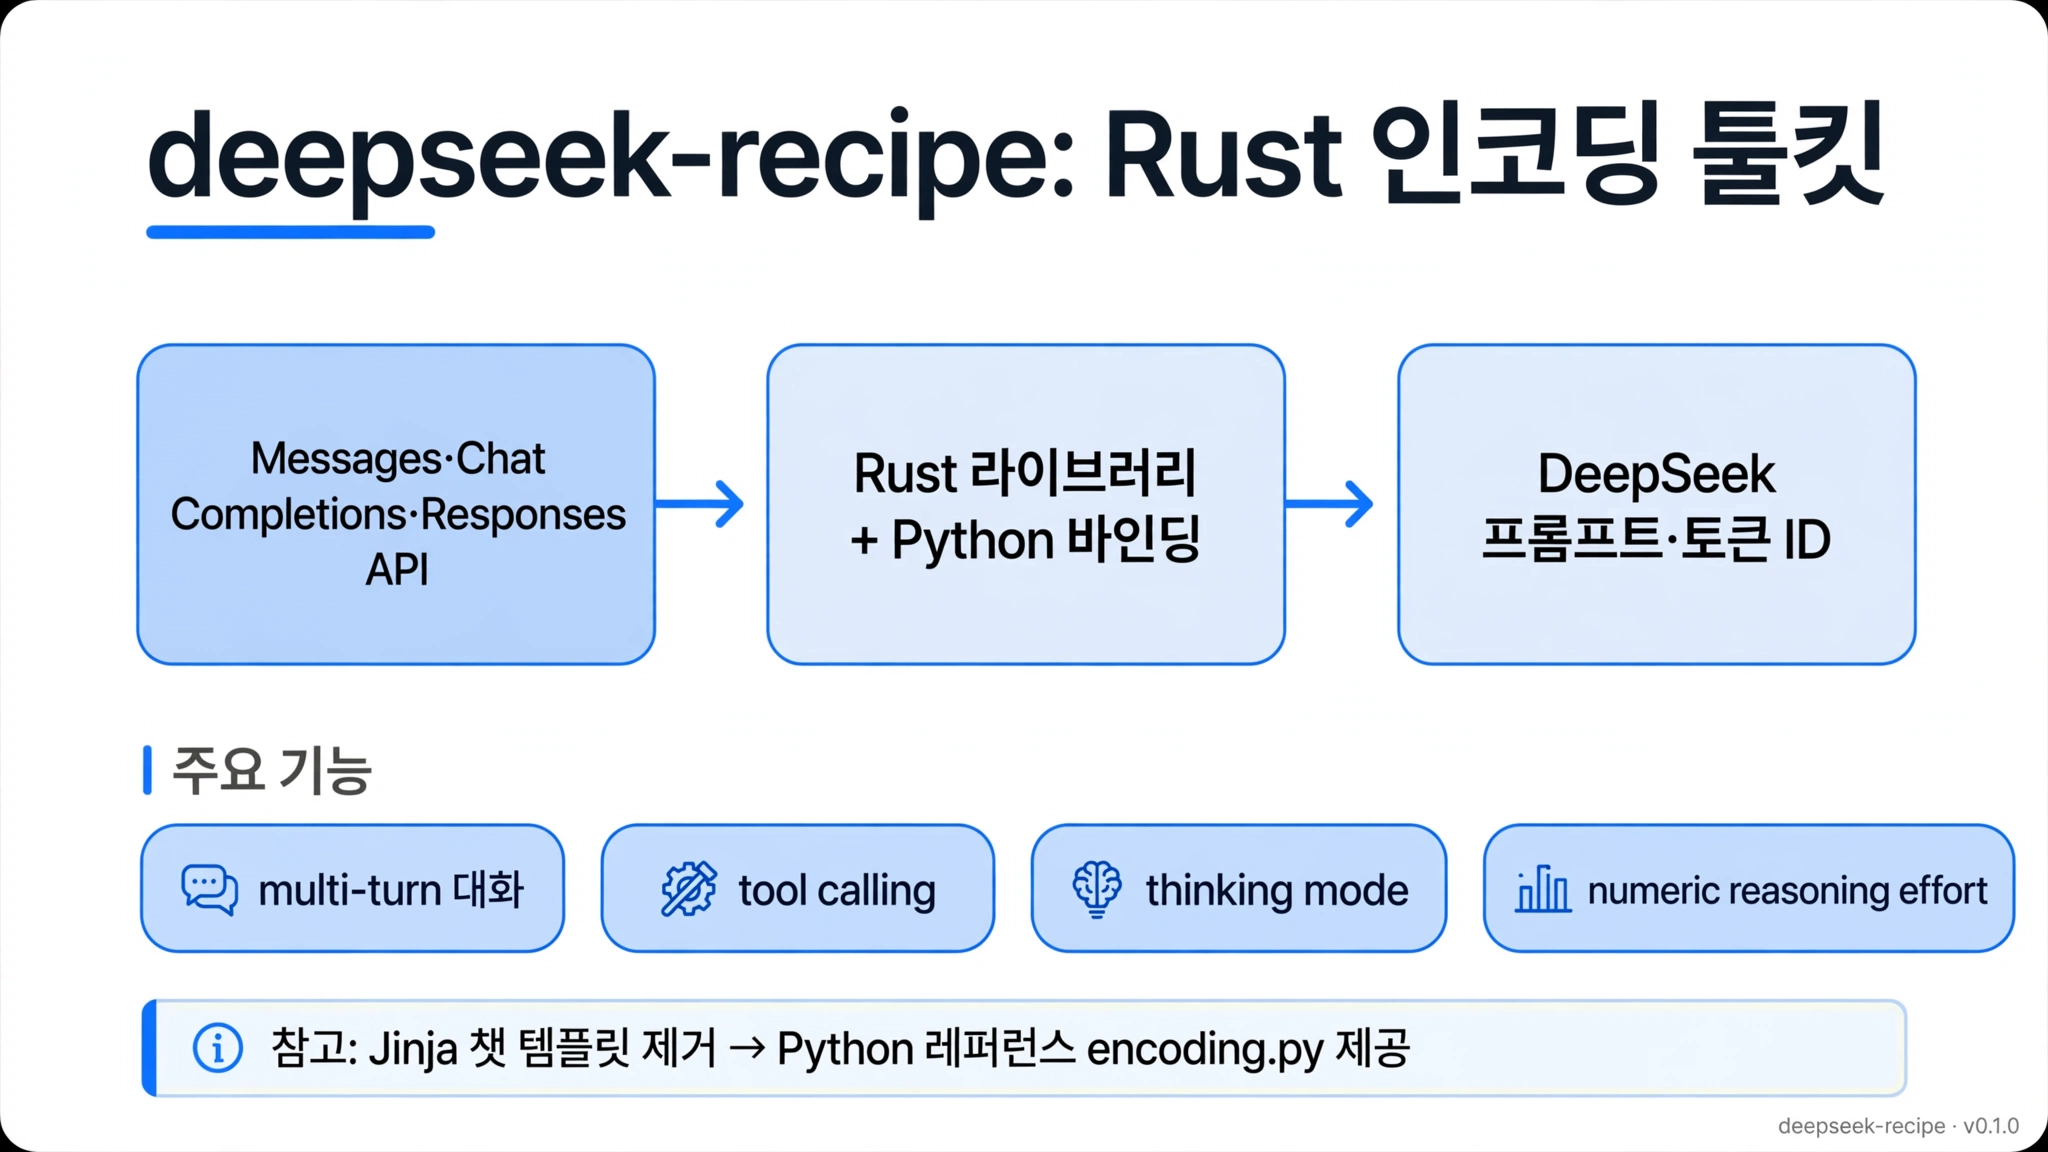
이번 릴리스의 실무적으로 가장 흥미로운 변경은 벤치마크가 아니라 인코딩 방식의 변경이다. Jinja 포맷 챗 템플릿을 포함하지 않고, 대신 encoding/ 폴더에 Python 레퍼런스 구현(encoding.py)과 테스트 케이스를 제공한다. 지원하는 범위:
- multi-turn 대화 인코딩
- tool calling 포맷
- thinking mode 및 numeric reasoning effort (추론 강도 수치 조절)
- 대화 중 시스템 메시지, 인터리브드(interleaved) 이미지 컨텐츠
그리고 함께 공개된 deepseek-recipe: Rust 라이브러리 + Python 바인딩으로, Messages·Chat Completions·Responses API 요청을 Conversation 포맷으로 변환하고 DeepSeek V4·V4.1 프롬프트 또는 토큰 ID로 인코딩하는 "유지보수되는" 툴킷이다. Jinja 템플릿 렌더링을 런타임에서 떼어내고 Rust로 고정했다는 건데, 고처리량 서빙·프라이빗 하네스에서 프롬프트 전처리 오버헤드를 줄이려는 의도로 읽힌다.
# deepseek-recipe 개념 사용 흐름 (레퍼런스)
from deepseek_recipe import Encoder

enc = Encoder(model="deepseek-ai/DeepSeek-V4.1-Flash-1017")
# Messages API 요청 -> Conversation 포맷 -> 토큰 ID
token_ids = enc.encode_messages(
    messages=[{"role": "user", "content": "..."}],
    tools=[...],               # tool calling 지원
    thinking={"effort": 2},    # numeric reasoning effort
)
로컬 추론: 1M 컨텍스트, temp 1.0
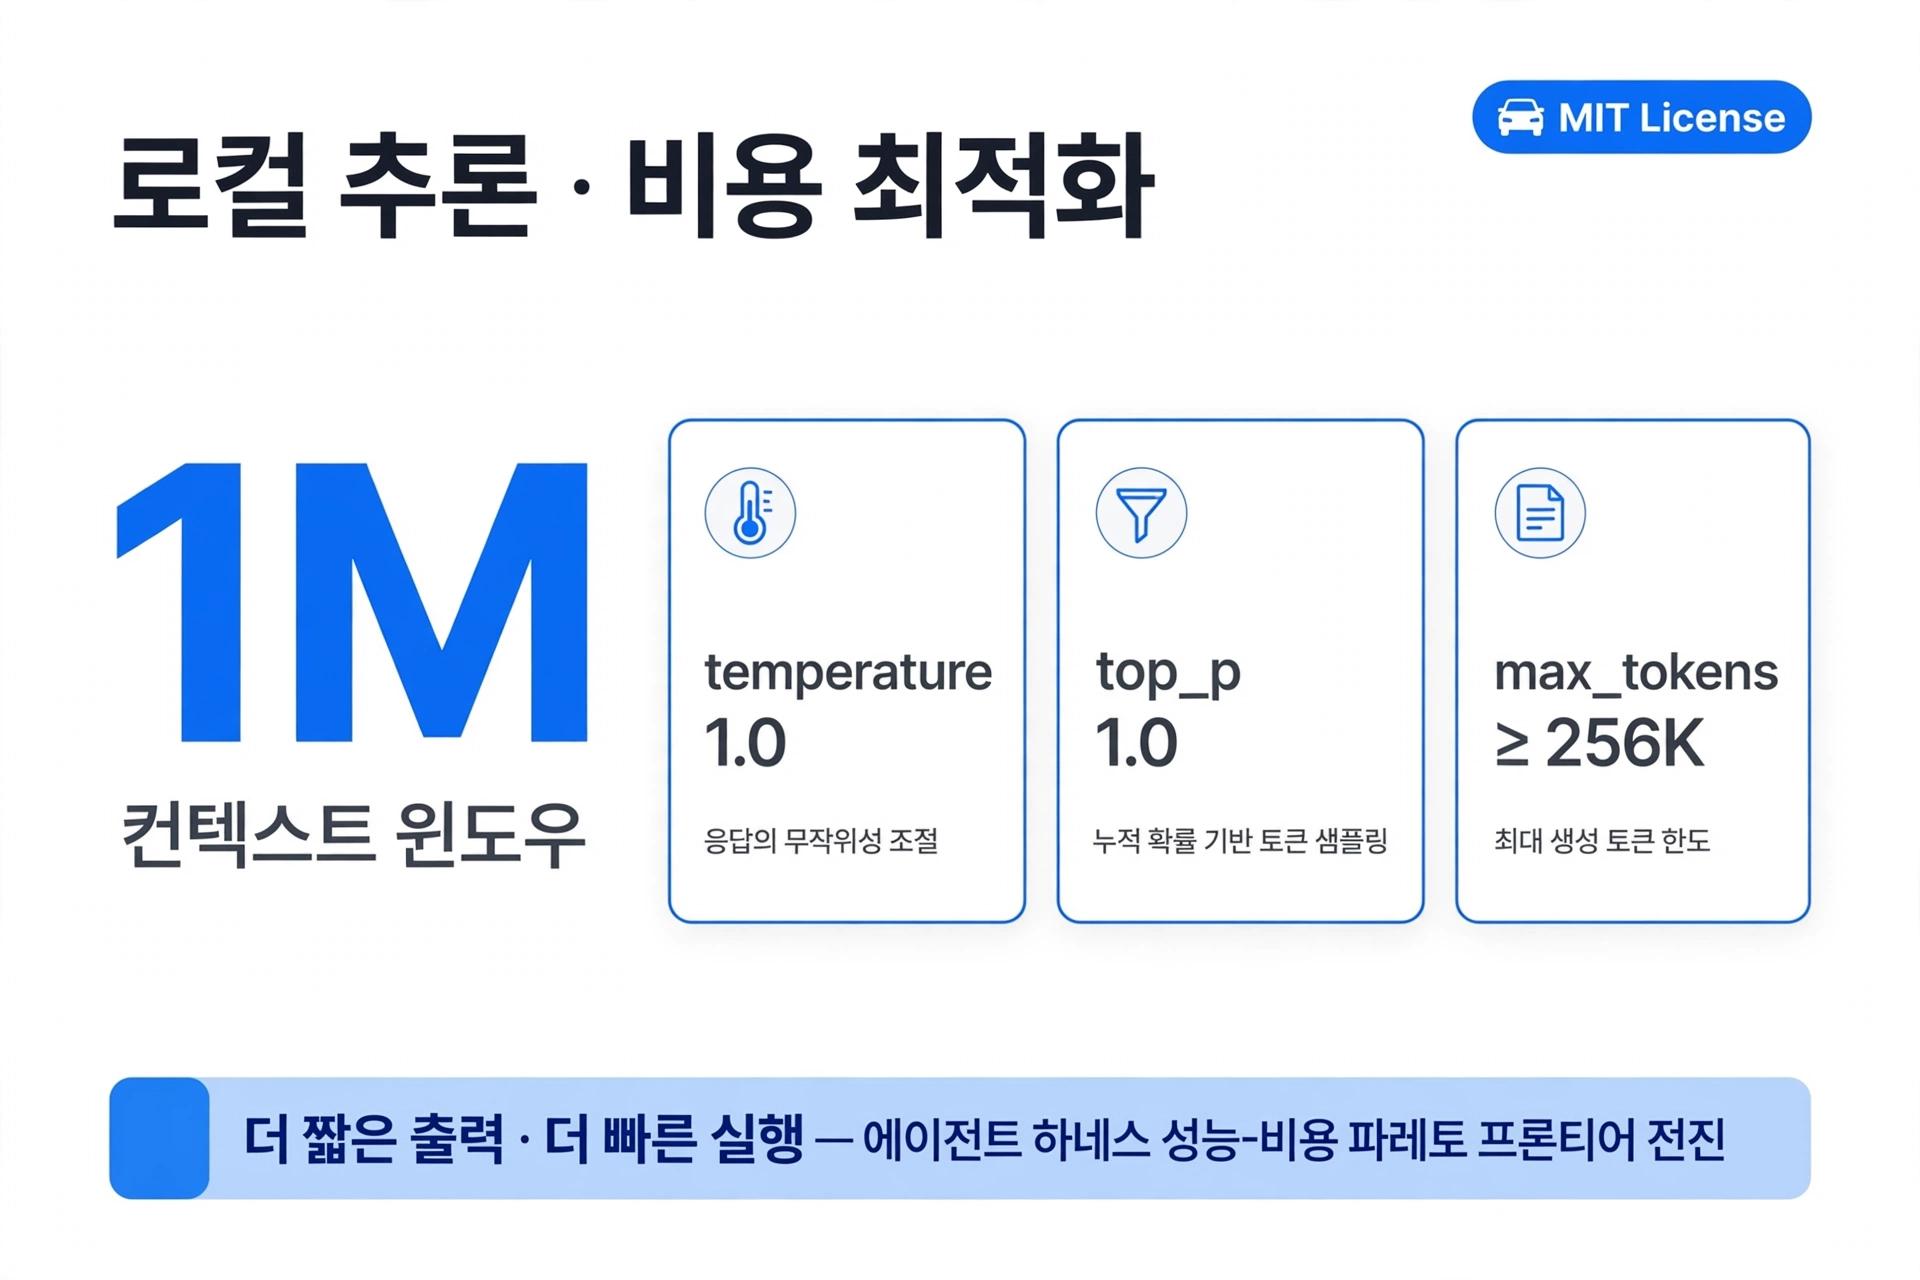
inference/ 폴더에 웨이트 변환·로컬 추론 가이드를 제공하고, 권장 샘플링 파라미터는 temperature 1.0, top_p 1.0, context window 1M tokens, max_tokens ≥ 256K이다. MIT 라이선스 + 로컬 추론 가이드 + Rust 인코딩 툴킷의 조합은 온디바이스·프라이빗 하네스 실험의 진입 장벽을 낮추는 방향이다. "더 빠르고 더 짧게"라는 주장과 합쳐지면, 대량의 파일 탐색·터미널 작업을 돌리는 에이전트의 드롭인 대체 후보로 벤치에 올릴 만하다.
# OpenAI 호환 클라이언트에서 호출할 때의 핵심 설정
response = client.chat.completions.create(
    model="deepseek-ai/DeepSeek-V4.1-Flash-1017",
    messages=messages,
    temperature=1.0,
    top_p=1.0,
    max_tokens=262144,   # ≥ 256K 권장
)
아직 미확인: 'minor update'라는 표현과 달리 벤치마크 상승폭이 큰데, 체크포인트 변경 외에 학습·데이터 파이프라인 변경이 있었는지는 모델 카드에 명시되지 않았다. 벤치마크는 전부 DeepSeek 자체 측정(자사 하네스 명시는 되어 있음)이며 독립 재현 결과는 아직 없다. API 요금 정보도 이번 릴리스에 포함되지 않아 Flash 계열 특유의 저비용 포지셔닝이 유지되는지도 미확인이다. 모든 수치는 회사 주장으로 취급하고, 우리 워크로드는 직접 측정할 것.
왜 주목할 만한가
한국 Android 개발자·AX TF 리드 관점에서 핵심은 하나다: agentic coding 벤치마크(Terminal-Bench·DeepSWE)에서 GPT-6급·Opus급을 넘나드는 MIT 라이선스 오픈 모델이 '더 빠르고 더 짧게' 업데이트됐다는 점이다. 코딩 에이전트의 파일 탐색·터미널 작업 비용을 낮추는 드롭인 후보이며, deepseek-recipe(Rust 인코딩 툴킷)와 로컬 추론 가이드는 온디바이스·프라이빗 하네스 실험의 진입 장벽을 낮춘다. agentic 워크로드 비용 최적화를 고민하는 팀이라면 이번 체크포인트를 벤치에 올려볼 만하다.