MiniMax M3.1 Flash 가중치 공개: 428B·활성 23B, 주요 칩·클라우드 지원
예고한 날짜에, 약속한 가중치가 열렸습니다
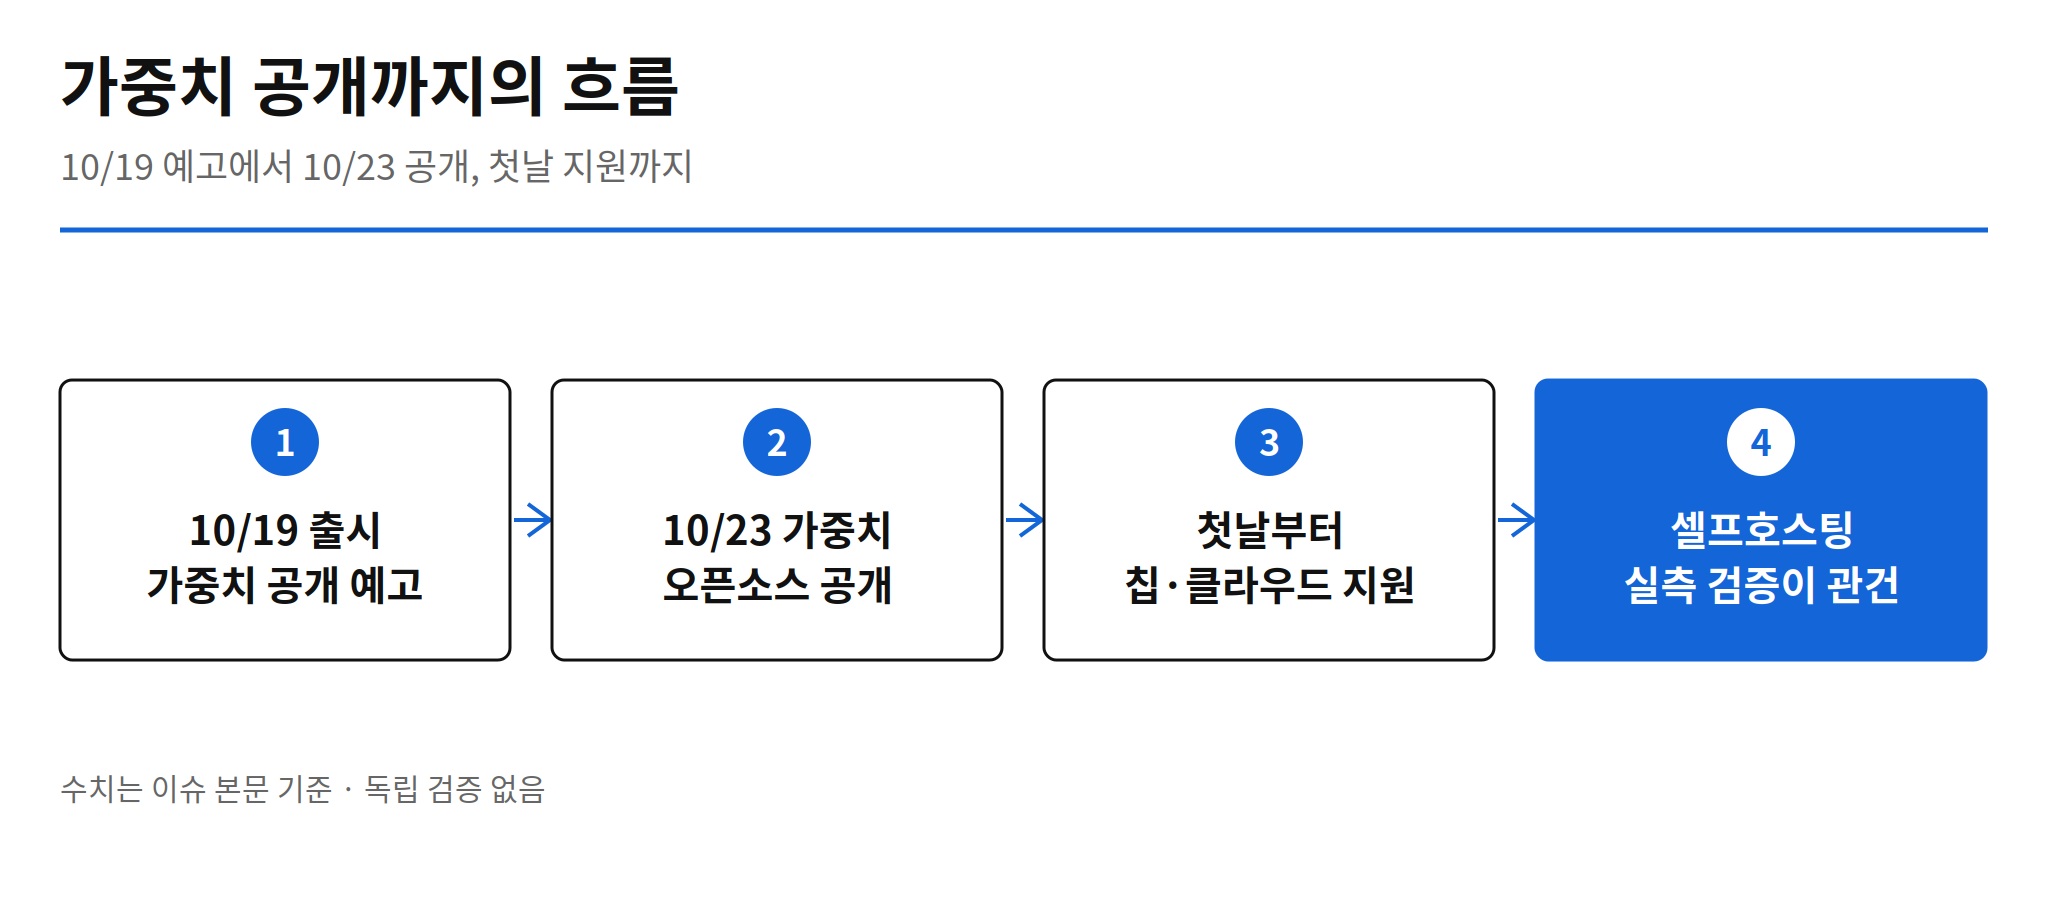
MiniMax는 10/19 출시 당시 "가중치는 10/23에 공개한다"고 예고했고, 예고대로 공개했습니다. 출시 전에는 'Space Bunny'라는 익명 모델로 OpenRouter·OpenCode에서 12일 연속 사용량 1위를 기록하며 실전 검증을 마친 점이 특징입니다. 이번 공개의 무게는 바로 이 지점에 있습니다. 단순한 발표가 아니라, 이미 돌아보고 있는 모델의 가중치가 손에 들어왔다는 뜻이니까요.
- 2026-10-23 가중치 오픈소스 공개 — 10/19 출시(#3348) 때 예고한 일정 그대로 이행했습니다.
- 출시 72시간 만에 실제 사용자가 처리한 토큰 100조 돌파 — 공식 집계 기준이며, 제공자 자체 수치라는 단서가 붙습니다.
- DeepSeek V4.1 Flash(10/17, #3327)와 함께 중국발 '플래시급 에이전트 모델' 가격 경쟁의 한 축을 이룹니다.
428B 중 실제로 켜지는 것은 23B입니다
M3.1 Flash는 총 4280억(428B) 파라미터, 활성 230억(23B) 파라미터의 MoE 구조입니다. 전체를 다 켜는 모델이 아니라, 토큰마다 필요한 전문가만 골라 켜는 구조라는 뜻입니다. 추론 효율 개선을 위해 전체 모델 희소 어텐션(full-model sparse attention)·양자화 인식 학습(QAT)·전력 인식 스케줄링 최적화를 적용했다고 합니다.
벤치마크는 10/19 공개 수치와 동일합니다. 숫자를 그대로 가져오되, 출처는 분명히 밝혀두는 편이 맞겠지요?
- DeepSWE v1.1 73.7%
- Humanity's Last Exam 48%
- Artificial Analysis Intelligence Index 42점
이 수치들은 제공자 자체 수치이며, 가중치 공개 이후 제3자 재현이 가능해졌으므로 후속 검증이 필요합니다.
첫날부터 붙은 칩과 클라우드가 관건입니다
가중치 공개의 실무 가치는 "첫날부터 무엇이 붙었는가"로 갈립니다. 이 점에서 M3.1 Flash는 준비가 되어 있습니다. 첫날부터 함께 지원하는 칩 제조사는 Huawei Ascend·T-head·Kunlun Core·Moore Threads·Biren·Haiguang·Muxi·Tiandao·NVIDIA·AMD입니다. 첫날부터 접근을 여는 클라우드 플랫폼은 Together AI·Fireworks·Nebius·Baseten·Modal·DigitalOcean이며, Together AI는 프로덕션 추론 파트너로 명명됐습니다.
커뮤니티 쪽도 마찬가지입니다. vLLM·SGLang·Zhiyuan FlagOS가 배포를 지원하고, Hugging Face·Modao에서도 모델을 제공합니다. 기존 파이프라인에 바로 얹어 테스트할 수 있는 조건이 갖춰진 셈입니다.
가격표는 그대로입니다 — 그래서 비교가 쉽습니다
API 가격은 10/19 발표 그대로입니다. 가중치가 열렸다고 API 가격까지 바뀐 것은 아니라는 뜻입니다.
| 구분 | 가격 (100만 토큰당) |
|---|---|
| 입력 | $0.15 |
| 출력 | $0.60 |
| 캐시 읽기 | $0.015 |
플래시급 모델은 API 비용이 부담되는 고볼륨 에이전트 워크로드에서 셀프호스팅이 현실적인 대안이 됩니다. 가중치 공개의 실무 가치가 플래그십 모델보다 크다고 보는 이유도 여기에 있습니다.
아직 확인되지 않은 세 가지가 있습니다
보도 단계의 공개인 만큼, 섣불리 메우지 않고 미확인으로 남겨두는 편이 맞습니다.
- 라이선스 조건은 미확인입니다. M3는 MiniMax 자체 커뮤니티 라이선스였는데, M3.1 Flash의 라이선스는 아직 공개된 문서에서 확인되지 않았습니다.
- 벤치마크·속도 주장의 독립 검증이 없습니다. 10/19 보도에서도 지적된 대로 제공자 자체 수치입니다.
- Artificial Analysis 측정에서 hallucination rate 93% 지적이 있습니다. 불확실해도 답을 시도한다는 뜻으로, 에이전트 루프에서의 신뢰성 리스크는 여전합니다.
플래시급 모델의 가중치 공개는 "싸게 쓰는 방법"이 아니라 "직접 돌려보고 검증할 수 있는 방법"을 여는 일이다. 가격이 아니라 검증 가능성이 이번 공개의 본질이 아닐까요?
실무 판단 — 활용처
당장 플래그십을 대체할 모델로 보기는 어렵습니다. 다만 고볼륨 에이전트 워크로드라면, vLLM·SGLang으로 기존 파이프라인에 얹어 실측해볼 만한 후보가 생긴 것은 분명합니다. 확인할 순서는 이렇습니다. 라이선스 조건을 먼저 확인하고, 다음으로 자신의 워크로드에서 환각률과 비용을 재고, 그다음에 셀프호스팅과 API 중 어느 쪽이 싼지를 따지는 것입니다. 숫자는 가져오되, 판단은 실측에 맡기는 것이 순서겠습니다.