HGM-Dual: 계보 인식 진단 가이드로 하네스 최적화를 플래닝까지 확장와 플래닝 정렬 문제
왜 코딩에서 통하던 방법이 플래닝에서는 깨졌나
모델을 바꾸지 않고 에이전트를 개선하는 현실적인 경로는 하네스(Harness) 최적화입니다. 프롬프트와 도구, 워크플로를 다듬는 일이죠. 코딩 영역에서는 이 방식이 통했습니다. 그런데 플래닝 태스크에서는 정렬이 깨집니다.
이유는 간단합니다. 플래닝에서는 도구 호출 순서가 서로 얽힌 제약을 한꺼번에 만족해야 합니다. 에이전트를 개선하는 데 필요한 능력과, 실제로 개선해야 할 능력이 어긋나는 겁니다. 코딩에서는 일치했던 두 능력이 플래닝에서는 갈라집니다.
그래서 열린 결말의 자기 수정은 비효율적인 변경을 반복 탐색하게 됩니다. 평가 예산을 크게 쓰면서도 제자리걸음을 하는 셈입니다. HGM-Dual은 이 진단을 출발점으로 삼습니다.
- Darwin–Gödel Machine과 Huxley–Gödel Machine(HGM)은 재귀적 자기 개선에 의존하며, 주로 코딩 영역을 대상으로 개발됐습니다.
- 플래닝 태스크에서는 이 정렬이 깨집니다. 도구 호출 시퀀스가 상호작용하는 제약을 함께 만족해야 하기 때문입니다.
- 열린 결말의 자기 수정은 비효율적 변경을 반복 탐색하며, 평가 예산을 크게 소모합니다. 플래닝 태스크에서 특히 심합니다.
무엇을 바꿨고, 무엇이 좋아졌는지를 편집자에게 직접 보여준다
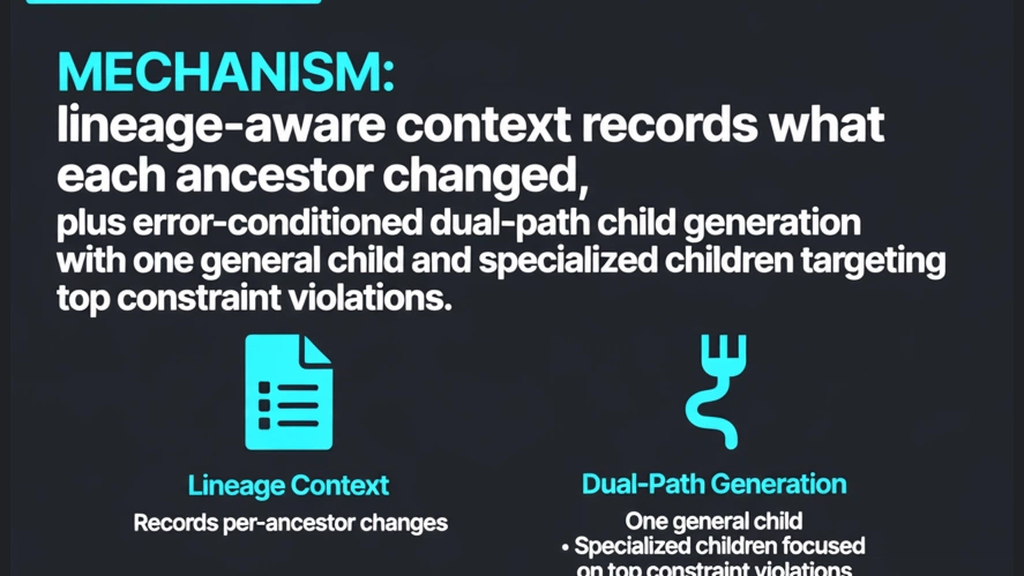
HGM-Dual의 첫 번째 장치는 lineage-aware context입니다. 에이전트 진화를 계보 인식 context로 표현합니다. 각 조상이 무엇을 바꿨고, 어떤 행동이 개선됐고 퇴보했는지, 어떤 수정이 비효율적이었는지를 기록합니다.
핵심은 기록의 형태입니다. 편집자에게 과거 에이전트들의 비정형 아카이브를 던져주는 게 아닙니다. 명시적인 편집-결과 귀속(explicit edit-outcome attribution)을 제공합니다. "이 수정을 했더니 이 결과가 나왔다"는 인과가 읽히는 형태죠.
두 번째 장치는 error-conditioned dual-path child generation입니다. 부모마다 일반 자식(general child)과 전문화된 자식들(specialized children)을 함께 만듭니다. 일반 자식은 열린 탐색을 유지하고, 전문화된 자식들은 부모의 최상위 제약 위반을 담당하는 컴포넌트를 겨냥합니다.
- 일반 자식은 탐색의 폭을 지킵니다. 전문화된 자식은 진단이 가리킨 약점을 직접 찌릅니다.
- 두 갈래를 병행하니, 무작정 넓게 탐색하지도 않고 한 가지 실패에만 갇히지도 않습니다.
- 이 구조가 바로 "진단 가이드(diagnosis-guided)"라는 이름의 실체입니다.
계보를 남기지 않는 진화는 같은 실수를 반복합니다. HGM-Dual은 "무엇을 바꿨는지"를 편집자의 작업 기억으로 만드는 데서 출발합니다.
숫자로 확인된 주장 — 정확도는 올리고 예산은 줄였다
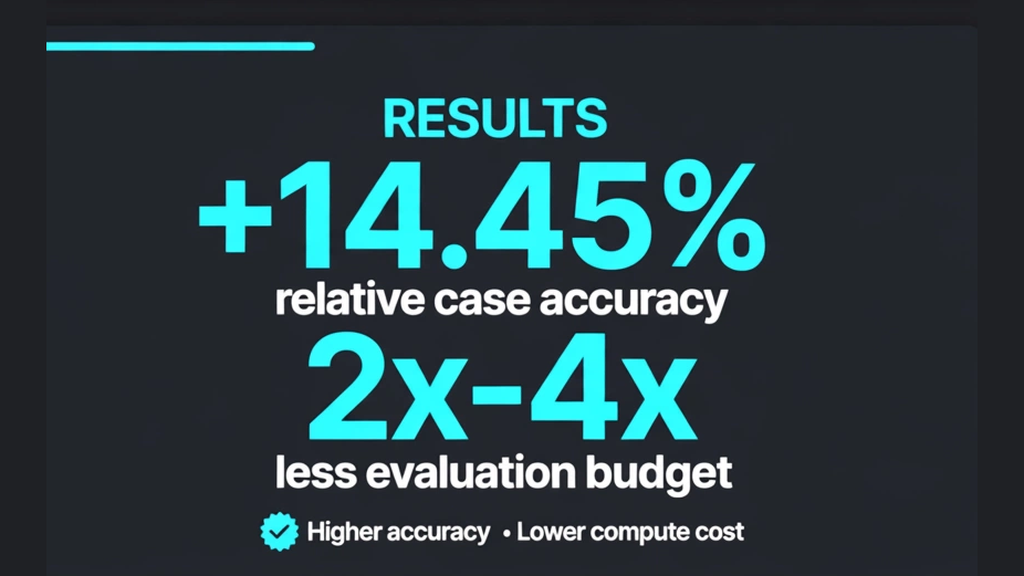
논문이 내세운 결과는 두 가지입니다. 첫째, 가장 강한 베이스라인 대비 케이스 정확도에서 최대 14.45% 상대 개선을 달성했습니다. 둘째, HGM 변형들의 최종 성능을 2배에서 4배 적은 평가 예산으로 달성했습니다.
두 수치의 비교 기준을 헷갈리면 안 됩니다. 14.45%는 상대 개선율이지, 절대 정확도 상승폭이 아닙니다. 2배에서 4배는 최종 성능 도달에 쓴 예산의 비율이지, 전체 실험 비용이 그만큼 줄었다는 뜻으로 단정할 수는 없습니다.
그럼에도 두 수치를 함께 읽으면 주장의 방향은 분명합니다. 성능을 희생하지 않고 예산을 아끼는 "예산 효율적인 하네스 진화(budget-efficient harness evolution)"가 이 논문의 핵심 주장입니다.
아직 확인되지 않은 것들 — 숫자를 받아들이기 전에
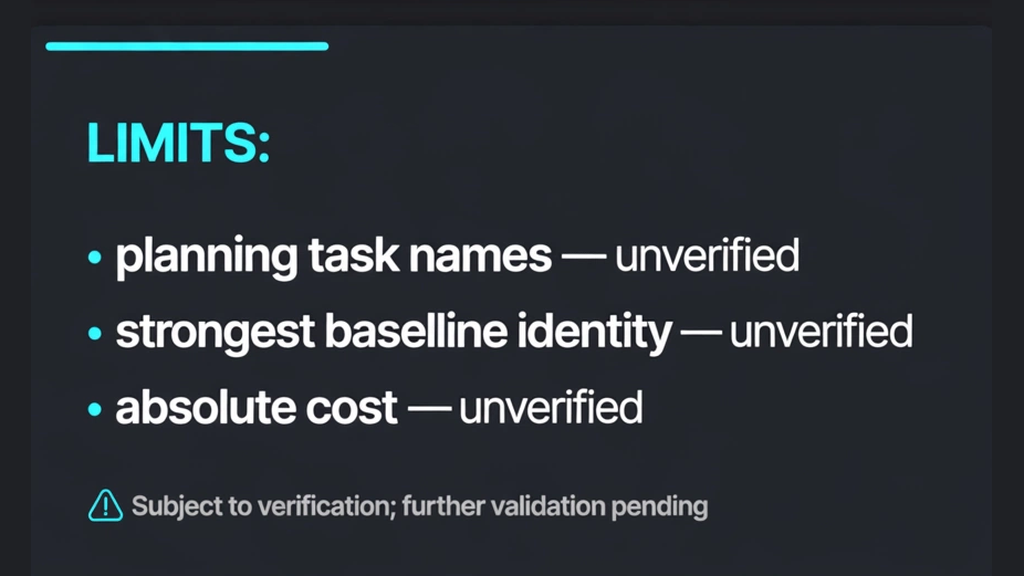
- 평가에 쓴 플래닝 태스크의 구체 명칭과 규모는 미확인입니다. 어떤 플래닝 도메인인지도 알 수 없습니다.
- 비교 대상인 가장 강한 베이스라인의 정체는 미확인입니다. 무엇을 이겼는지가 불분명하면 14.45%의 무게도 달라집니다.
- 2배에서 4배 예산 절감의 절대 비용은 미확인입니다. 평가 횟수나 시간이 얼마였는지는 밝혀지지 않았습니다.
- 계보 인식 context의 저장·관리 비용도 미확인입니다. 기록 자체가 싸지 않다면, 아낀 예산의 일부는 기록 비용으로 돌아갈 수 있습니다.
우리 팩토리에 무엇을 가져올까 — 기록부터 시작하는 게 순서다
우리 크론과 팩토리 에이전트들도 고정된 모델 위에서 도는 하네스입니다. 프롬프트와 도구, 워크플로를 손으로 다듬고 있죠. 그런 점에서 HGM-Dual의 패턴은 바로 써먹을 수 있습니다.
당장 도입할 만한 건 두 가지입니다. 하나는 프롬프트 변경마다 "무엇을 바꿨고 결과가 어땠는지"를 남기는 계보 기록입니다. 다른 하나는 실패 유형별로 자식을 나누는 진단 가이드 진화입니다. 거창한 자동 진화 시스템부터 만들 필요는 없습니다.
다만 예산 절감 주장은 아직 검증 전입니다. 절대 비용이 공개되지 않은 상태에서는, 우리 환경에서 직접 재보는 것이 순서입니다. 기록부터 시작하고, 숫자는 우리 예산으로 확인하는 게 맞지 않을까요?