Agentic Brain: Claude Code·Cursor·Codex 세션 공유 셀프호스팅 메모리
개인 개발자 rohithhn이 AI 코딩 도구용 셀프호스팅 메모리 Agentic Brain을 공개했다 (dev.to 공식 런칭 포스트, 2026-10-18). Claude Code·Codex·Antigravity·Cursor·Kilo Code — 도구 다섯 개를 오가며 일하는 개발자가 겪는 "월요일 Claude Code에서 정한 결정을 화요일 Cursor에서 또 설명" 문제를 정면으로 겨냥한다. 라이선스는 Apache-2.0, 레포는 rohithhn/Open-Agentic-Brain-and-Memory다.
가장 눈여겨볼 설계 결정: 푸시(push)와 풀(pull)을 나눴다. 자주 쓰는 기억은 CLAUDE.md·AGENTS.md·GEMINI.md에 직접 삽입(푸시)하고, 그때그때 필요한 기억은 MCP로 조회(풀)한다. 도구에 따라 같은 지식을 두 번 적는 구조다.
5단계 루프: Capture → Distill → Rank → Inject → Measure
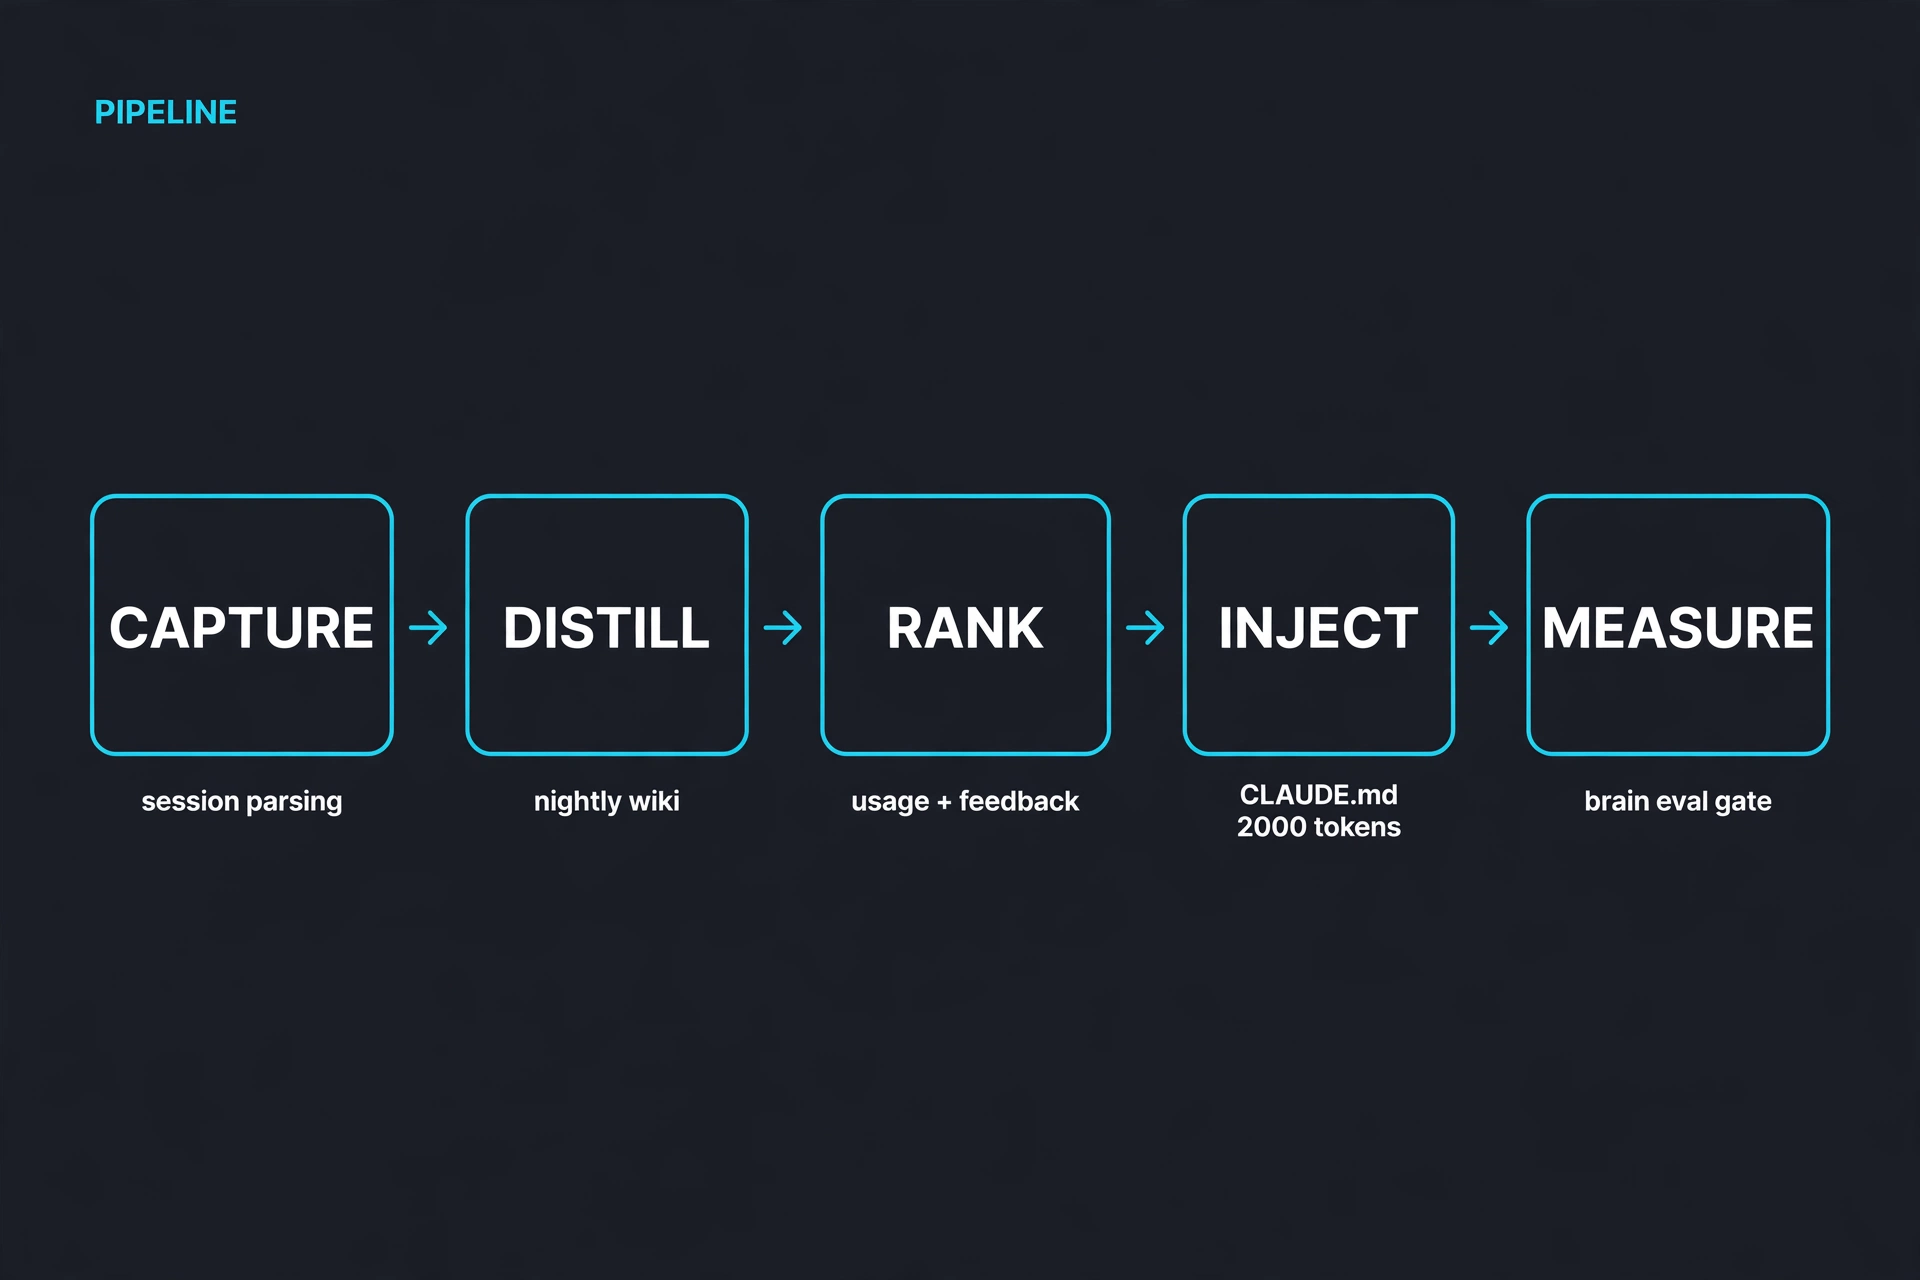
- Capture — 각 도구의 세션 파일을 파싱해 로컬 SQLite 하나로 모은다.
- Distill — 밤에
brain dream이 수집분을 다시 쓰는 위키로 다듬고, 학습안(lesson)은 사용자가 승인해야 반영된다. 자동 반영이 아니라 승인 게이트가 있다. - Rank — 기억을 관련도→증거 순으로 정렬한다. 증거 = 사용 빈도와 "도움이 됐어" 평가.
- Inject — 최대 2,000 토큰짜리 브리핑을 CLAUDE.md·AGENTS.md·GEMINI.md의 전용 마커 안에 쓴다. p50 기준 84ms에 준비된다는 주장.
- Measure —
brain eval이 내 히스토리로 퀴즈를 내 검색·주입 변경을 게이트한다. 기억 품질이 떨어지는 변경은 배포되지 않는다.
MCP 인터페이스도 별도로 제공한다 — brain_recall·brain_remember·brain_context. 1만 개 메모리 대상 recall이 p50 28ms라는 주장이다.
핵심 수치: 빠르다, 그러나 벤치마크는 자체 보고
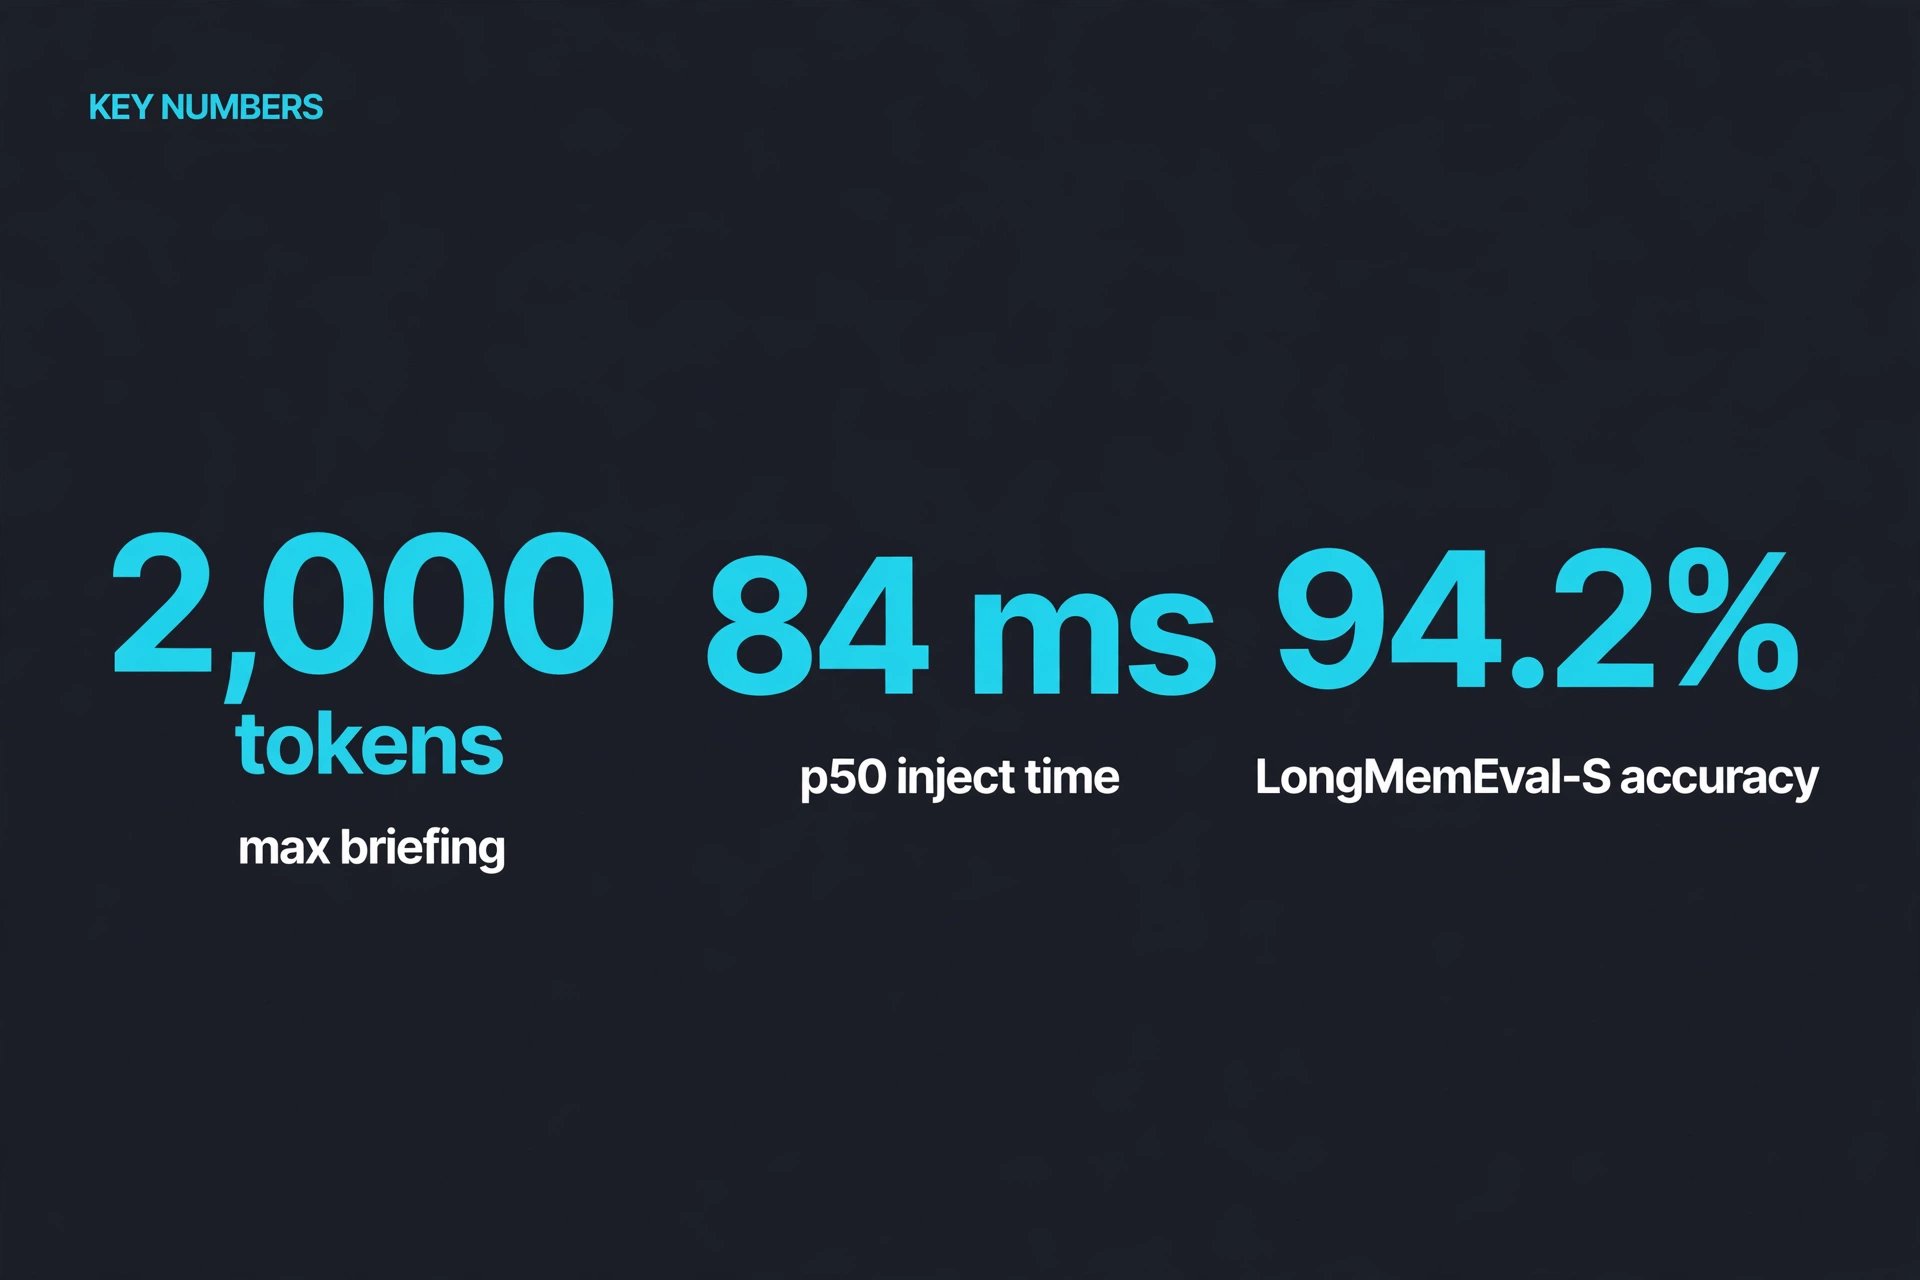
| 지표 | 수치 | 비고 |
|---|---|---|
| 주입 브리핑 | 최대 2,000 토큰 | CLAUDE.md 마커 내 삽입, p50 84ms |
| LongMemEval-S | 94.2% | Claude reader+judge 기준, 자체 보고 |
| LongMemEval-M | 83.0% | 약 127만 토큰 히스토리, 자체 보고 |
| LoCoMo | 86.6 | 기준선 89.3, 자체 보고 |
| 토큰 효율 | 약 18% | 전체 대화를 다 주는 방식 대비 ~97% 점수 주장 |
로컬 우선: 계정도 서버도 없다
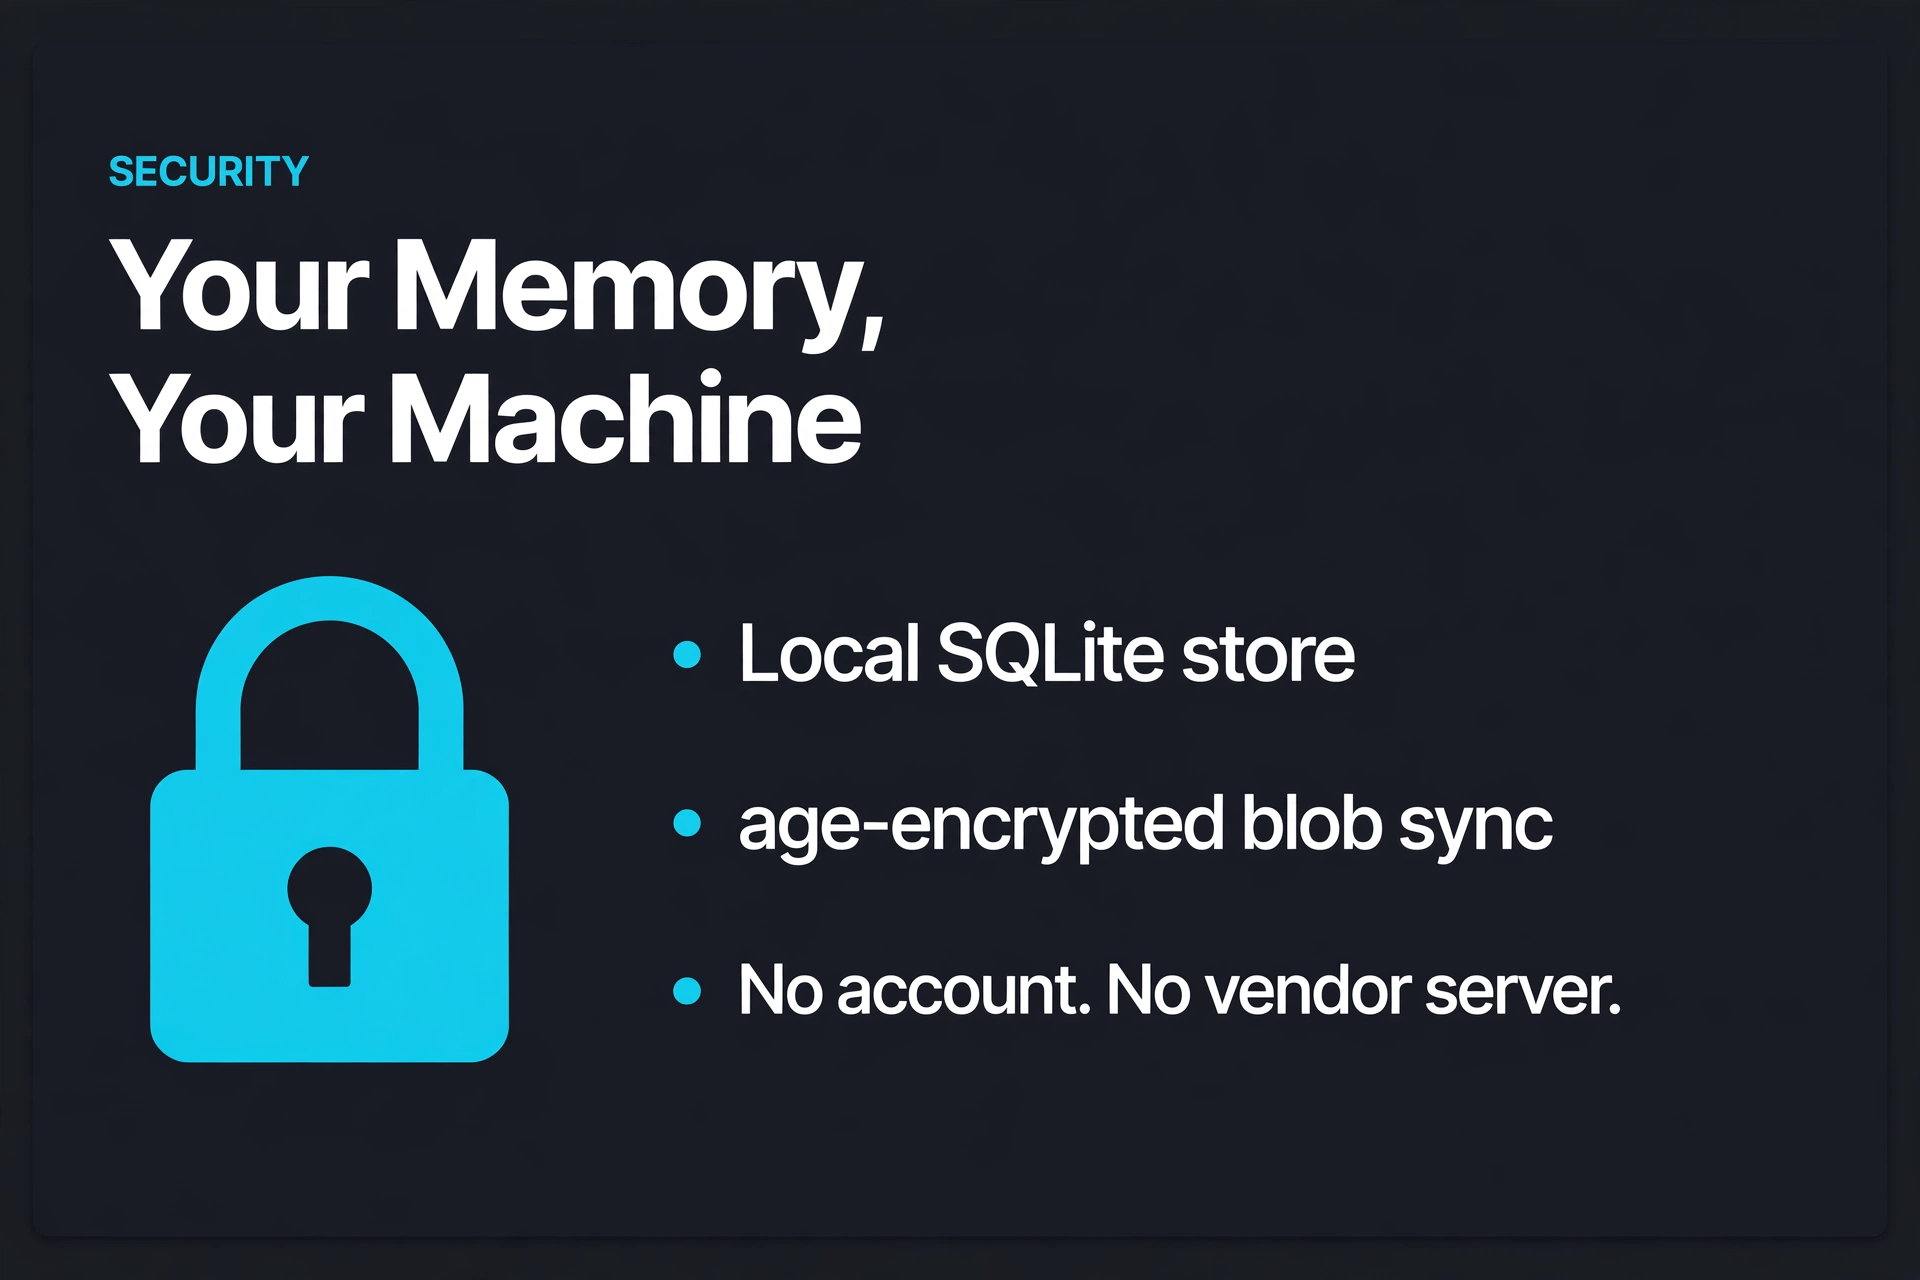
동기화는 "age 암호화된 단일 블롭 + 개인 GitHub 레포의 Release 애셋" 방식이고, 키는 OS 키체인에만 있다. 계정도, 벤더 서버도 없다. 코딩 세션 전체가 메모리에 들어가는 도구 특성상 이 선택은 보안 민감 팀에게는 검토의 여지가 된다 — 다만 키 유출·블롭 유출 시 파급이 크므로 키 관리(키체인 백업·로테이션)까지 계획에 넣어야 한다.
switch-from-claude-mem 마이그레이션 명령이 들어 있다. 기존 도구를 직접 겨냥한 전환 전략 — 시장이 이미 있다는 방증이자, 차별점(승인 게이트·eval 게이트·푸시/풀 분리)을 어필해야 하는 이유다.
제한 사항
- Windows 미지원 — Node 22+ 필요, macOS·Linux만. Claude Desktop·ChatGPT 데스크톱은 pull-only(캡처 불가).
- 개인 프로젝트 — 장기 유지보수·보안 감사는 미확인. 운영 의존 전 코드 리뷰가 선행되어야 한다.
- 벤치마크는 자체 보고 (위 표 참조).
개발자 관점: 지금 당장 해볼 수 있는 것
설치는 한 줄이다:
curl -fsSL https://raw.githubusercontent.com/rohithhn/Open-Agentic-Brain-and-Memory/main/install.sh | bash관심 있으면 샌드박스 머신에서 먼저 돌려보는 것을 권장한다. 확인해볼 실무 포인트 세 가지:
- 주입 지연 실측 — 84ms(p50) 주장의 재현. 메모리 1만 개에서 recall 28ms도 같이.
- Distill 승인 게이트 UX —
brain dream이 만든 학습안을 실제로 리뷰해보고, 허위 학습안(false memory)이 얼마나 섞이는지. brain eval의 게이트 감도 — 검색 파라미터를 바꿨을 때 점수가 얼마나 움직이는지. 메모리 품질 관리의 실무 레퍼런스로 삼을 수 있는지가 여기서 갈린다.
관련 이슈: #3332 텐센트 'Hy Memory 2.0' — 에이전트 메모리 프레임워크로 같은 주제, 다른 접근(3B 특화 메모리 라이터 모델). 두 프로젝트를 나란히 두고 비교하면 "메모리를 모델에 맡길 것인가, 파이프라인에 맡길 것인가"라는 설계 분기점이 보인다.
원문 이슈
이 글은 ax-trend 이슈 #3343을 바탕으로 작성됐다. 핵심 링크: dev.to 공식 런칭 포스트 (2026-10-18), GitHub 레포 (Apache-2.0).