OpenAI GPT-6.1 Terra: Astra급 컴퓨터 사용 성능을 10분의 1 가격에 출시
OpenAI가 10월 26일 새 모델 GPT-6.1 Terra를 공개했다. GPT-5.6 Terra의 후속으로, 컴퓨터 사용·시각 추론·코딩·일상 업무에 맞춘 모델이다. 포지셔닝이 분명하다. 복잡한 코딩과 심층 연구는 Sol·Astra에 남기고, Terra는 매일의 업무와 컴퓨터 작업을 맡는다.
눈에 띄는 건 가격과 속도의 조합이다. API 표준 가격은 입력 토큰 100만 개당 1달러, 출력 토큰 100만 개당 5달러다. GPT-5.6 Terra와 GPT-6.1 Sol보다 50% 낮다. 여기에 Astra와 대등한 성적을 토큰당 가격의 10분의 1에 냈다고 한다. 작업 속도는 Astra와 Sol보다 3배 이상 빠르다.
숫자로 보는 Terra
OpenAI가 공개한 수치를 정리하면 아래 표와 같다. 전부 OpenAI 자체 발표 기준이다.
| 지표 | 수치 |
|---|---|
| API 가격 (입력 / 출력, 100만 토큰당) | 1달러 / 5달러 — GPT-5.6 Terra·GPT-6.1 Sol 대비 50% 낮음 |
| Agents' Last Exam (중간 추론 노력) | GPT-5.6 Terra보다 15%포인트 높음, 과제당 비용은 약 3분의 1 |
| Agents' Last Exam vs Astra | 대등한 성적을 토큰당 가격의 10분의 1에 |
| 작업 속도 | Astra·Sol보다 3배 이상 빠름 |
| Terminal-Bench 4.0 (최대 추론 노력) | 50.3% — GPT-5.6 Terra 21.5%의 2배 이상 |
| 내부 어려운 프롬프트 평가 오류율 | 최대 노력 기준 4.3% — 전작보다 18%포인트 낮음, Astra·Sol과 거의 같은 수준 |
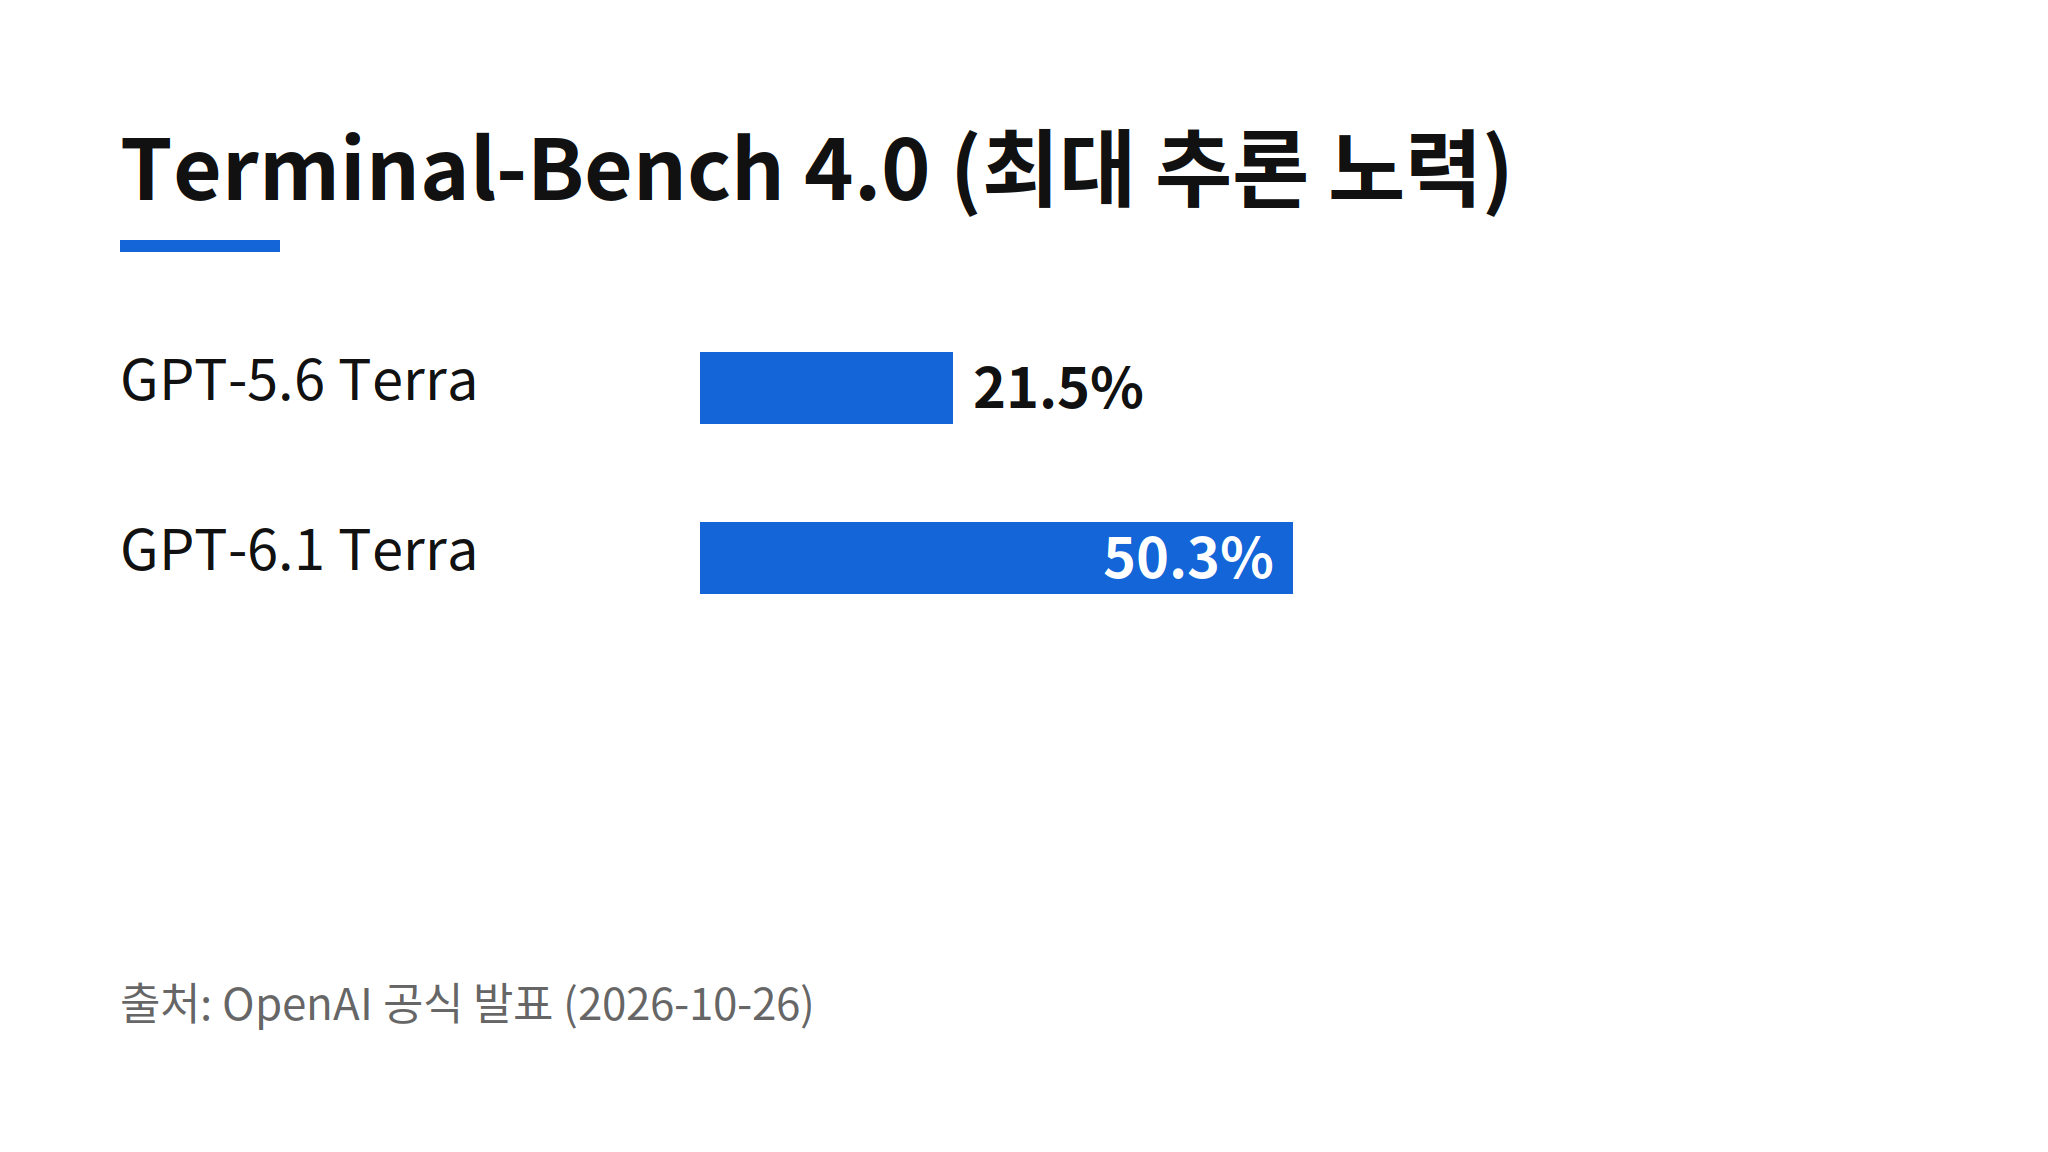
Terminal-Bench 수치가 특히 크다. 터미널 환경에서 실제로 일을 끝내는 능력을 재는 벤치마크에서 전작의 2배 이상으로 뛰었다. 코딩 에이전트를 돌리는 팀이라면 체감 포인트가 될 만한 대목이다.
라인업 자리와 Copilot 동시 출시
GPT-6.1 Sol이 9월 29일 나온 지 한 달도 안 돼 하위 라인업이 채워졌다. OpenAI의 배치는 이렇다. Sol·Astra는 복잡한 코딩과 심층 연구용, Terra는 매일의 업무·컴퓨터 작업용이다. 가격을 절반으로 낮춘 만큼, 대량·반복 작업의 기본 모델 자리를 노리는 출시다. GPT-5.6 제품군(Sol·Terra·Luna) 체계를 잇는 6.1 세대 확장으로도 읽힌다.
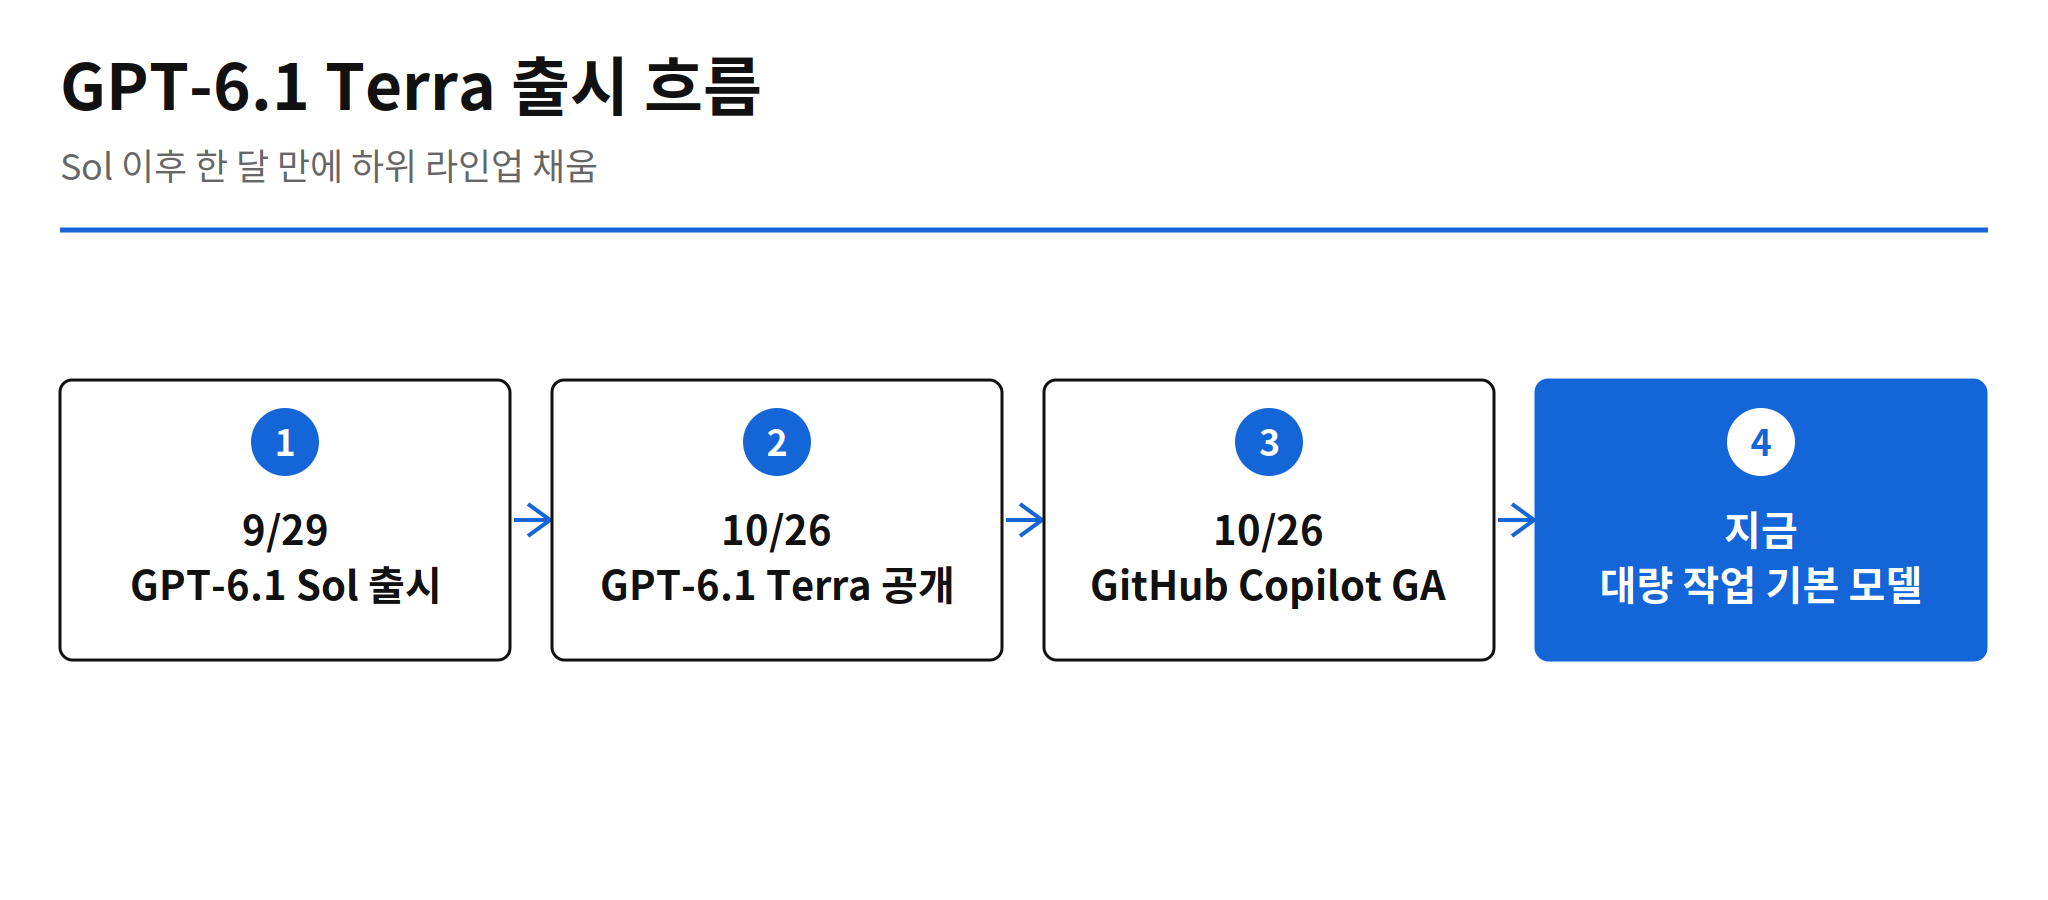
제공 경로는 두 갈래다. ChatGPT Work와 Codex의 Plus·Pro·Enterprise·Edu 사용자에게 제공되고, 개발자는 API에서 gpt-6.1-terra로 쓸 수 있다. 그리고 GitHub도 같은 날 GPT-6.1 Terra를 GitHub Copilot에 정식 출시했다. Pro·Pro+·Max·Business·Enterprise 대상이며, 에디터·CLI·클라우드 에이전트·웹·모바일·IDE에 점진적으로 풀린다. 기존 구독자는 별도 설정 없이 비교해 볼 수 있다는 뜻이다.
아직 빈칸으로 남은 것들
- 성능 수치는 모두 OpenAI 자체 발표다. 독립 벤치마크 검증은 아직 없다.
- Astra와 "대등"하다는 평가는 Agents' Last Exam 기준이다. 다른 업무에서는 다를 수 있다. 미확인이다.
- OpenAI 스스로 가장 복잡한 코딩 작업에는 GPT-6.1 Sol이나 GPT-6.1 Astra를 권했다. Terra의 코딩 개선이 실무 체감으로 이어질지는 써봐야 안다.
- Copilot의 점진적 롤아웃 일정과 지역별 적용 시점은 공개되지 않았다.
핵심은 '가장 센 모델'이 아니라 '매일 돌리기 좋은 모델'이 따로 나왔다는 점이다. 가격은 절반, 속도는 3배, 성적은 Astra급이라는 조합이 맞다면, 대량 작업의 기본값이 바뀔 수 있다.
실무 판단은 이렇게 정리됩니다. 코딩 에이전트와 컴퓨터 사용 에이전트를 돌리는 팀이라면, 반복 작업을 Sol·Astra에 맡기던 비용 구조를 다시 짜볼 만합니다. 다만 Astra 대등 평가는 한 벤치마크 기준이고 독립 검증이 없으니, 자기 업무의 대표 태스크로 직접 비교한 뒤 기본값을 바꾸는 것이 순서입니다. Copilot 사용자는 롤아웃이 자기 계정에 닿는 대로 바로 비교해 볼 수 있습니다.