MOSS-Image-SFT: 텍스트가 정확히 박히는 5B 오픈 이미지 생성 모델과 레이아웃 제어 강점
10월 18일, Hugging Face에 OpenMOSS-Team/MOSS-Image-SFT가 공개됐다. OpenMOSS 팀의 텍스트-투-이미지 모델 패밀리 MOSS-Image의 지도 파인튜닝(SFT) 버전으로, 베이스는 MOSS-Image-Base다. 이 모델의 포지셔닝은 명확하다: 오픈 이미지 모델의 고질적 약점인 이미지 속 텍스트 렌더링과 레이아웃 생성을 전면에 내세웠다. 모델카드에는 중국어 손글씨 메모 같은 텍스트 렌더링 예시가 직접 실려 있다.
개발자 관점 한 줄 요약: 5B DiT + Apache-2.0 라이선스의 오픈 가중치 T2I 모델. 텍스트 렌더링과 레이아웃 제어가 강점이라 썸네일·포스터·UI 목업 같은 실무 용도에 바로 쓸 수 있다. ComfyUI 네이티브 플러그인과 diffusers 파이프라인을 제공하고, 번들 VAE는 FLUX.2 small 디코더를 사용한다.
핵심 사실
- OpenMOSS-Team/MOSS-Image-SFT — MOSS-Image 패밀리의 SFT 버전. 자연어 프롬프트·태그 시퀀스·JSON 레이아웃으로 텍스트 배치와 객체 배열을 제어. (Hugging Face 모델카드)
- HF 지표: likes 235 · downloads 1,036, 레포 생성 2026-10-11, 라이선스 Apache-2.0, diffusers 파이프라인. (Hugging Face API, 2026-10-18 기준)
- Base 대비 SFT의 강점: 더 또렷한 텍스트 그룹화와 정돈된 레이아웃 — 모델카드의 비교 예시에서 확인. (모델카드)
- 동반 GitHub 레포
OpenMOSS/MOSS-Image★437, 생성 2026-10-16 — "5B-parameter base DiT model with high-quality text rendering, layout generation, and efficient fine-tuning". (GitHub API) - 번들 VAE: FLUX.2 small 디코더 사용. (모델카드)
- ComfyUI 네이티브 플러그인 제공 — ComfyUI Manager에서 "MOSS-Image" 검색으로 설치, 공식 ComfyUI 레포 통합은 진행 중. (모델카드)
- 데모·문서: Hugging Face Spaces 데모, 프로젝트 홈페이지, 기술 보고서 PDF, 영문·中文 사용자 가이드. (모델카드)
오픈 이미지 모델의 고질병 — 텍스트 렌더링
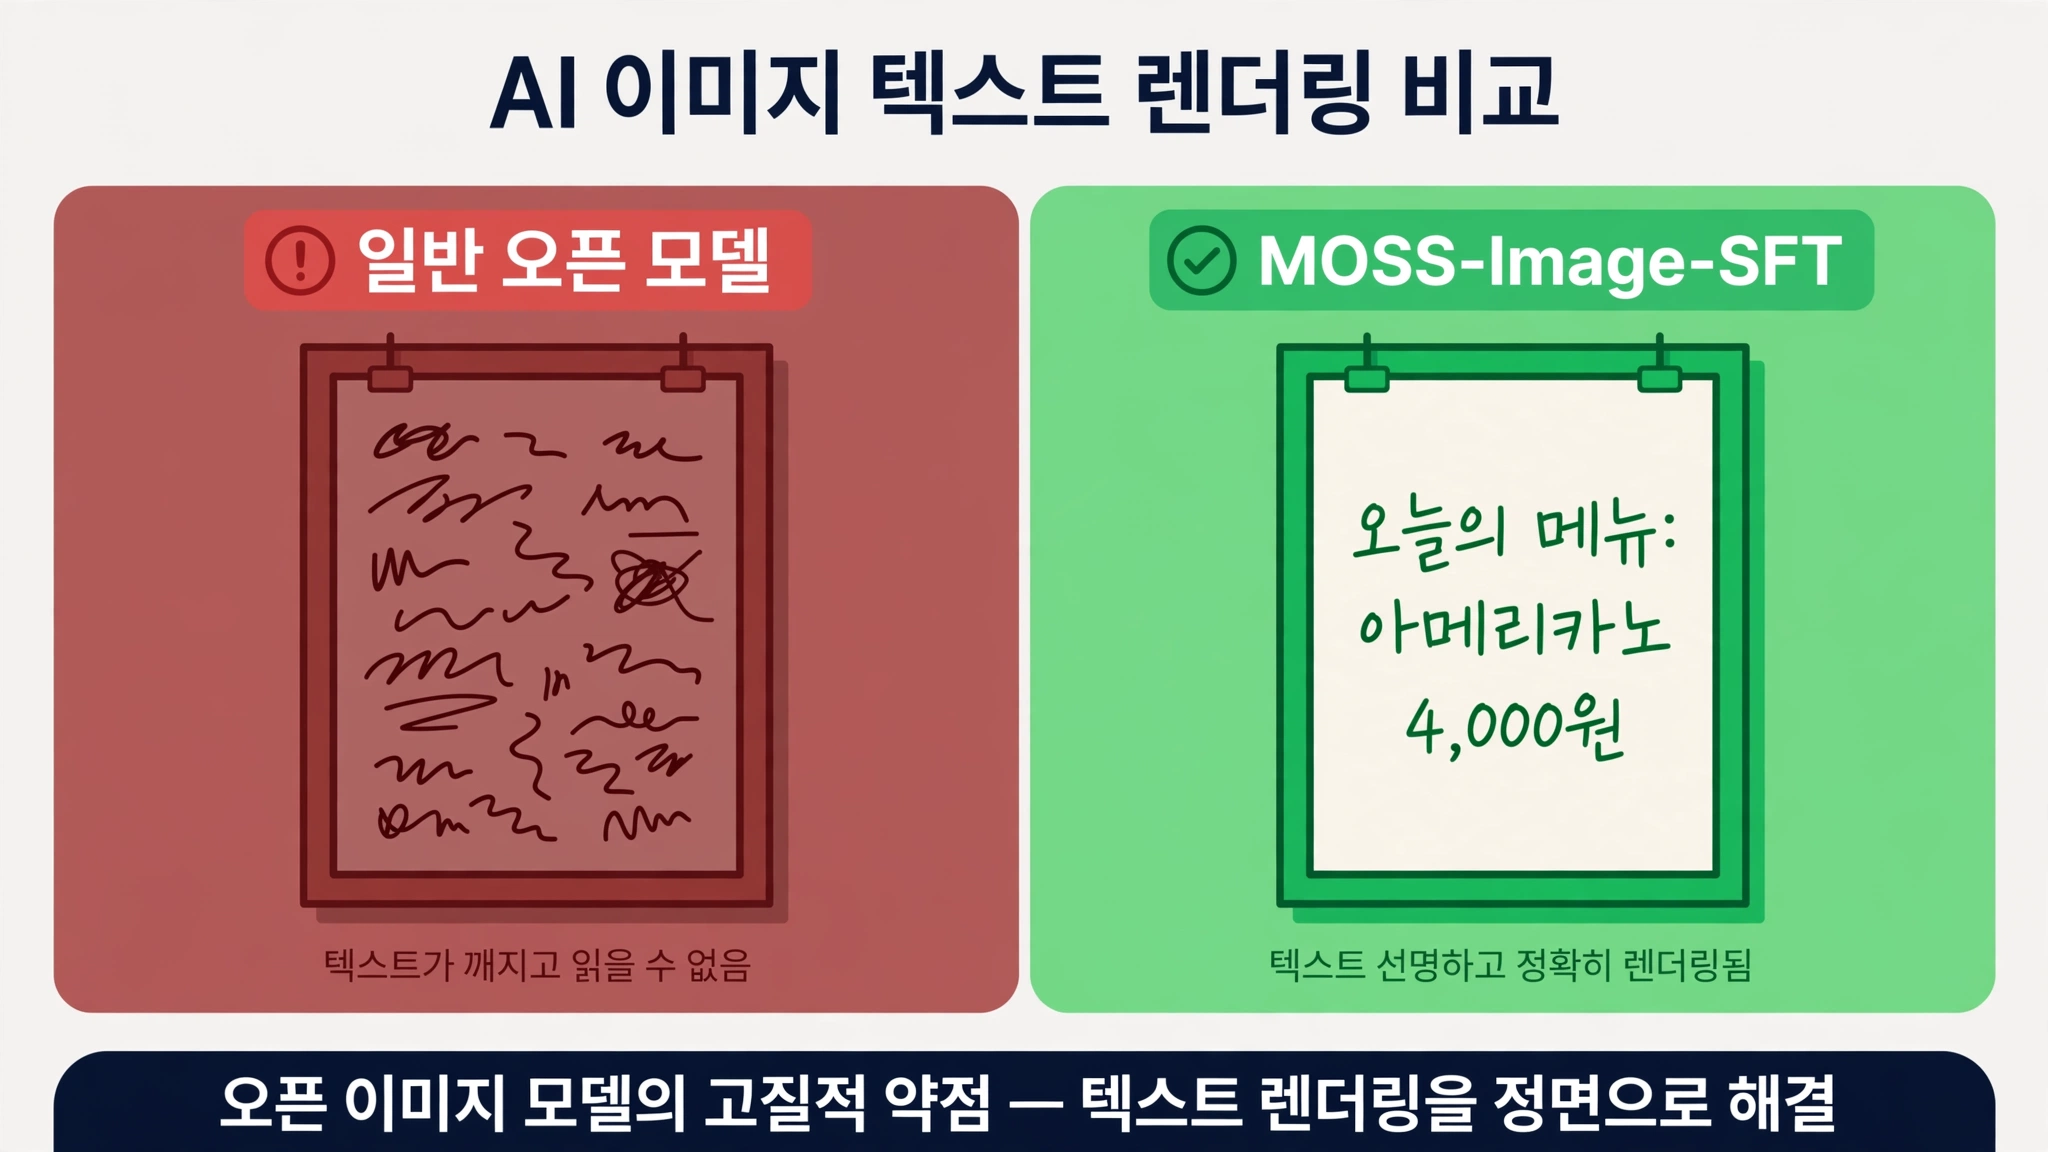
FLUX·Qwen-Image 등 오픈 가중치 모델들도 텍스트 렌더링이 많이 좋아졌지만, 포스터·썸네일·UI 목업처럼 글자가 핵심인 이미지는 여전히 상용 모델의 영역으로 여겨졌다. MOSS-Image는 이 지점을 정면으로 파고든다: 모델카드의 SFT vs Base 비교 예시에서 Base가 헤매는 텍스트 그룹화·레이아웃 정돈을 SFT가 잡아내는 모습을 직접 보여준다. 영어는 물론 중국어 손글씨 메모 예시까지 싣고 있다는 점에서 이중언어(영·중) 텍스트 처리를 의식한 설계로 보인다.
JSON 레이아웃으로 텍스트 배치·객체 배열 제어
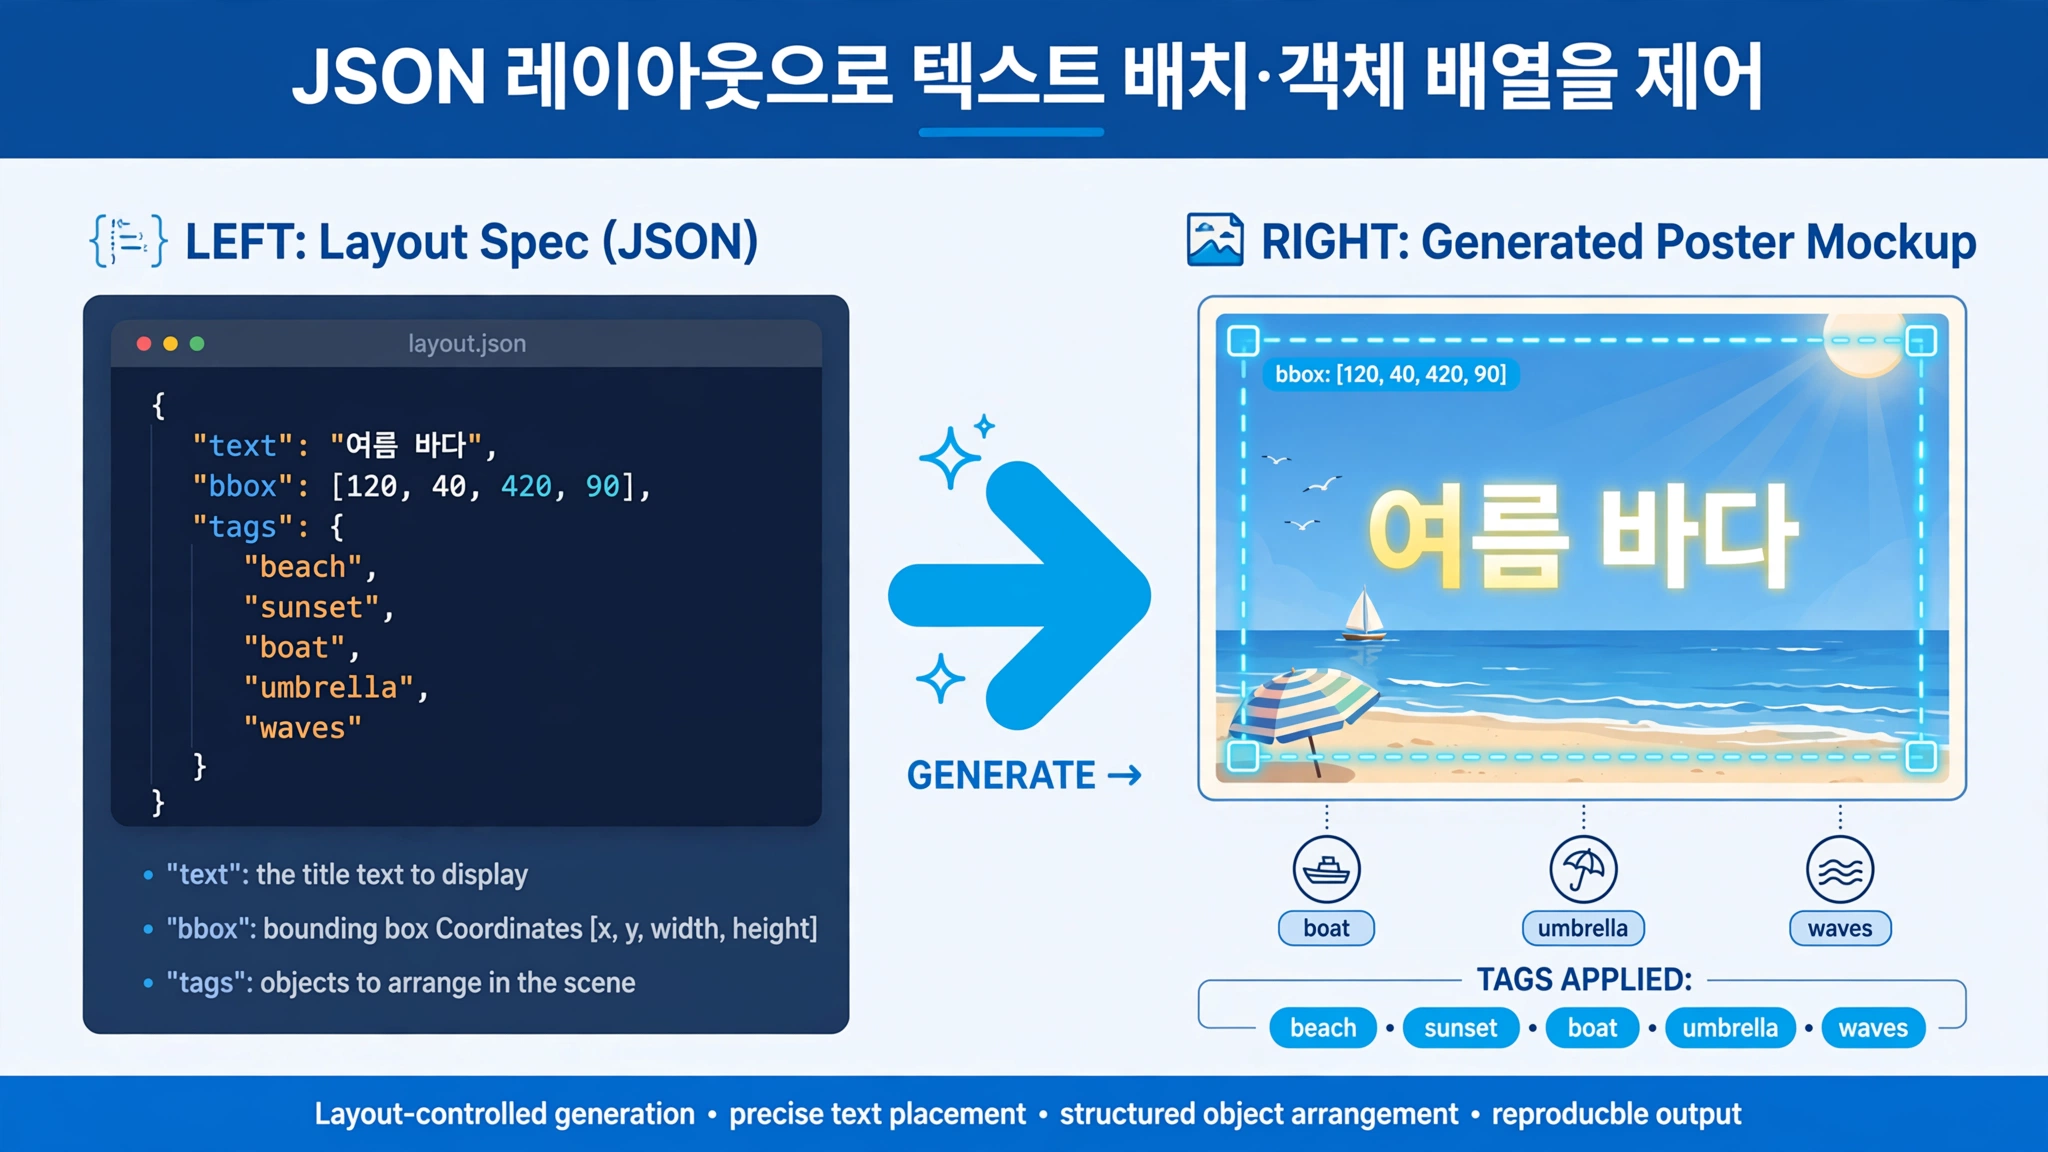
MOSS-Image-SFT의 또 다른 차별점은 레이아웃을 명시적으로 제어할 수 있다는 점이다. 자연어 프롬프트만 던지는 방식과 달리, 태그 시퀀스와 JSON 레이아웃(text·bbox 형태)으로 어떤 텍스트를 어느 위치에 놓을지 지정할 수 있다. 포스터·광고 소재처럼 "제목은 여기, 가격은 여기"가 정해져 있는 실무 작업에서는 프롬프트 운에 맡기는 것보다 훨씬 예측 가능한 워크플로우다.
실행: diffusers + ComfyUI
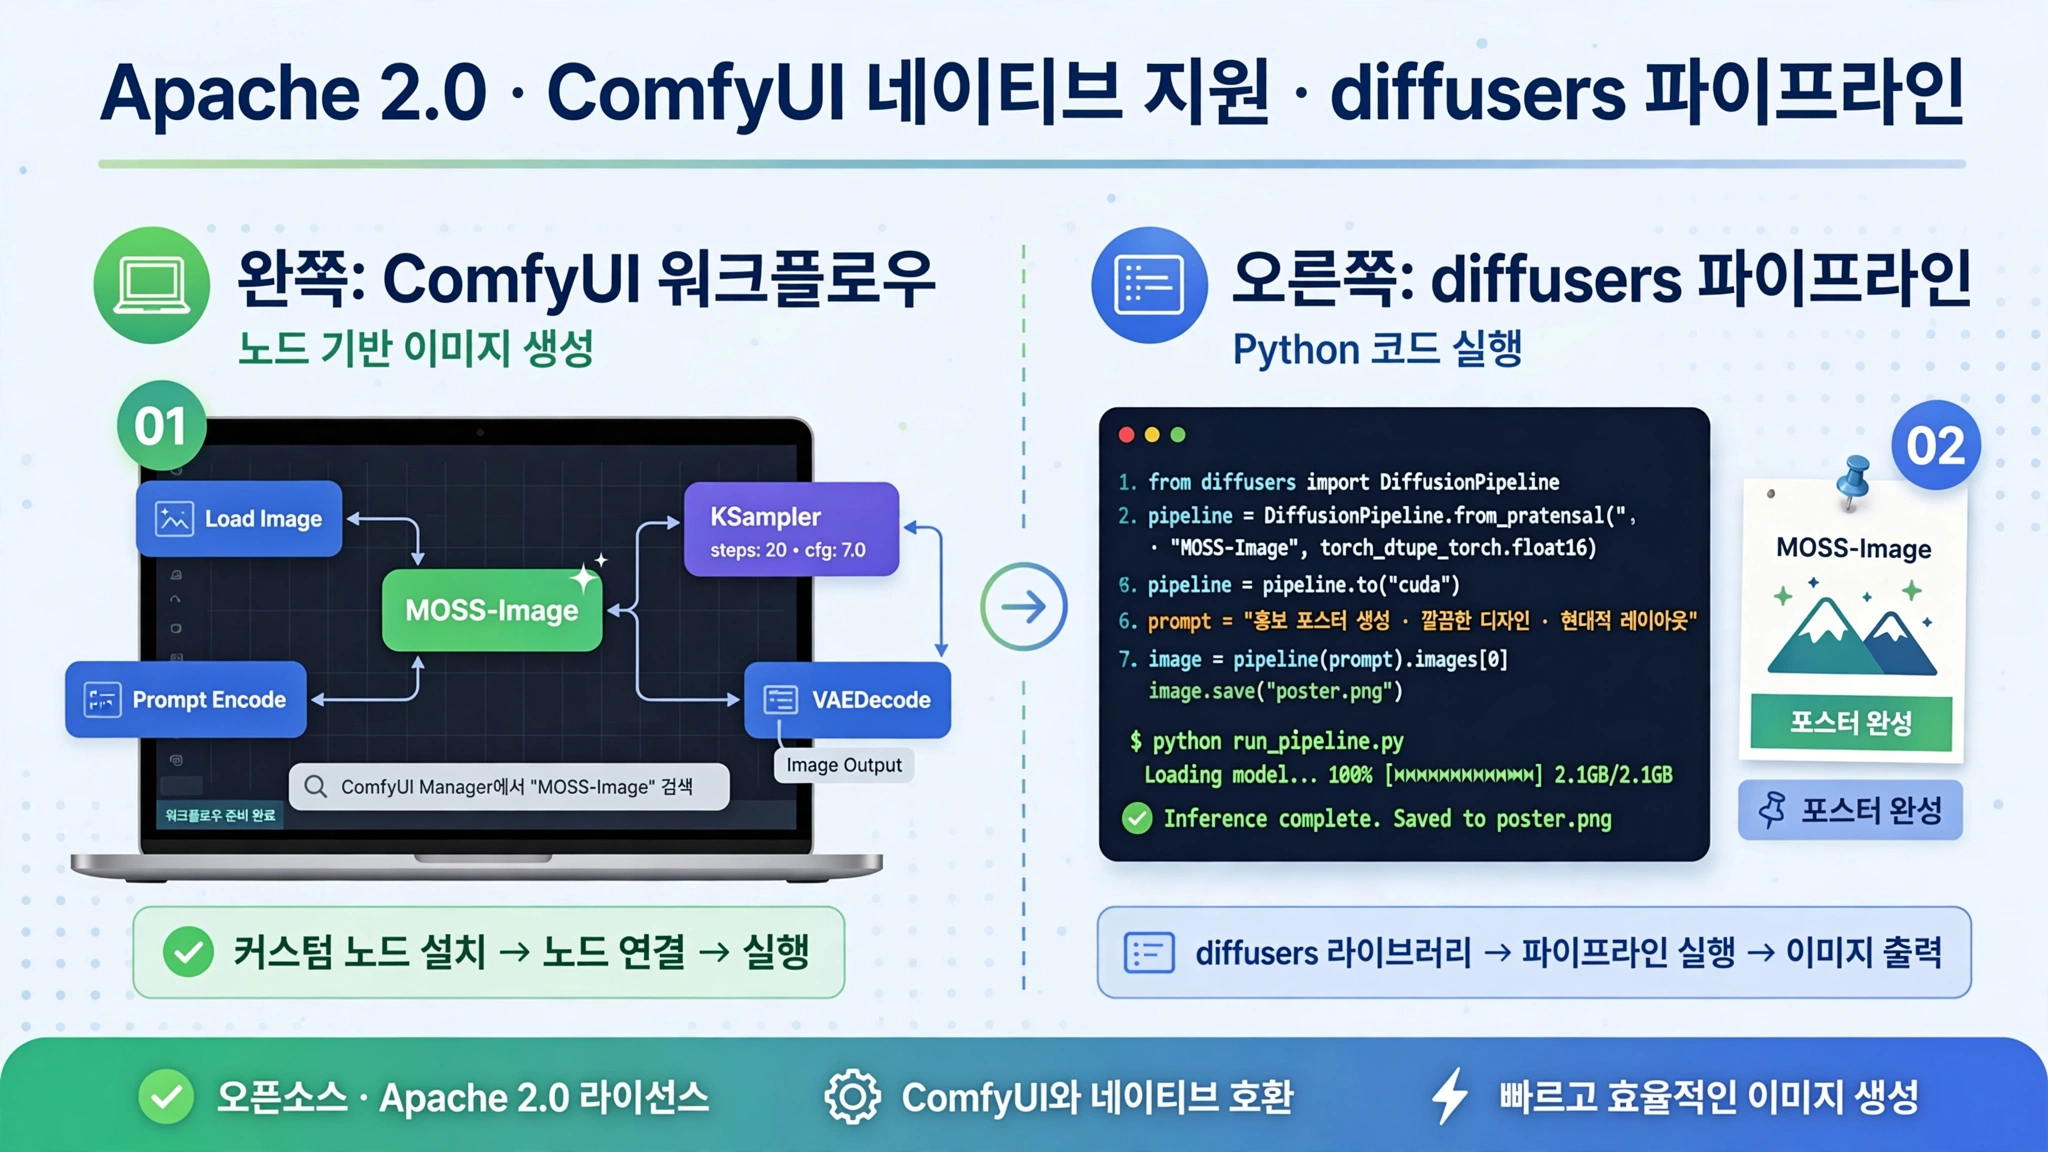
사용 경로는 두 가지다. diffusers 파이프라인으로 바로 붙거나, ComfyUI Manager에서 "MOSS-Image" 플러그인을 설치해 기존 노드 그래프에 끼운다. Apache 2.0이라 상업 이용도 자유롭다.
# diffusers 경로 (모델카드의 사용법 예시 기반, 실제 파라미터는 모델카드 참조)
from diffusers import DiffusionPipeline
import torch

pipe = DiffusionPipeline.from_pretrained(
    "OpenMOSS-Team/MOSS-Image-SFT",
    torch_dtype=torch.bfloat16,
    trust_remote_code=True,   # 커스텀 파이프라인 방식: 코드 실행 전 레포 검증 권장
).to("cuda")

image = pipe(
    "a cozy cafe poster with warm lighting",
    # 태그 시퀀스·JSON 레이아웃으로 텍스트 배치 제어 (형태는 모델카드 참조)
    num_inference_steps=28,
).images[0]
image.save("poster.png")
주의 (미확인): 공개 벤치마크 점수나 타 모델(Qwen-Image·FLUX 등)과의 정량 비교는 모델카드에 없다 — "강점" 주장은 모델카드의 정성 예시에 기반한다. 학습 데이터 규모·구성도 미공개다. 커스텀 파이프라인 방식이라 trust_remote_code=True가 필요하므로 실행 시 보안상 주의가 필요하다.
AX TF 관점: 에이전트가 UI 목업·썸네일·발표 자료를 만들 때 텍스트가 깨지면 후처리 비용이 크다. 텍스트 렌더링이 강한 오픈 모델이 하나 더 들어오면 에이전트 시각 산출물 파이프라인의 선택지가 넓어진다. 단, 정량 벤치가 없으므로 도입 전에는 우리 작업 유형(한글 포함 목업)으로 직접 비교 평가가 먼저다 — 모델카드의 중·영 중심 예시가 한글에도 그대로 적용되는지는 미검증이다.