Nanbeige4.3-33B: 512K 컨텍스트 오픈웨이트 에이전트 모델, Terminal 80.9
티처가 먼저 나왔다
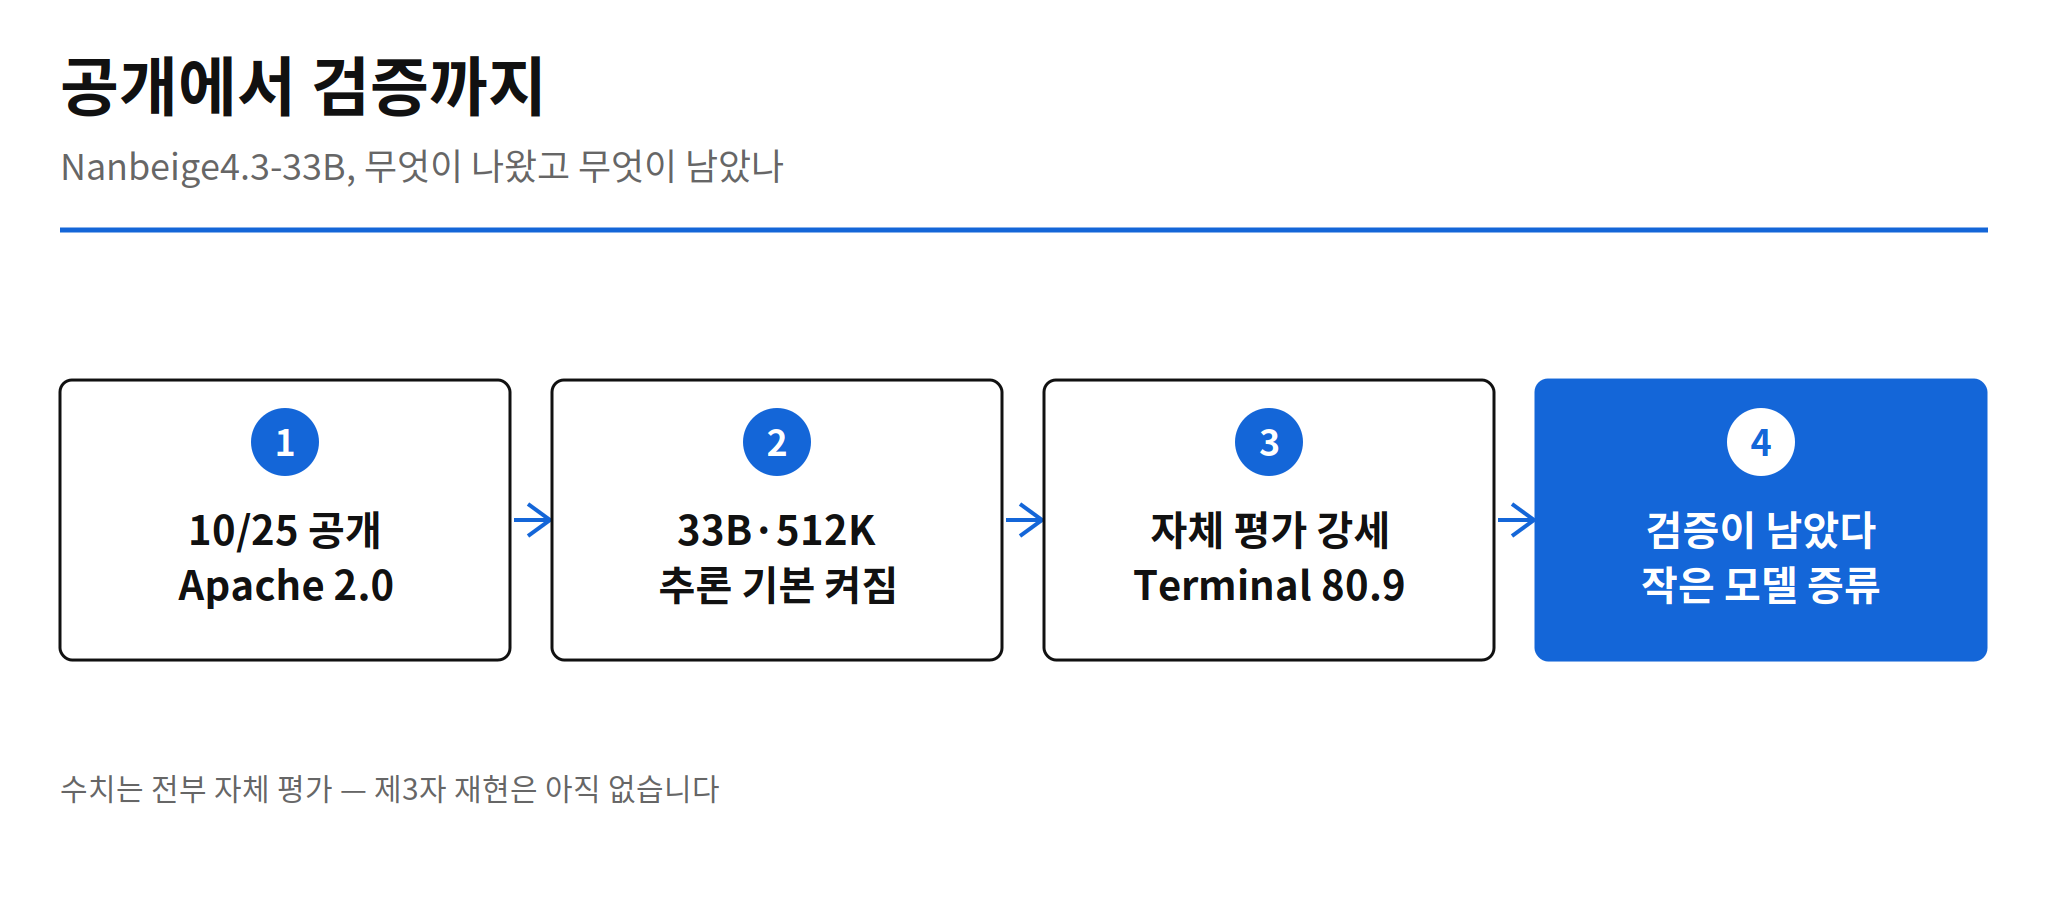
Nanbeige LLM Lab은 10월 25일 Hugging Face에 오픈웨이트 에이전트 모델 Nanbeige4.3-33B를 공개했습니다. 파라미터 규모는 33B, 컨텍스트는 최대 524,288토큰(512K)입니다. 추론(reasoning) 모드는 기본으로 켜져 있습니다.
여기서 눈여겨볼 지점은 순서입니다. 이 33B 모델은 Nanbeige4.3 시리즈의 플래그십 티처 모델이고, 연구팀 설명에 따르면 이후 작은 모델(예: Nanbeige4.3-3B)로 증류하는 토대가 됩니다. 즉 이번 공개의 본질은 33B 자체보다, 여기서 뽑아낼 작은 모델에 있습니다. 작은 모델이 나와야 실전 제품이 된다는 구상입니다.
Nanbeige는 중국 채용 플랫폼 BOSS Zhipin(칸준)의 AI 연구팀입니다. 앞서 3B급 Nanbeige4 시리즈를 낸 바 있습니다. 30B급은 대형 클러스터 없이 직접 돌릴 수 있는 규모라, 오픈 모델 진영에서 에이전트용 기준 모델 자리를 놓고 Qwen3.8-27B와 경쟁하는 구간이기도 합니다.
숫자는 어디서 강하고, 어디서 밀리나
같은 하네스·최고 추론 설정에서 잰 자체 평가에서 Terminal-Bench 2.1 80.9(Qwen3.8-27B 73.0), DeepSWE 65.5(42.5)를 기록했습니다. 코워크 평가에서도 Automation Bench 54.2(38.3), JobBench 44.8(34.5)입니다. 터미널·저장소 작업 중심 에이전트에 바로 연결되는 지점에서 강세가 두드러집니다.
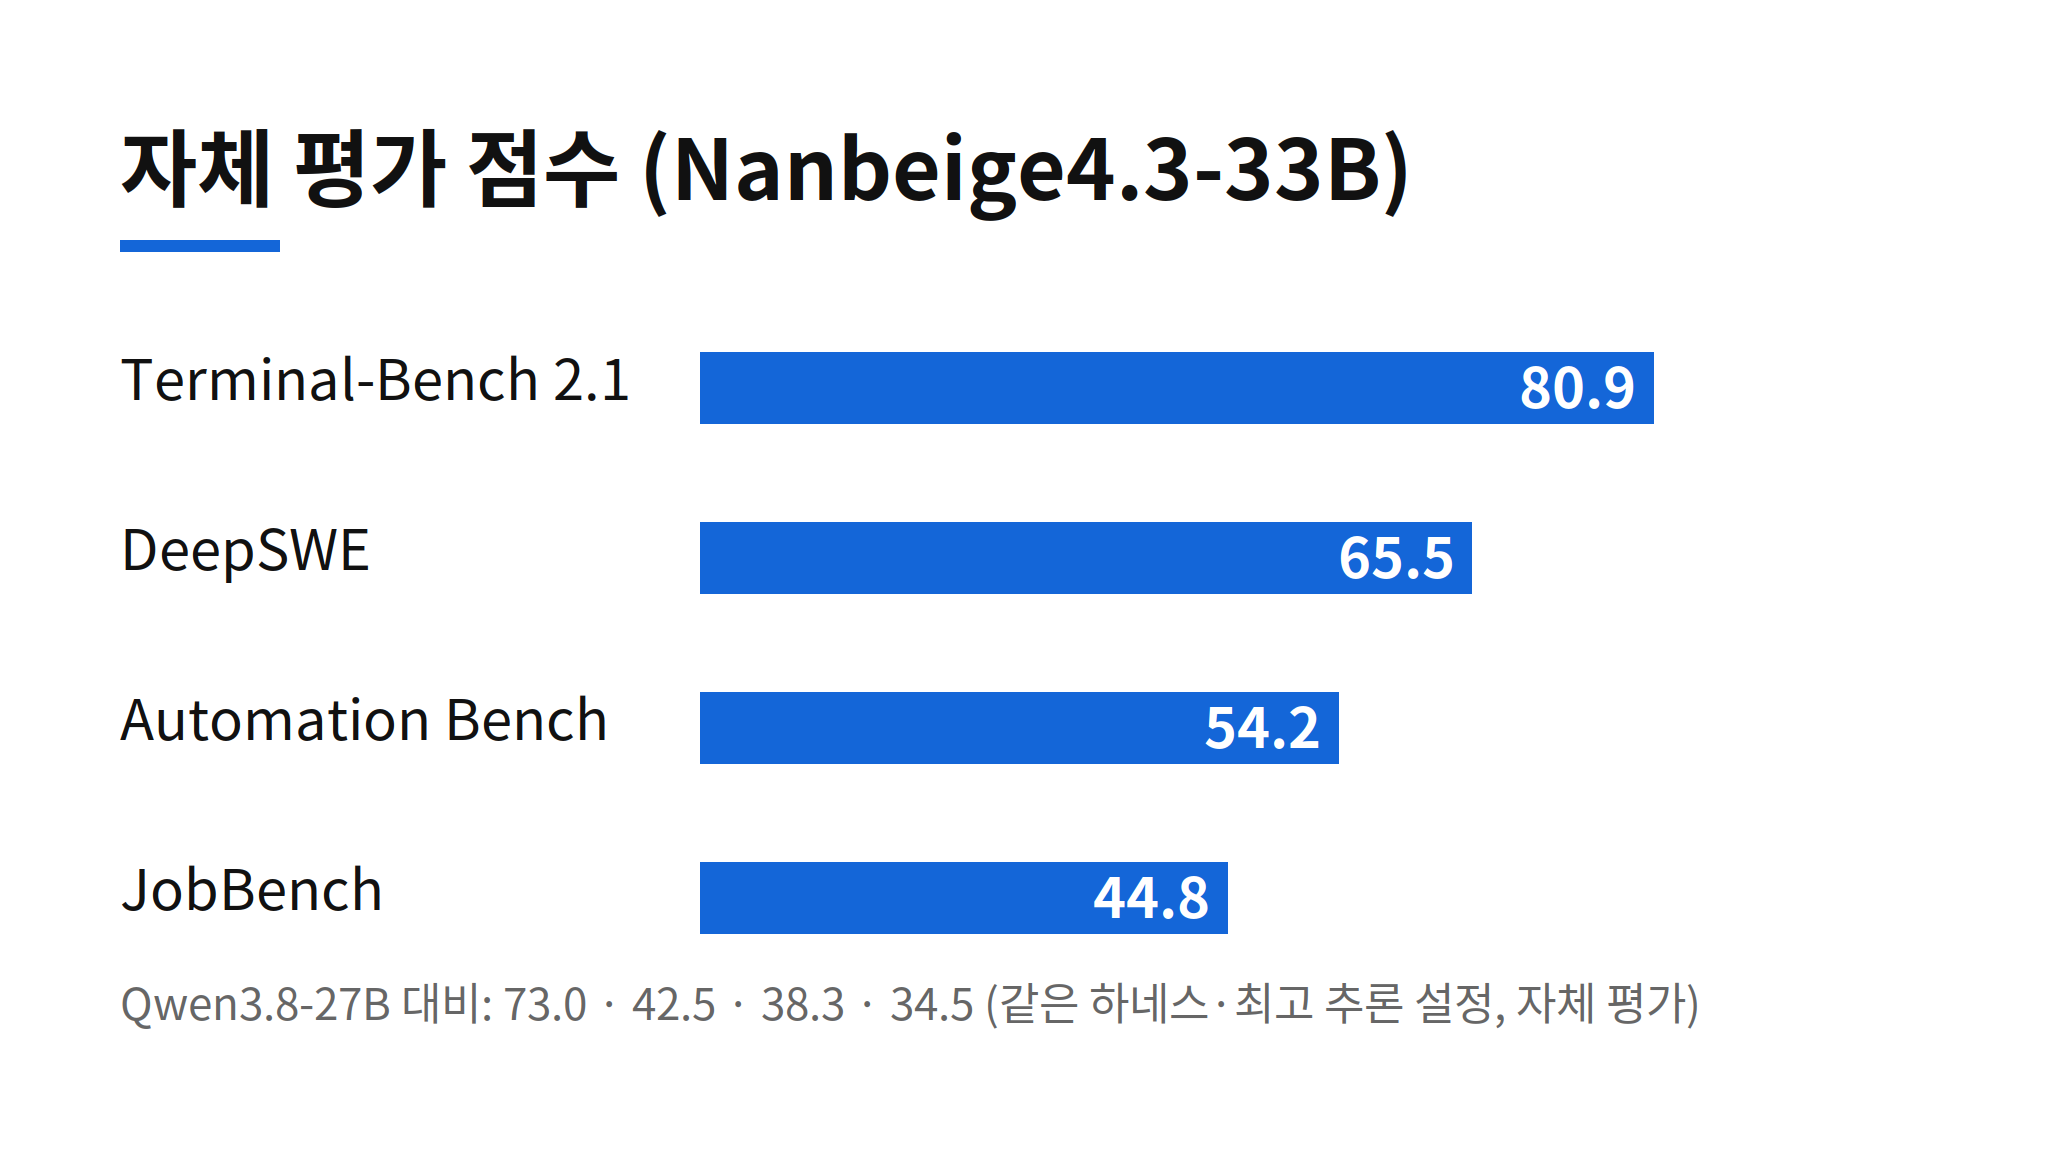
하지만 싹쓸이는 아닙니다. SWE-Bench Pro는 60.3으로 Qwen3.8-27B 61.7에 뒤졌고, GDPval 84.8도 86.4에 뒤졌습니다. GPQA Diamond 89.5는 Gemma4-31B 91.3이 앞섰습니다. 강점과 약점이 벤치마크마다 갈린다는 점, 이게 이번 공개를 읽는 가장 정확한 자세가 아닐까요.
직접 돌리려면 무엇이 필요한가
라이선스는 Apache 2.0이고, Base 버전도 함께 나왔습니다. Transformers·SGLang·vLLM으로 실행할 수 있습니다. SGLang·vLLM 실행 예시는 텐서 병렬 크기 4를 쓰며, BF16 기준 약 66GB, 4비트 양자화 기준 약 20GB가 필요하다는 보도가 있습니다. 4비트라면 단일 고성능 GPU 환경에서도 검토해볼 만한 규모입니다.
33B급 에이전트 모델이 Qwen 수준을 넘었다는 주장보다, 티처에서 작은 모델로 증류하는 구조가 중요합니다.
아직 확인되지 않은 것들
- 수치 전부가 자체 평가입니다. 같은 하네스·최고 추론 설정이라는 조건도 연구팀 주장이며, 제3자 재현은 아직 없습니다.
- 공개 시점 표기가 엇갈립니다. 한 보도는 Hugging Face 공개일을 10월 24일로 적었고, 공식 X 발표는 10월 25일 12:11(UTC)로 전해집니다. 이 글은 공식 발표일 10월 25일을 기준으로 삼았습니다.
- 학습 데이터 구성·학습 비용은 미확인입니다. 모델 카드에 나와 있지 않습니다.
실무 판단은 이렇게 정리됩니다. 코딩 에이전트를 직접 돌리는 팀에게는 30B급 오픈 모델 선택지가 하나 더 늘었습니다. 다만 수치는 자체 평가라, 작은 모델이 나오기 전까지는 후보군 하나로 보고 검증하는 편이 안전합니다.
원문 이슈
- Hugging Face 모델 카드: Nanbeige/Nanbeige4.3-33B (2026-10-25)
- AI Weekly: Nanbeige Opens 33B Model With Apache 2.0 and 512K Context (2026-10-25)
- Startup Fortune: Nanbeige's New 33B Open Model Takes Aim at Qwen and Gemma on Coding (2026-10-25)
- ax-trend 이슈 #3534
- 관련 이슈 #3498 — Moonshot AI, 'Kimi K3.1 Pro' 정식 출시
- 관련 이슈 #3063 — Conway Research, 온디바이스 AI 비서 'Underdog' 초대 베타 출시