코딩 에이전트 CI 병목 원인과 개선 기법 — Anthropic·Linear 플레이북 정리
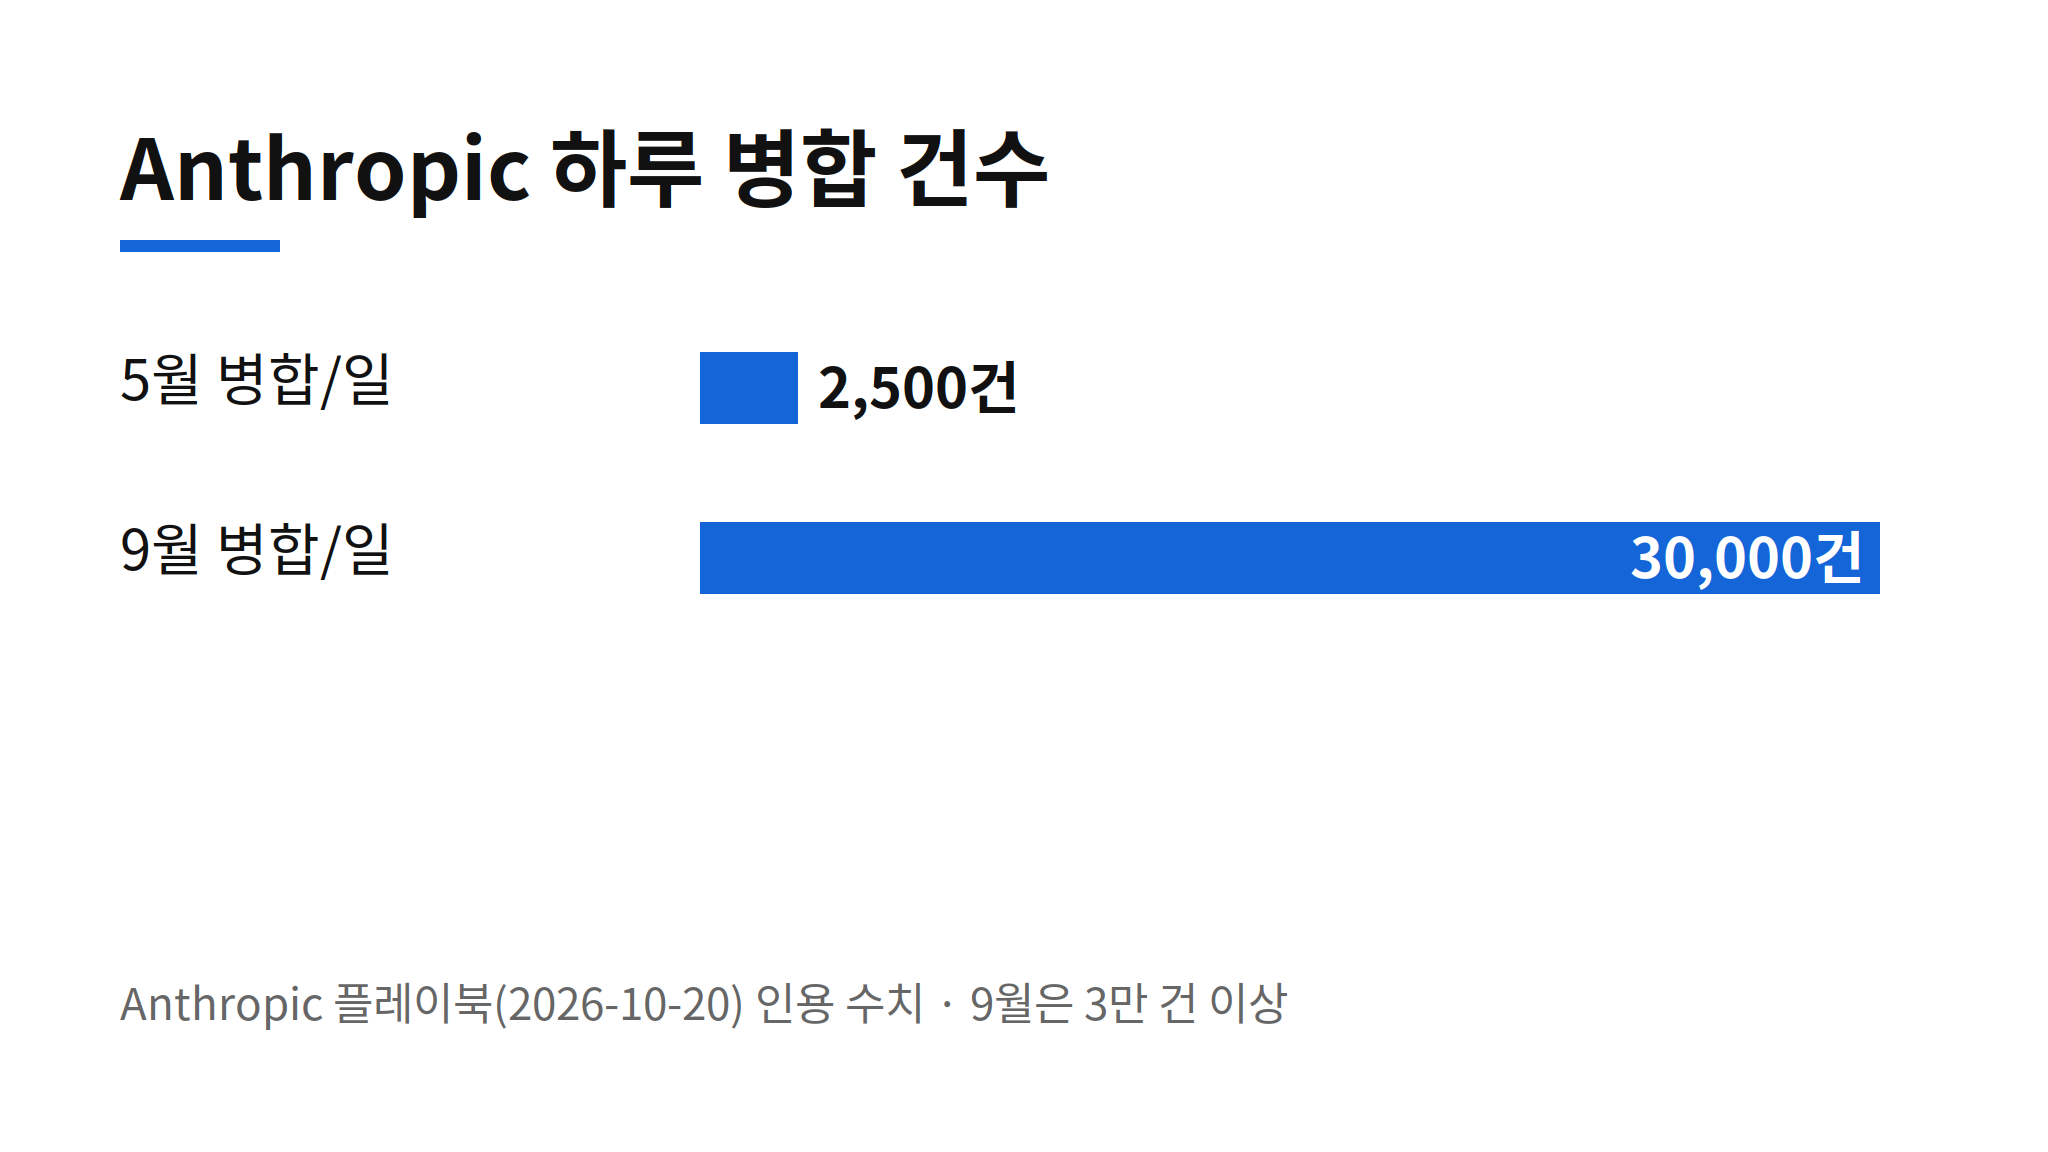
에이전트 코딩 도입 팀의 다음 병목은 모델이 아니라 CI라는 진단이 X에서 논쟁으로 번졌습니다. 코드를 쓰는 속도는 이미 올라갔고, 그 코드를 검증하는 파이프라인이 뒤처지고 있다는 것입니다. Anthropic 플레이북(2026-10-20)에 따르면 Anthropic의 CI 작업량은 6개월 만에 25배로 늘었고, 하루 병합 건수는 5월 약 2,500건에서 9월 3만 건 이상으로 뛰었습니다. Linear 플레이북(2026-10-14)의 15가지 개선과, 테스트를 4배로 늘리고도 PR 대기를 약 5분까지 줄인 팀 사례가 함께 인용됐습니다.
두 플레이북의 해법은 방향이 같습니다. 평소에는 변경이 닿는 범위만 좁게 돌리고, 병합 지점에서 전체 스위트로 신뢰를 확보하는 것입니다. 먼저 밝혀둘 주의점도 있습니다. 이 글의 핵심 수치는 각사의 1차 발표가 아니라 정리글을 통한 2차 인용이며, 1차 출처는 확인되지 않았습니다.
CI 병목의 원인 — 인간 출력용으로 설계된 파이프라인
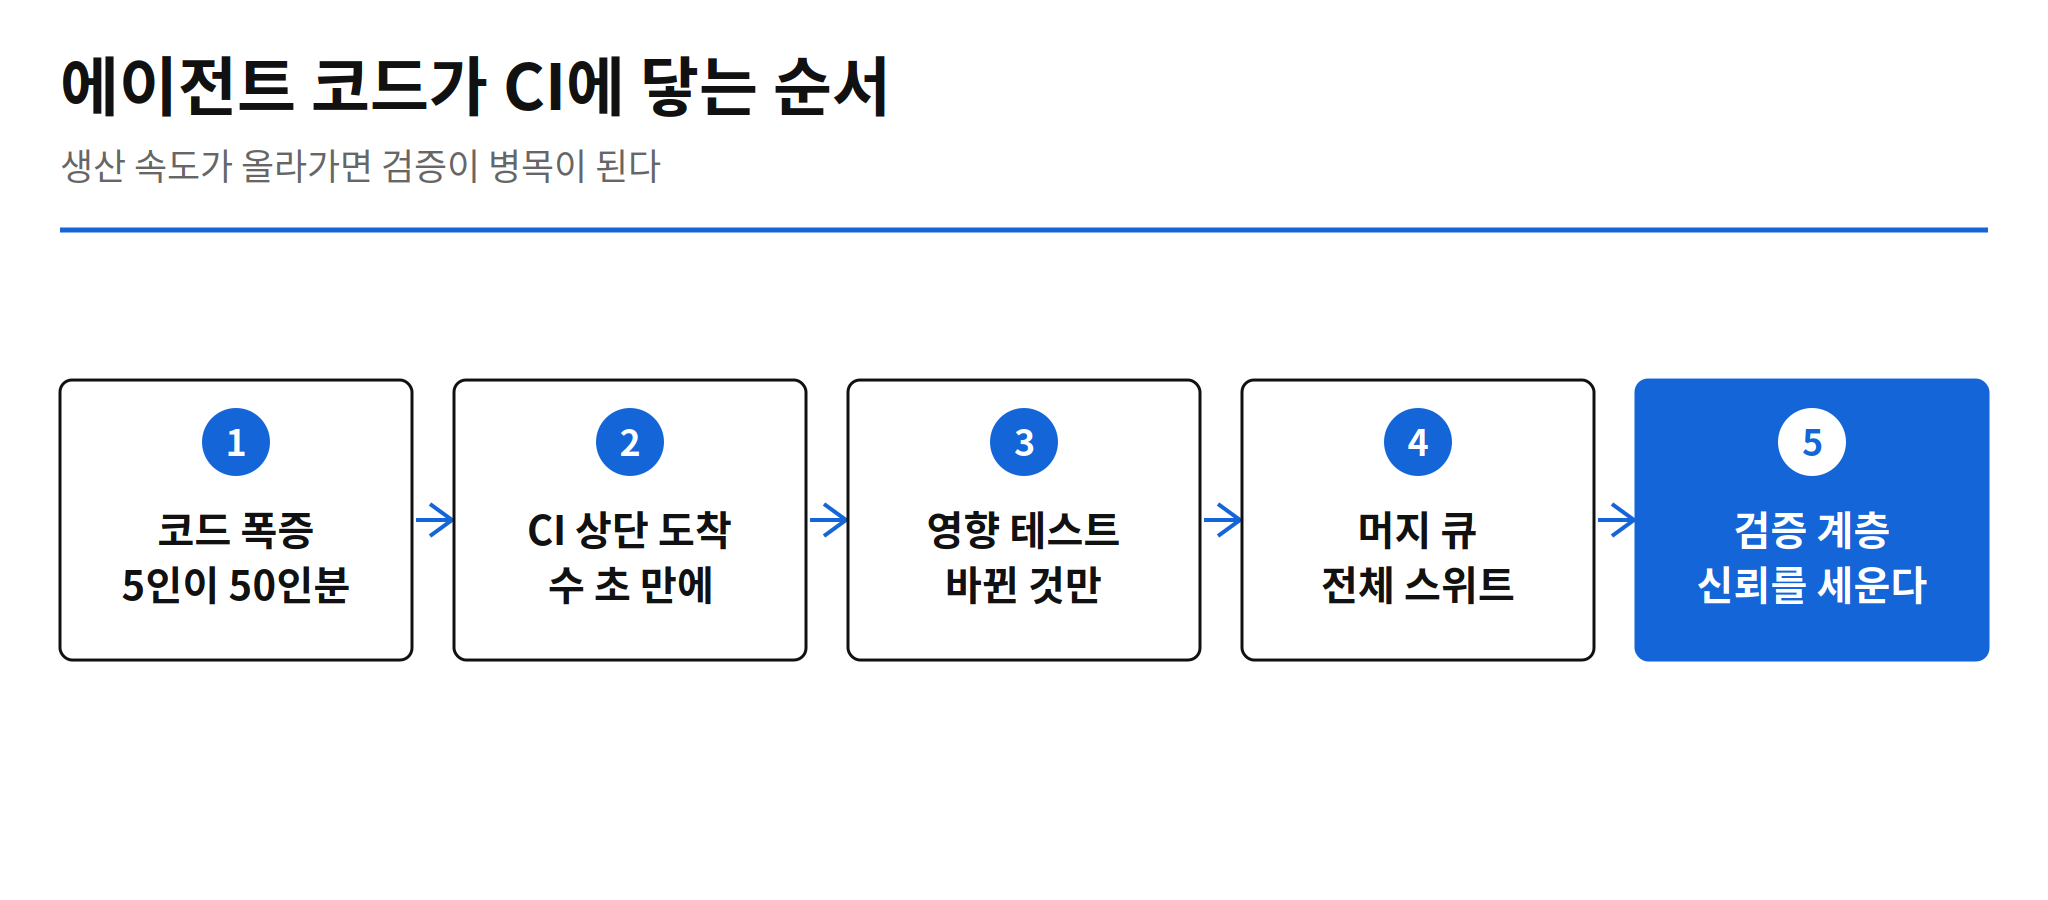
@mihail_eric은 2026-10-26에 이렇게 진단했습니다. Anthropic, Linear 등 여러 회사가 AI 소프트웨어 개발에서 CI라는 동일한 벽에 부딪히고 있습니다. 20년간 CI는 인간 출력용으로 설계됐는데, 5인 팀이 50인 팀 분량 코드를 만들고 그 전부가 CI 파이프라인 상단에 수 초 만에 도착합니다. 인간의 작업 리듬에 맞춰 설계된 큐와 실행 단위가, 기계의 출력 속도를 전제로 다시 설계돼야 하는 상황이 된 것입니다.
논쟁은 X에서 퍼졌습니다. mihail 글은 조회수 24,981회·북마크 103개를, @yonasbe의 인용글은 조회수 16,178회·북마크 373개를 기록했습니다. 인용글의 북마크가 원글보다 많은 점도 이 주제가 현장 실무자의 저장 목록에 들어갔다는 신호로 읽힙니다.
부하 폭증의 수치 — Anthropic CI 작업량 6개월 25배
Anthropic은 이 부하를 감당하려고 자체 테스트 선택 시스템을 만들었습니다. 플레이북의 조언은 직설적입니다. 두 분기 안에 25배 부하에 이를 것으로 가정하라는 것입니다. 두 수치를 대조하면 읽을 거리가 하나 더 생깁니다. 병합 건수는 2,500건에서 3만 건으로 약 12배 늘었는데 작업량은 25배 늘었습니다. 건수 증가만으로는 설명이 안 되는 나머지는, 변경당 실행되는 테스트와 워크플로 자체가 무거워졌다는 쪽으로 읽힙니다. 건당 비용이 같이 커지는 구조라, 러너를 늘리는 대응만으로는 따라잡기 어렵다는 것이 이 대조가 말하는 바로 보입니다.
작은 설정 하나가 큰 비용이 되는 사례도 있습니다. 기본 설정에서 멈춘 잡이 러너를 6시간 점유할 수 있습니다. 부하가 25배가 되면 이런 누수는 건당 손실이 아니라 상시 점유로 바뀝니다. 러너 수를 늘리는 것만으로는 이런 누수를 잡지 못합니다.
PR 대기 5분 사례 — 작은 수정의 누적 효과
mihail이 든 한 팀 사례는 이렇게 정리됩니다. 테스트를 4배로 늘렸는데도 열댓 가지 작은 수정을 묶어 PR 대기 시간을 약 5분까지 줄였습니다. 수정 목록은 tsgo, oxlint, sparse checkout, 사전 설치 의존성, 균형 잡힌 테스트 샤드입니다.
눈여겨볼 점은 거창한 교체가 없다는 것입니다. 타입 검사기와 린터를 바꾸고, 체크아웃 범위를 줄이고, 의존성을 미리 깔고, 테스트를 고르게 나누는 작업의 합이 대기 시간을 만들었습니다. 각 항목은 작지만 파이프라인 전체에 걸치면 체감 속도가 달라집니다. 다만 이 사례는 익명 일화라 어느 팀인지, 재현 가능한 조건인지는 미확인입니다. 5분이라는 숫자는 목표가 아니라 참고치로 두는 편이 안전합니다.
Anthropic 플레이북의 다섯 가지 기법
Anthropic 플레이북이 제시한 기법은 다섯 가지입니다.
- 영향받는 테스트만 실행 — 변경이 닿는 테스트에 실행 범위를 좁힙니다.
- 전체 스위트는 main·머지 큐에서 — 모든 테스트는 병합 지점에서 전부 돌립니다.
- 영향 없는 워크플로 건너뛰기 — 변경과 무관한 워크플로는 아예 실행하지 않습니다.
- 변경당 CI 1회 — 하나의 변경에 CI 실행을 하나로 묶습니다.
- 불안정 잡 시간 상한 — 멈춘 잡이 러너를 오래 점유하지 못하게 상한을 둡니다.
이 목록의 핵심은 선택과 보장의 분리입니다. 평소에는 영향받는 범위만 빠르게 돌리고, 병합 지점에서는 전체 스위트로 신뢰를 확보합니다. 빠르게 돌리는 것과 전부 검증하는 것을 같은 단계에서 해결하려 하지 않습니다. 한국 팀의 GitHub Actions 환경에도 그대로 옮길 수 있는 항목이 대부분이지만, 첫 번째 기법에는 뒤에서 볼 한계가 붙습니다. 영향 분석 자체가 비싸지는 지점이 오기 때문입니다.
Linear 플레이북의 15가지 개선 — 설정 공유가 만든 가장 큰 성과
Linear 플레이북은 15가지 개선을 나열합니다. 빠른 러너 전환으로 잡 평균 34%, 타입체크 52%가 빨라졌습니다. 네이티브 타입 검사, oxlint 전환, 얕은 체크아웃, 캐시 쓰기 크리티컬 패스 밖 이동, 샤드 4개에서 8개로 확대, 테스트 파일 간 설정 공유가 포함됩니다. 플레이북은 설정 공유가 가장 큰 성과였다고 밝히고 있습니다. 러너 교체 같은 하드웨어 성격의 개선보다, 테스트 파일 간 설정을 공유하는 구조 개선이 더 컸다는 대조는 실무 팀이 우선순위를 잡을 때 참고할 지점입니다.
Linear 사례가 Anthropic 사례와 겹치는 부분도 의미가 있습니다. 두 회사 모두 러너 교체 하나로 끝내지 않고, 타입 검사·린트·체크아웃·캐시·샤드·설정 공유까지 파이프라인 전반을 건드렸습니다.
스마트 테스트 선택의 한계와 검증 계층 전환
mihail은 스마트 테스트 선택의 한계도 지적했습니다. 변경이 닿는 테스트만 돌리는 영향 분석은 일정 작업량을 넘으면 버거워집니다. 선택 로직 자체가 무거워지는 지점이 온다는 것입니다. Anthropic의 다섯 가지 기법 중 첫 번째가 규모 앞에서 흔들릴 수 있다는 뜻이라, 플레이북을 그대로 베끼기보다 자사 작업량 구간에 맞는지를 먼저 가늠해야 합니다.
여기서 논쟁의 결론이 나옵니다. 엔지니어가 에이전트 코드를 전부 리뷰할 수 없어 CI가 신뢰를 세우는 검증 계층이 된다고 mihail은 봅니다. 리뷰가 사람을 거치는 품질 관문이었다면, 이제는 CI가 그 역할을 떠안고 있습니다. @yonasbe도 2026-10-27에 이 글을 인용하며 덧붙였습니다. CI 단축은 빠른 러너만의 문제가 아니며, 워크플로와 테스트 전반에 최적화가 필요합니다. 이 정리는 Chainguard Checks(10/14), Blacksmith 유니콘 등극(10/21)과 같은 흐름에 속합니다. 검증 인프라가 에이전트 시대의 다음 투자처가 되고 있다는 신호가 여러 갈래에서 겹치고 있습니다.
수치 출처에 주의가 필요합니다. Anthropic·Linear 수치는 각사 1차 발표가 아니라 yonasbe의 정리글을 통한 2차 인용입니다. 1차 출처는 미확인 상태입니다. mihail이 든 한 팀 사례도 익명 일화라 어느 팀인지, 재현 가능한 조건인지는 미확인으로 남습니다. 플레이북 링크는 70개 이상(Anthropic), 50개 이상(Linear)의 추가 최적화를 starsling.dev로 연결하는데, 전체 목록의 공개 범위도 미확인입니다.
실무 적용 순서 — 바로 적용할 것과 재기 전에 보류할 것
실무 적용은 이렇게 갈립니다. 영향 테스트 선별, 머지 큐 전체 스위트, 샤드·캐시 정리는 GitHub Actions에 바로 적용할 수 있습니다. 다만 수치가 2차 인용이라, 남의 수치를 그대로 목표 삼기 전에 자사 파이프라인에서 직접 재는 과정이 필요합니다. 이번 X 논쟁은 그 흐름을 현장 최적화 경험으로 묶은 의견형 정리라는 점에서 읽을 가치가 있고, 수치를 인용할 때는 출처의 층위를 함께 기억해야 합니다.