Code Comprehensor: 대규모 레포의 계층 문서·크로스모달 검색 하이브리드와 3단계 하이브리드
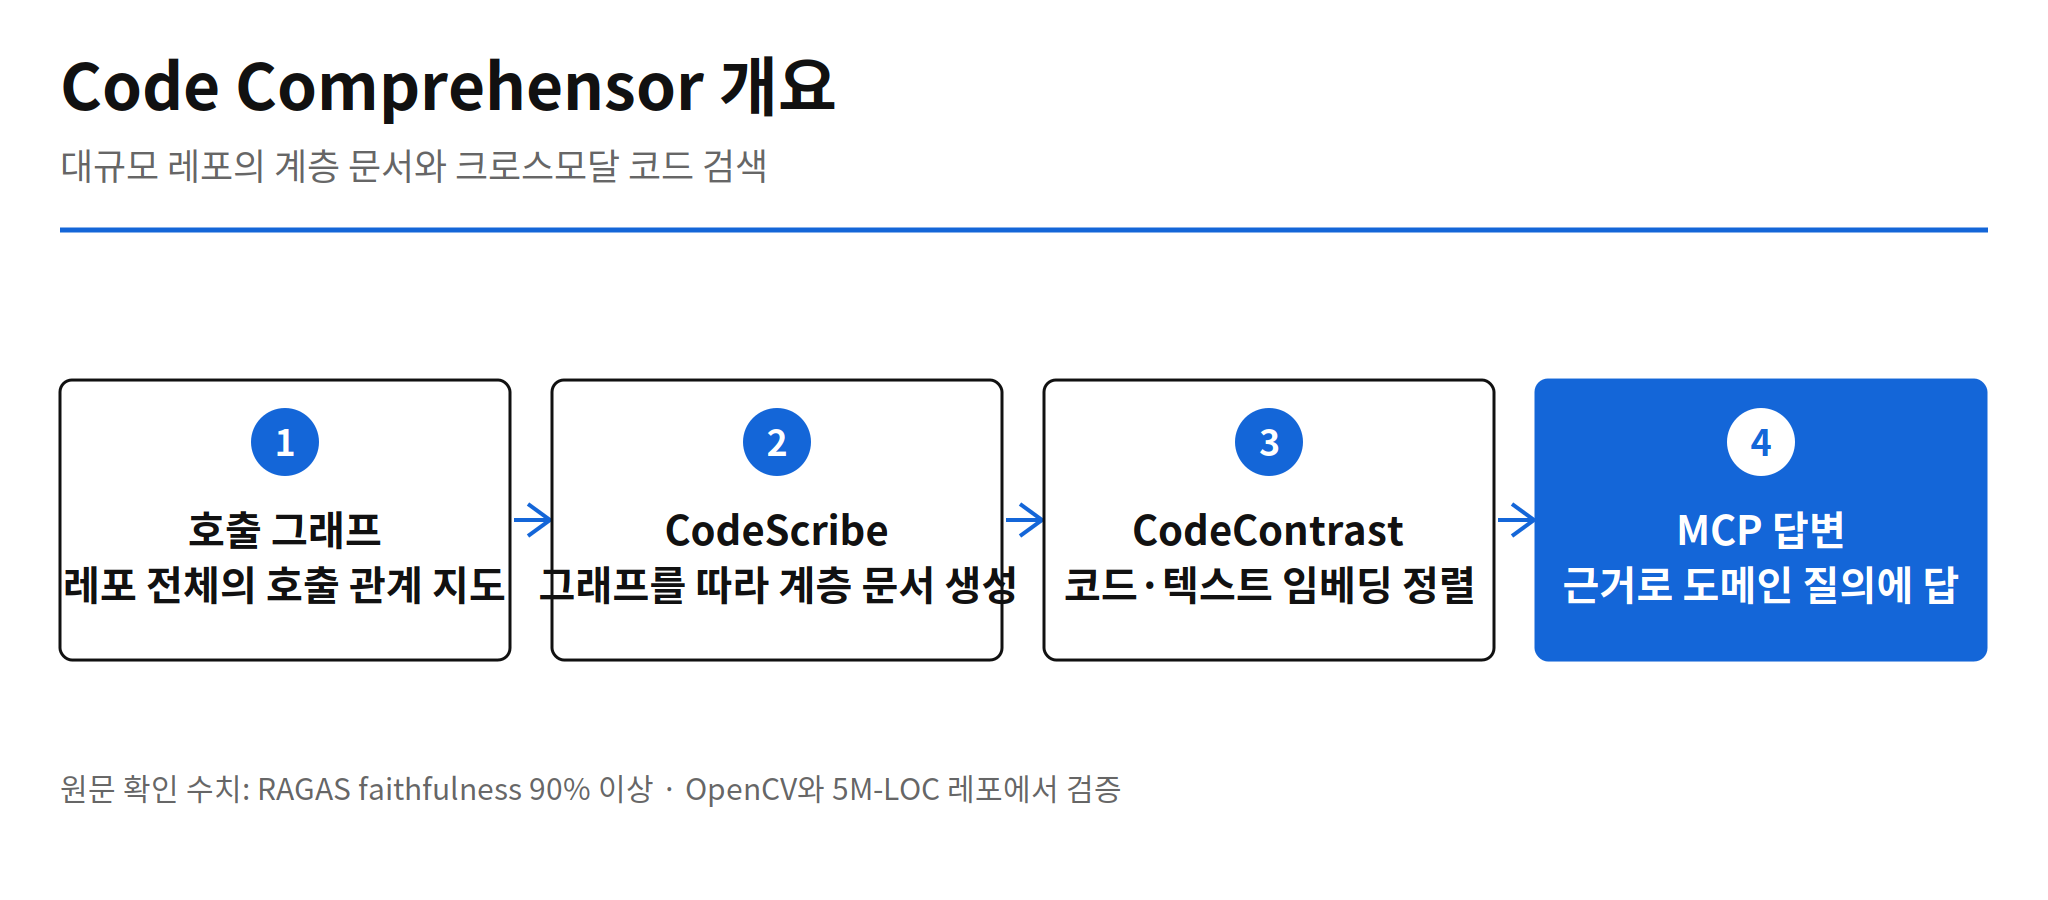
핵심 — 이 함수가 어디서 불리는지를 계층 문서와 의미 검색으로 답한다
- 크고 복잡하고 빨리 변하는 코드베이스를 이해하는 일은 온보딩·유지보수·리팩토링·영향 분석의 병목이다 (arXiv).
- LLM에 필요한 건 메서드 하나가 아니라 레포 전체 맥락에서의 연관 메서드다 (arXiv).
- Code Comprehensor는 검색으로 근거를 모으고 추론으로 답하는 하이브리드다 (arXiv).
- 구성은 세 단계다: CodeGraph(호출 그래프) → CodeScribe(계층 문서) → CodeContrast(크로스모달 검색), 마지막에 MCP 기반 LLM 오케스트레이터가 도메인 질의에 답한다 (arXiv).
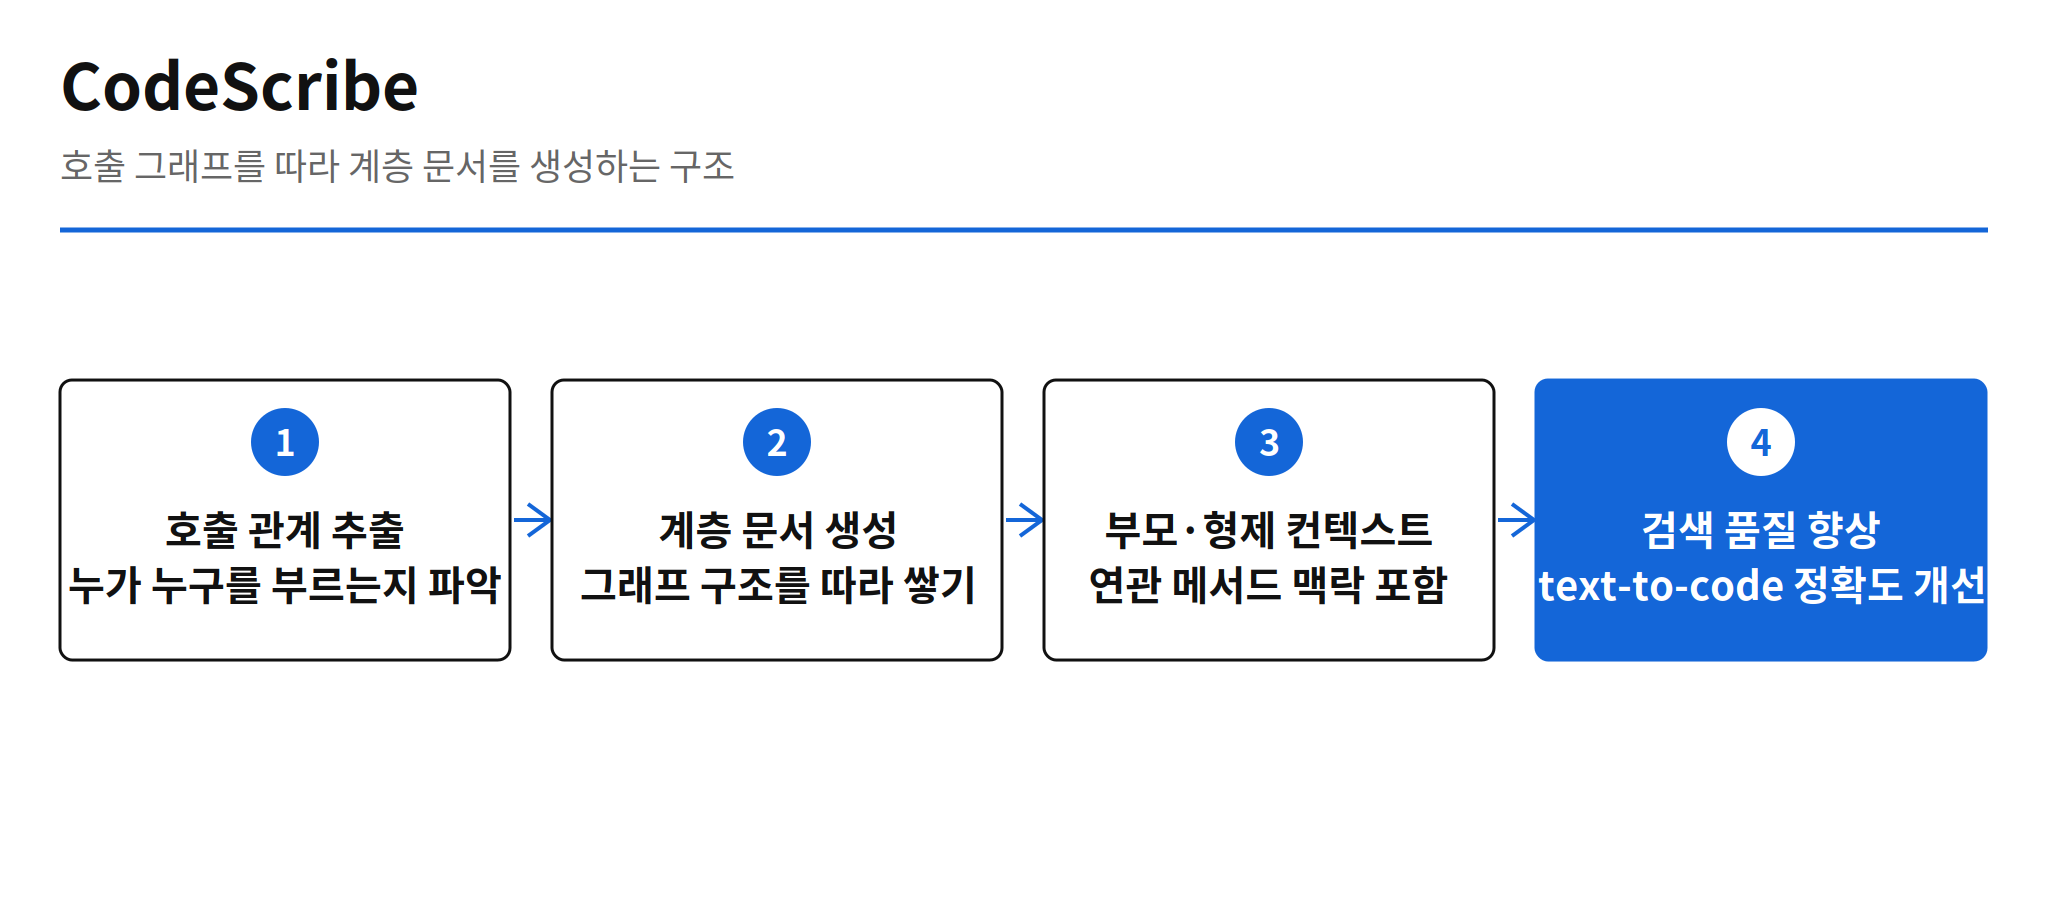
CodeScribe — 호출 그래프를 따라 계층 문서를 쌓는다
- CodeGraph는 코드 의존 호출 그래프다. 레포 전체의 호출 관계를 담은 지도 — 누가 누구를 부르는지의 전체 그림이다 (arXiv).
- CodeScribe는 코드 인식 LLM으로 호출 그래프에 계층 문서를 생성한다. 그래프 구조를 따라 문서를 쌓는다. 호출 관계를 따라 계층적으로 문서를 만든다 (arXiv).
- 계층 문서·부모/형제 컨텍스트·LLM 합성 질문 같은 풍부한 텍스트 지도가 두 레포에서 일관되게 성능을 높였다 (arXiv).
개념 흐름은 이렇게 읽힌다: 레포 전체를 정적 분석해 호출 그래프를 뽑고, 그래프 위를 LLM이 따라가며 각 노드에 문서를 붙인다. 문서가 곧 검색의 연료다.
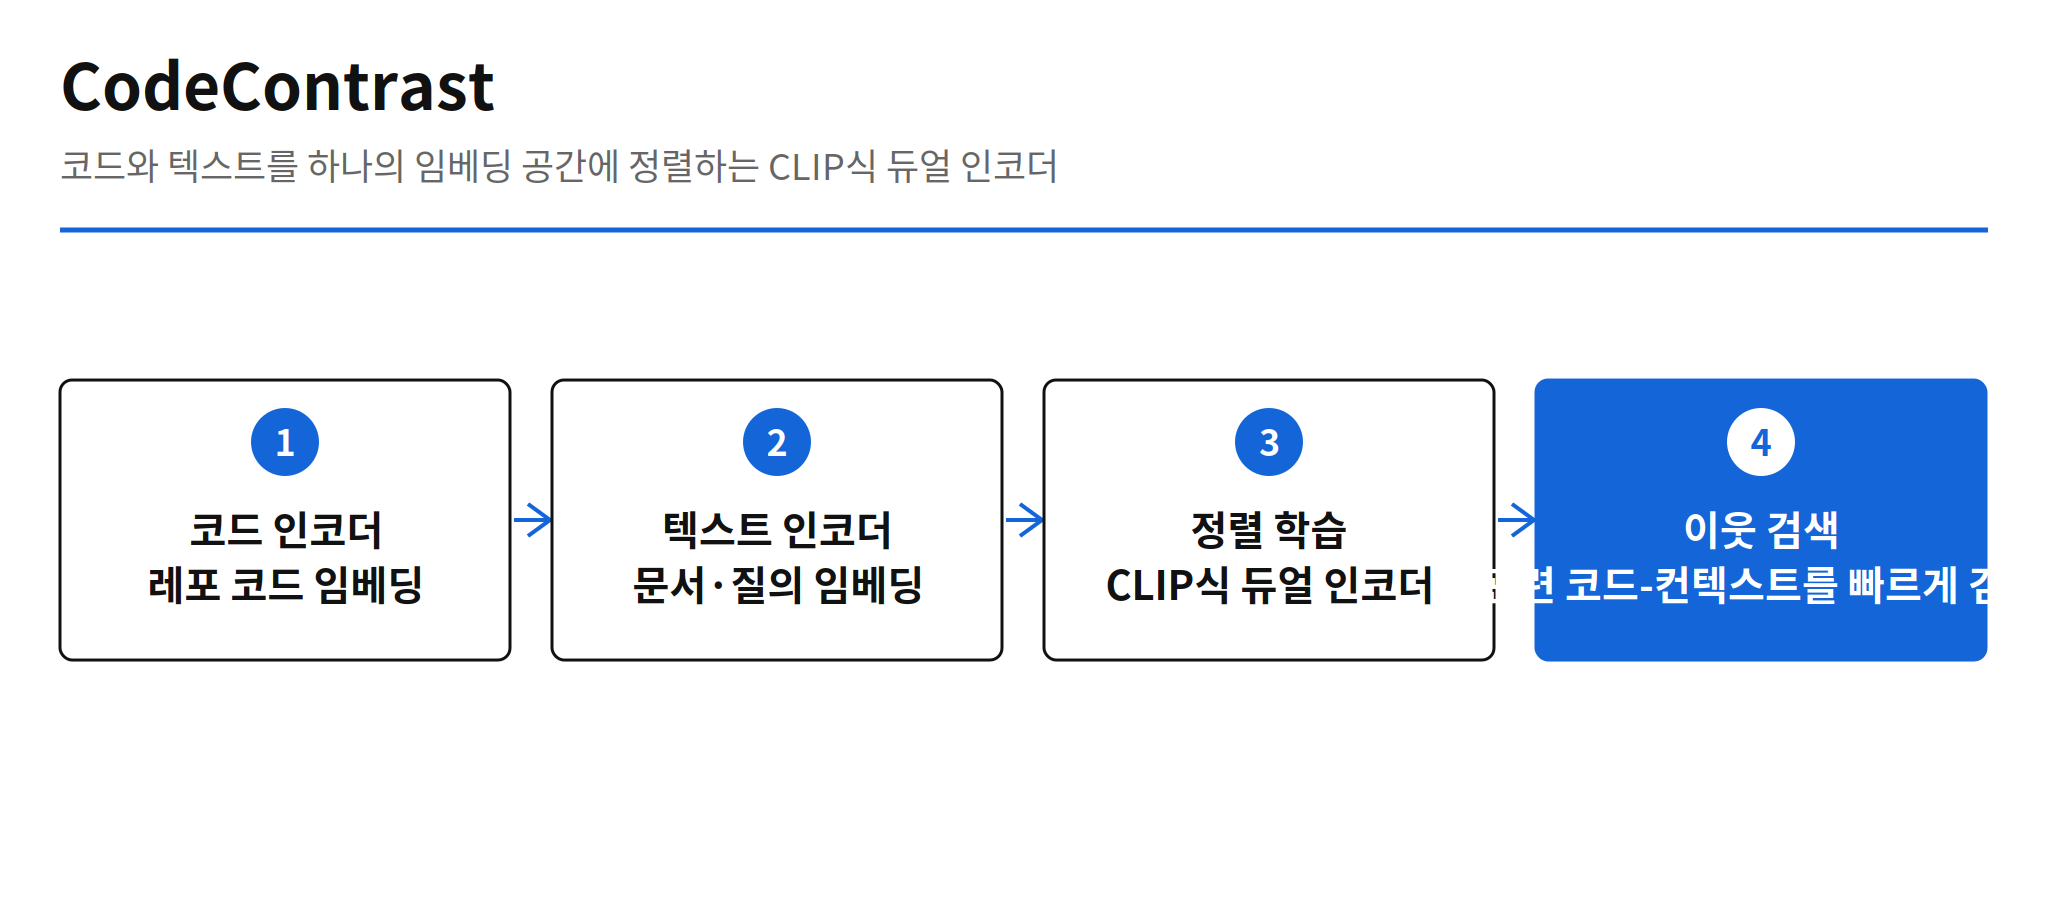
CodeContrast — 코드와 텍스트를 하나의 임베딩 공간에
- CodeContrast는 CodeScribe 출력으로 학습한 CLIP식 듀얼 인코더다. 정렬된 텍스트-코드 임베딩을 학습한다 (arXiv).
- 관련 코드-컨텍스트 이웃을 빠르고 의미 있게 검색한다 (arXiv).
- MCP 기반 LLM 오케스트레이터가 검색 결과를 근거로 도메인 질의에 답한다 (arXiv).
- RAGAS LLM-as-a-judge에서 faithfulness 90% 이상을 기록했다. 답의 근거 충실도가 높다 — 근거 없는 답을 안 한다는 뜻이다 (arXiv).
평가 — OpenCV와 5M-LOC 독점 레포에서 검증
- OpenCV와 독점 5M-LOC 레포지토리에서 평가했다. 공개와 비공개 레포 둘 다에서 검증했다 (arXiv).
- CodeScribe 파생 지도가 text-to-code 정확도를 베이스라인 대비 개선했다. 문서 품질이 검색 품질로 이어진다 (arXiv).
text-to-code 정확도의 절대 수치는 초록에 없다. 개선폭의 기준선은 미확인이다. 아래 쟁점과 함께 읽을 것.
아직 안 밝혀진 것
- text-to-code 정확도의 절대 수치가 초록에 없다. 개선폭의 기준을 알 수 없다 — 미확인.
- 독점 레포의 언어·도메인이 초록에 없다. 어떤 코드인지 확인할 수 없다 — 미확인.
- MCP 오케스트레이터의 지연·비용이 초록에 없다. 운영 조건을 추정할 수 없다 — 미확인.
- CodeScribe에 쓴 코드 인식 LLM의 정체가 초록에 없다. 재현 기준이 없다 — 미확인.
왜 중요한지 — Series 같은 대형 코드베이스의 온보딩 병목
Series 같은 대형 Android 코드베이스에 새 팀원이 붙을 때 "이 함수가 어디서 불리는지"를 계층 문서와 의미 검색으로 답하는 구조다. 문서와 검색이 팀의 공유 지식이 된다. MCP 오케스트레이터라는 점이 AX TF의 에이전트 툴링과 바로 맞물린다. 기존 툴링에 얹기 쉽다. 온보딩 시간을 줄이는 게 곧 팀 속도다 (이슈 배경).