Claude Code 코드 90%를 Claude가 작성: 병합 PR 2배, revert 40% 감소
핵심 사실
- Anthropic 공식 개발자 계정 @ClaudeDevs가 2026-10-16 게시물에서 "Claude writes about 90% of Claude Code's code"라고 공개했다 (@ClaudeDevs).
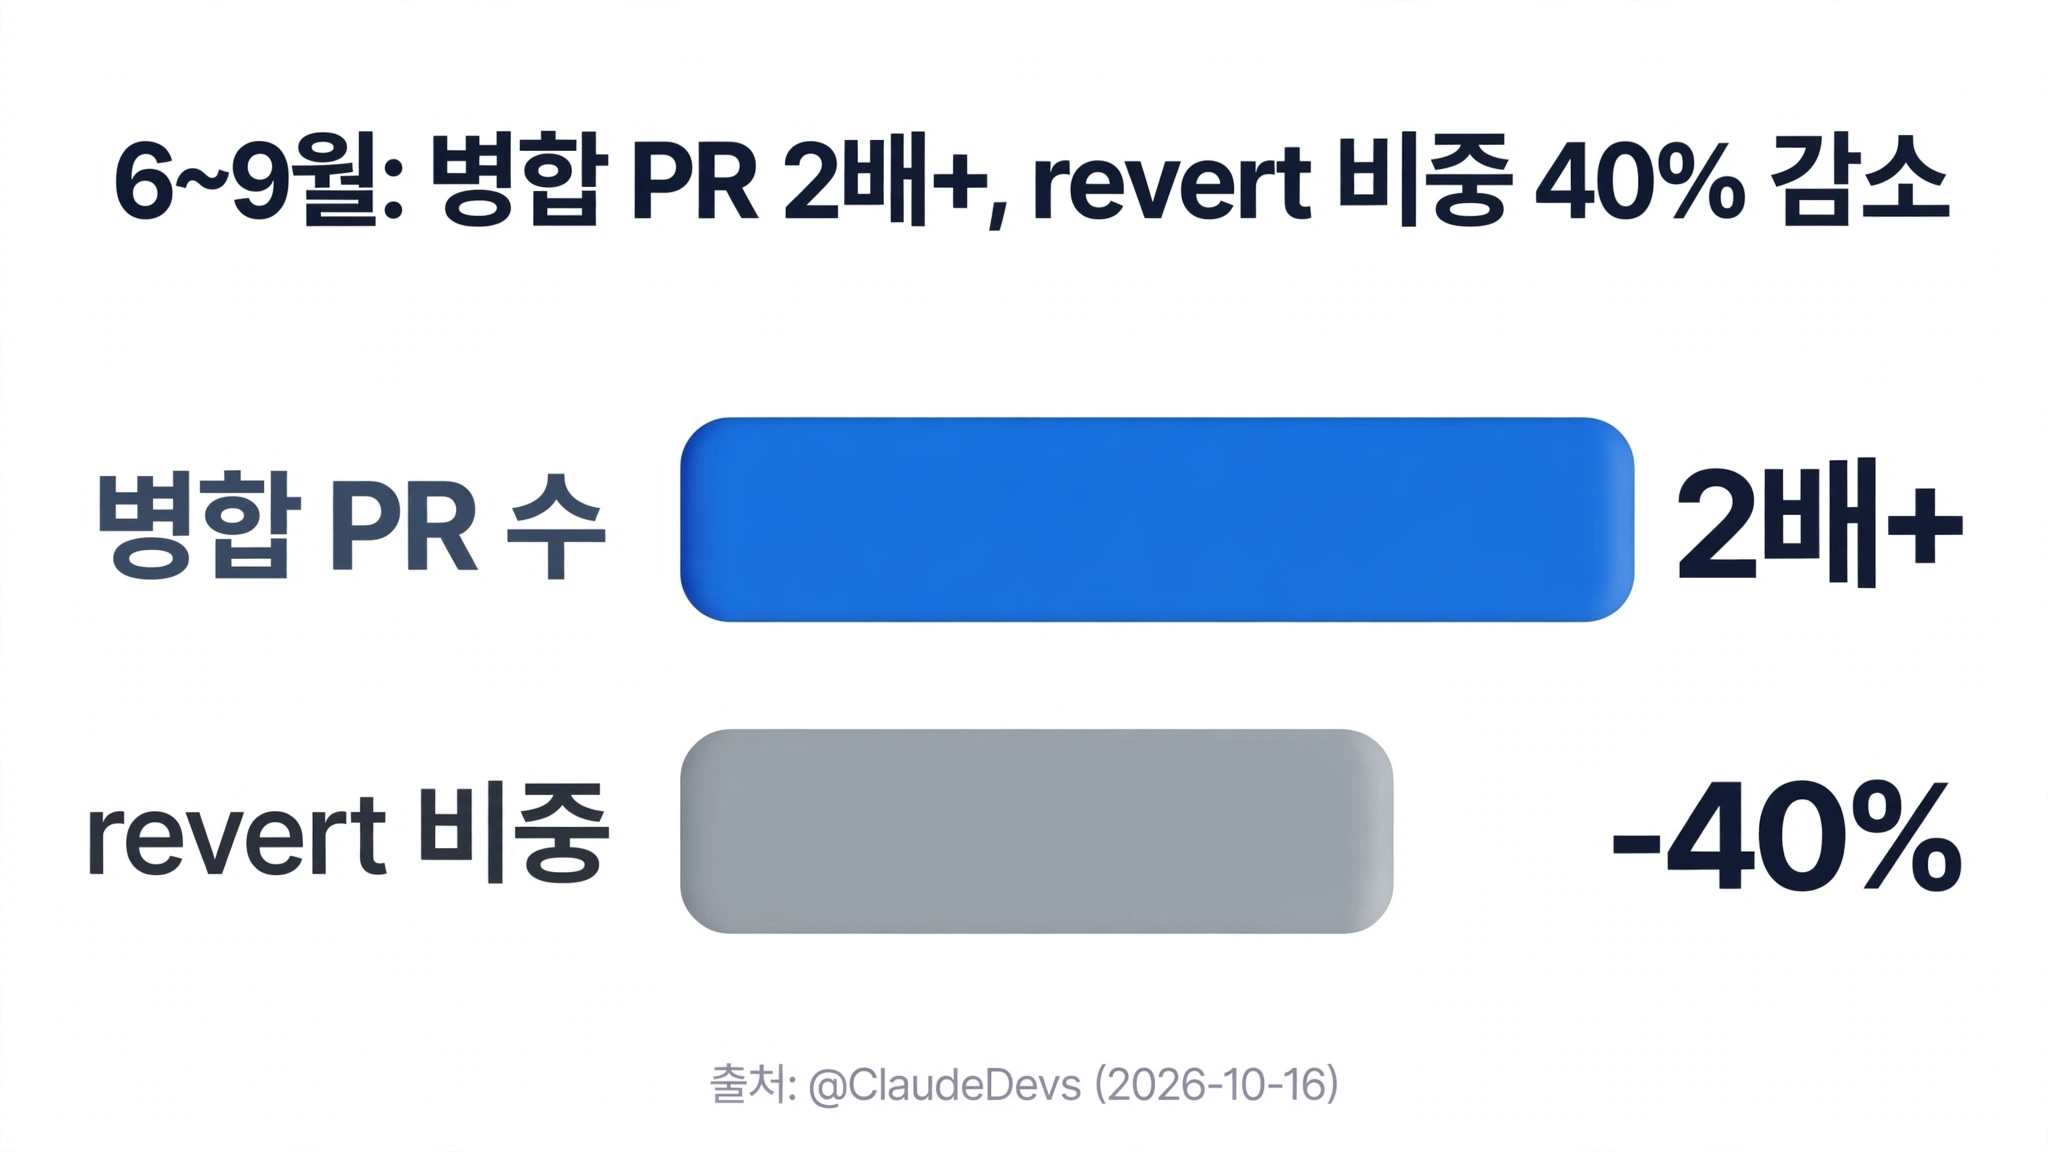
- 같은 게시물에 따르면 6월~9월 사이 병합된 PR은 2배 이상 증가했고, revert된 비중은 40% 이상 감소했다 (@ClaudeDevs).
- 속도만 빨라진 게 아니라 품질도 좋아졌다는 주장이다 — "merged PRs more than doubled while the share reverted fell by more than 40%." (@ClaudeDevs)
- 이 수치를 달성하기 위해 Anthropic이 코드 리뷰 방식을 어떻게 바꿨는지 설명한 글을 함께 공개했다. 해당 글에는 이 방식을 외부 팀이 도입하는 방법도 포함되어 있다 (@ClaudeDevs).
- 전날(10/16) 같은 계정은 Claude Code 성능 개선도 발표했다 — 매 턴 전송하는 대화를 gzip 압축해 모델 도달 속도를 높이고, 클라우드 세션은 사용자가 타이핑을 시작하자마자 준비된다는 내용 (이슈 #3329에서 이미 다룸).
"90%"의 정확한 의미
먼저 짚어야 할 건 측정 기준이다. "90% of code"의 분모가 공개되지 않았다 — 생성된 코드 라인 기준인지, PR 기준인지, 머지된 커밋 기준인지 알 수 없다. 자사 지표라 외부 검증도 불가능하다. "revert 비중 40%↓" 역시 내부 정의에 의존한다.
그럼에도 이 게시물이 주목받는 이유는 분모가 아니라 분자의 방향 때문이다. AI 코딩 도구를 팀에 도입하려는 입장에서 가장 자주 묻는 질문은 "얼마나 쓸만한 코드를 얼마나 안정적으로 뽑는가"다. Anthropic이 자사 제품에 대한 실제 운영 수치(PR 배수, revert율)를 공개한 사례는 드물고, 이 두 지표는 에이전트 코딩의 성숙도를 가늠하는 바로미터로 읽힌다.
개발자 관점: "우리 팀은 AI로 코드를 얼마나 만들고 있는가"를 물을 때 쓸 수 있는 첫 번째 기준선이 생긴 셈이다. 중요한 건 90%라는 절대값이 아니라, 병합 PR 수와 revert 비중을 한 쌍으로 추적한다는 측정 방식 자체다. 속도 지표만 보면 품질 하락을 놓치고, 품질 지표만 보면 속도 개선을 놓친다.
바뀐 코드 리뷰 방식
게시물의 또 다른 축은 프로세스다. Anthropic은 이 수치를 달성하기 위해 코드 리뷰 방식을 어떻게 바꿨는지 설명한 글을 함께 공개했고, 거기엔 외부 팀이 이 방식을 도입하는 방법도 담겨 있다. 세부 규칙(어떤 규칙을 어떻게 바꿨는지)은 링크된 글을 직접 읽어야 확인할 수 있으며, 이슈 요약본에는 빠져 있다.
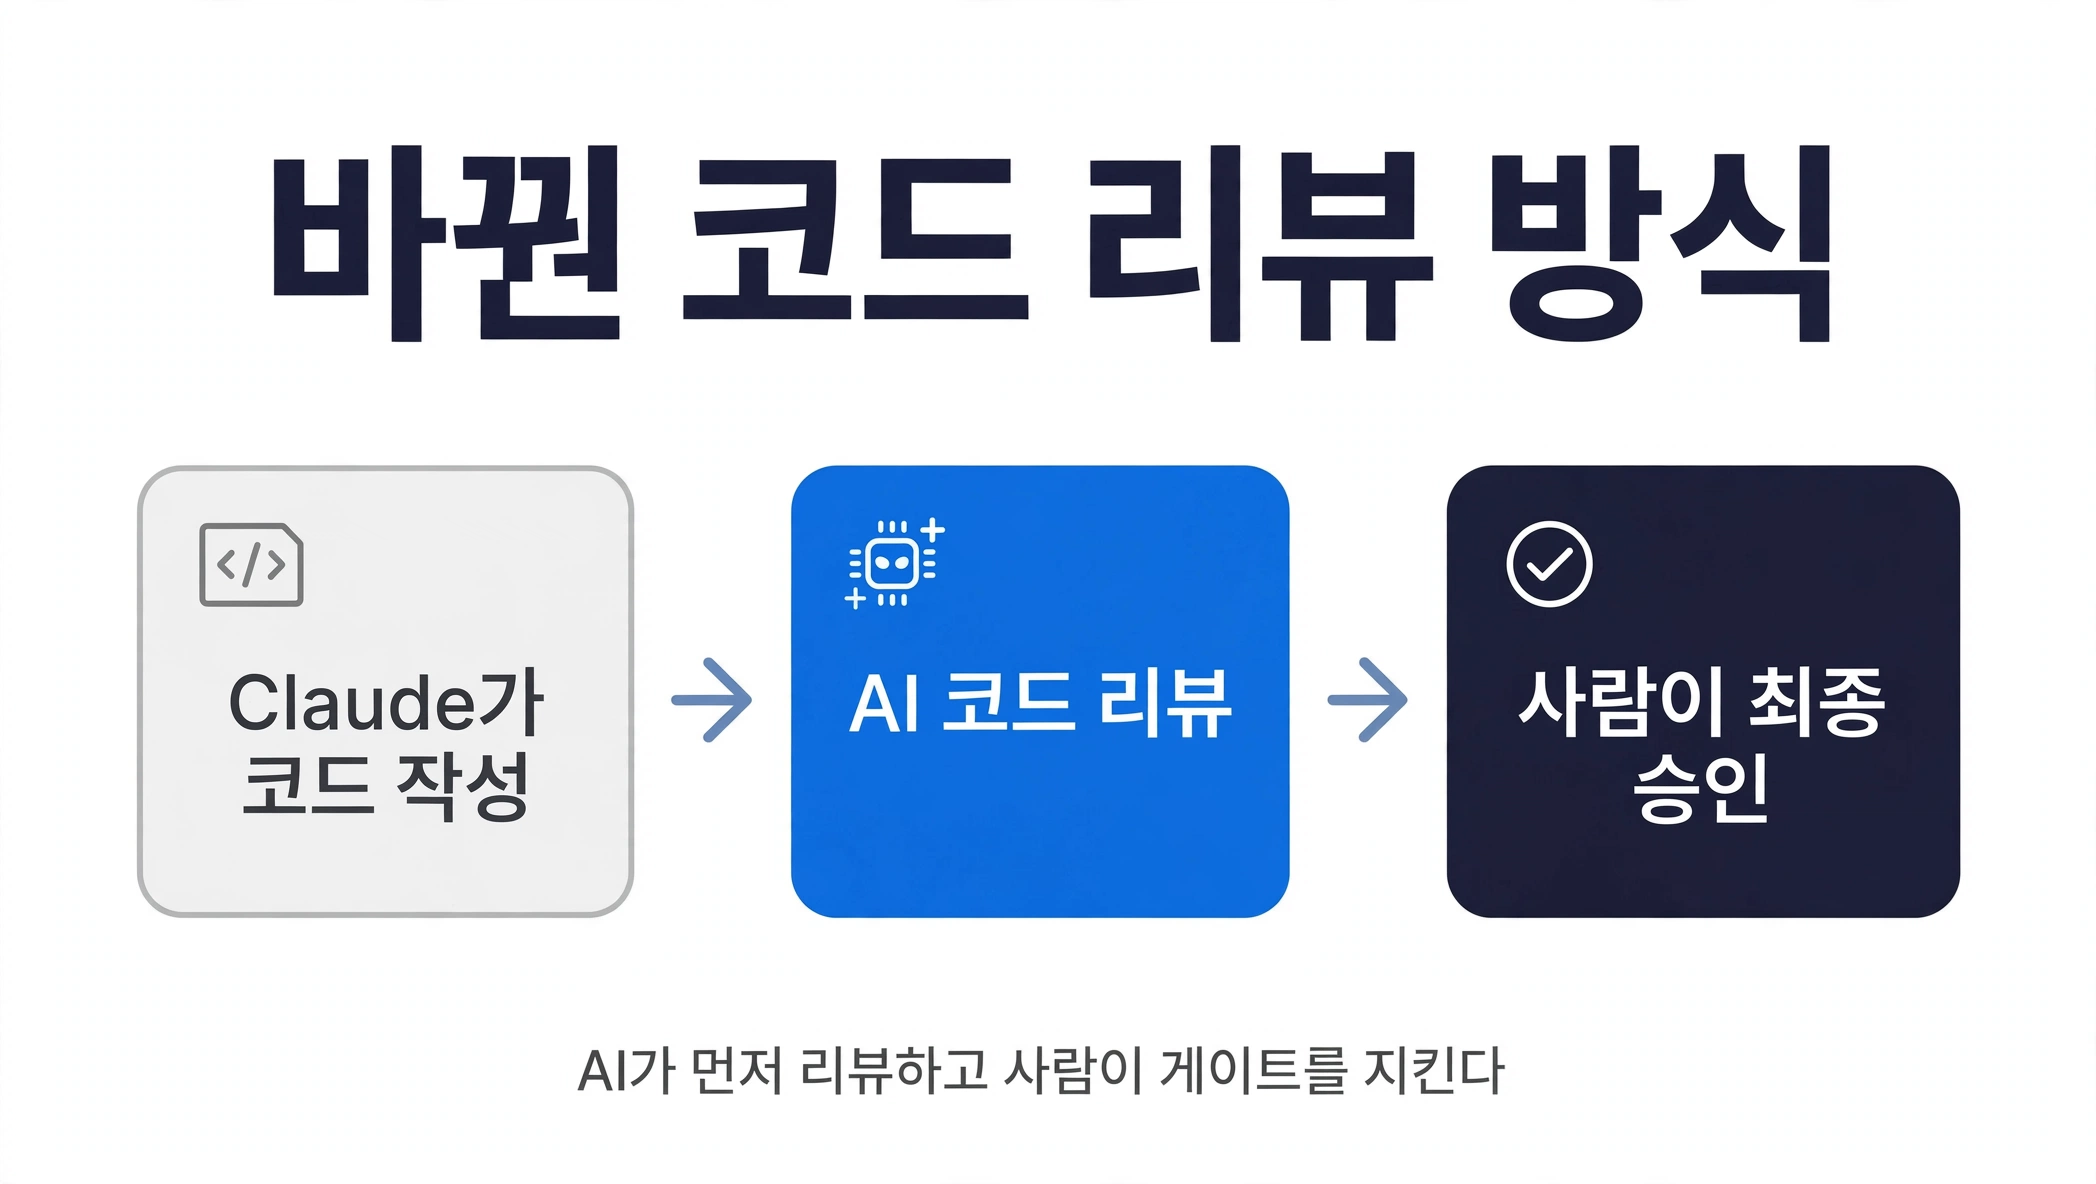
맥락상 이 수치는 Claude Code의 코드 리뷰 기능 GA(같은 날 별도 게시물로 발표, 이슈 #3292)와 연결되어 있다. 자동 PR 리뷰가 워크플로에 들어오면서 리뷰의 1차 스크리닝을 AI가, 최종 판단을 사람이 맡는 구조로 바뀐 것으로 보인다. "AI가 전부 한다"가 아니라 "AI가 먼저 보고 사람이 게이트를 지킨다"는 분업이 핵심이다.
실전: 우리 팀에 적용하기
가이드를 읽기 전에 당장 할 수 있는 건 측정을 시작하는 것이다. Anthropic이 공개한 두 지표는 gh CLI만으로 재현할 수 있다:
# 우리 팀도 같은 지표를 재보자 — 28일 단위 에이전트 코딩 대시보드 스케치
import json, subprocess
from datetime import datetime, timedelta

REPO = "roomedia/ax-trend"  # 측정할 레포로 교체
since = (datetime.now() - timedelta(days=28)).strftime("%Y-%m-%d")

out = subprocess.run(
    ["gh", "pr", "list", "--repo", REPO, "--state", "merged",
     "--search", f"merged:>={since}", "--limit", 300,
     "--json", "number,title,mergedAt"],
    capture_output=True, text=True, check=True)
prs = json.loads(out.stdout)

merged = len(prs)
reverts = sum(1 for p in prs
              if p["title"].lower().startswith("revert"))
print(f"최근 28일 병합 PR: {merged}")
if merged:
    print(f"revert PR: {reverts} ({reverts / merged:.1%})")
# 매주 이 숫자를 찍어두면 '에이전트 코딩 도입 전후'의 변화를
# 정량으로 비교할 수 있다. Anthropic이 공개한 것과 같은 축이다.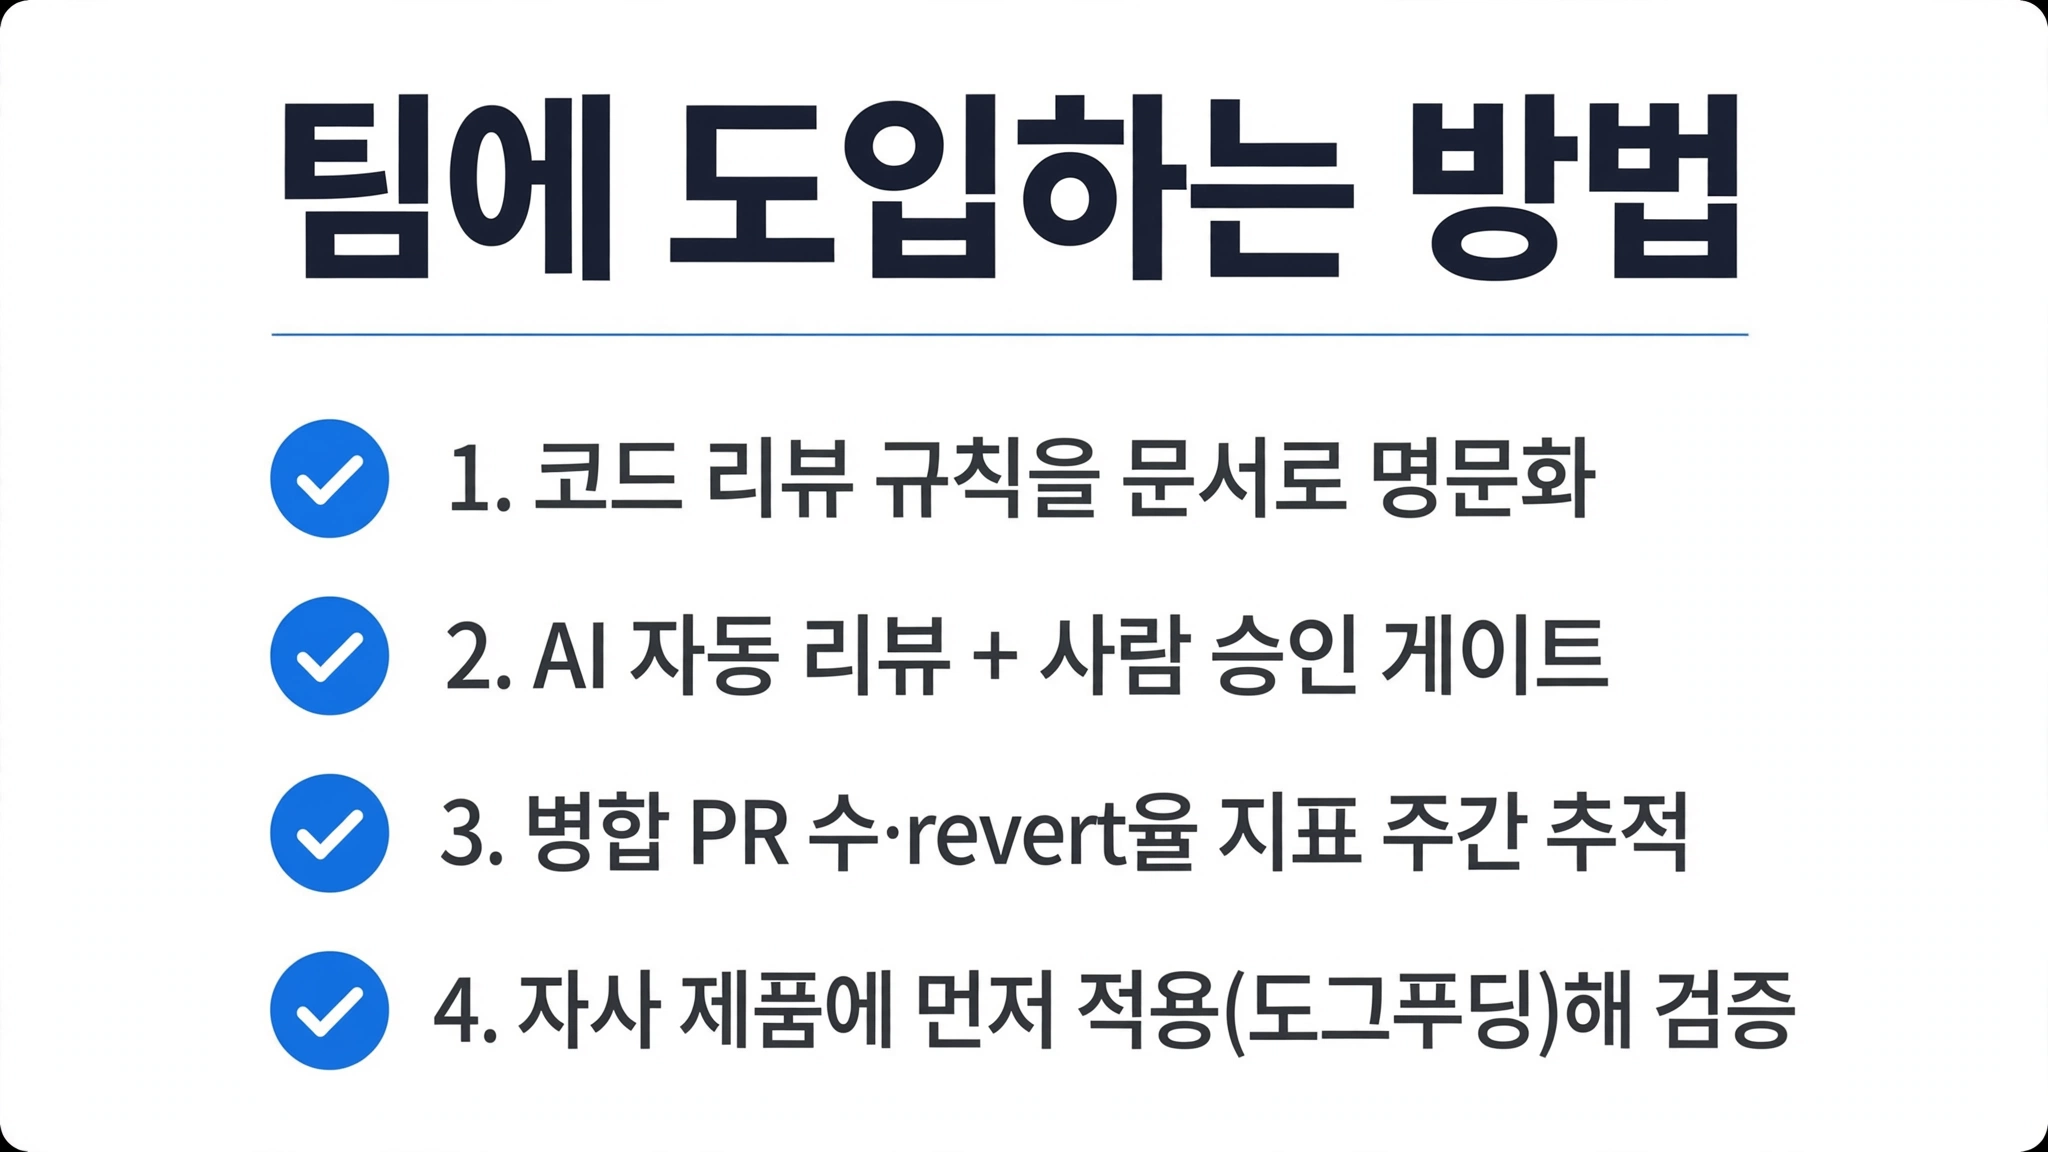
도입 순서로 보면 이렇다. ① 코드 리뷰 규칙을 문서로 명문화한다 — AI 리뷰어는 문서화된 규칙이 있어야 일관되게 동작한다. ② AI 자동 리뷰를 PR 파이프라인에 넣고, 최종 승인은 사람이 맡는다. ③ 병합 PR 수·revert율을 주간 단위로 추적해 도입 전후를 비교한다. ④ 자사 제품·내부 도구에 먼저 적용(도그푸딩)해 검증한다. Anthropic이 자기 제품(Claude Code)부터 이렇게 돌린 이유다.
AX TF 관점: 사내 코딩 에이전트 도입의 ROI·품질 게이트를 설계할 때 이 두 지표를 그대로 가져올 수 있다. "병합 PR이 늘었는데 revert도 같이 늘었다"면 도입이 실패한 것이고, "병합 PR이 늘고 revert가 줄었다"면 Anthropic이 주장한 방향으로 가고 있는 것이다. 측정이 먼저, 도구 도입은 그 다음이다.
배경·맥락
Anthropic은 Claude Code를 자사 개발 파이프라인의 도그푸딩 대상으로 계속 사용해 왔으며, 성능·품질 지표를 공개하는 것은 이번이 처음이 아니다. AI 코딩 도구의 "얼마나 스스로를 만드는가" 수치는 에이전트 코딩 성숙도의 바로미터로 읽힌다.
코드 리뷰 기능 자체는 같은 날 Team·Enterprise용으로 GA가 발표됐다(이슈 #3292). 90% 자동 생성 통계는 그 리뷰 워크플로 변경의 결과물로 제시된 것으로 보인다.
주의 (미확인·쟁점): "90%"의 측정 기준 미공개 — 생성 코드 라인 기준인지 PR 기준인지 알 수 없다. 코드 리뷰 변경 글의 구체 내용도 링크 원문을 읽어야 확인 가능하다. 자사 지표이므로 외부 검증이 불가능하며, "revert 비중 40%↓" 역시 내부 정의에 의존한다.