Claude Mythos 5 양자 회로 설계: Toffoli 게이트 17배 줄인 자율 설계
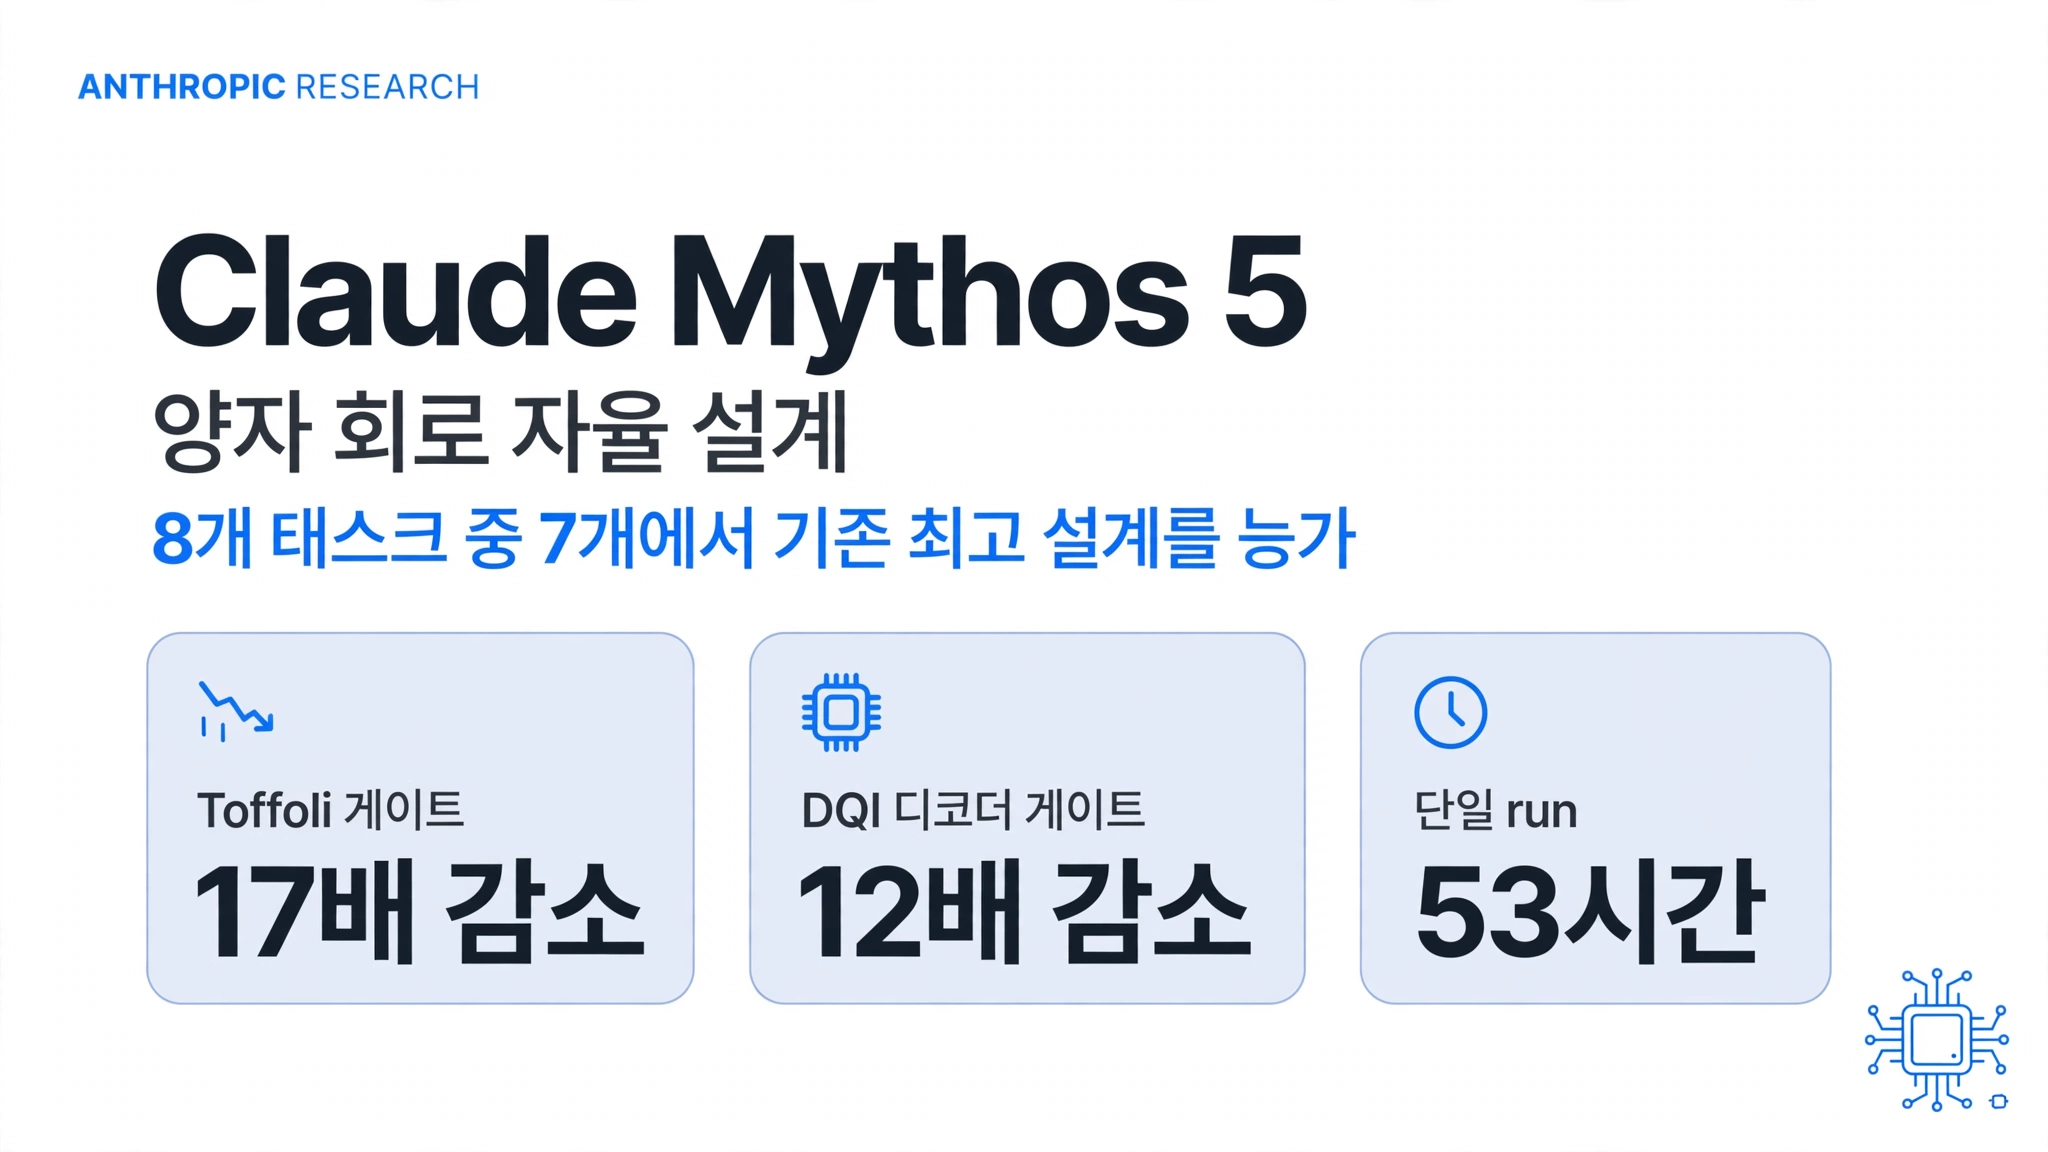
Anthropic이 10월 16일 공식 리서치 포스트 "Designing more efficient quantum circuits with Claude"를 통해, Claude Mythos 5가 양자 회로를 자율적으로 설계해 기존 최고 공개 설계를 능가했다고 발표했다. LLM이 챗 답변을 넘어 "검증 가능한 과학 작업"을 스스로 수행했다는 점에서, 'AI for science'의 이정표 성격이 짙다.
개발자 관점 한 줄 요약: 평문 스펙 + 자동 평가기의 generator-judge 클로즈드 루프가 53시간 동안 라운드 사이 인간 개입 없이 돌아, 8개 양자 회로 설계 태스크 중 7개에서 기존 최고 회로보다 게이트·큐비트를 줄였다. 한 태스크는 자릿수 단위(order-of-magnitude) 개선. 우리가 에이전트 실무에서 쓰는 평가기+반복 개선 패턴이 과학·엔지니어링 영역에서도 통한다는 증거다.
실험 설정: 평문 스펙 → 제안 → 채점 → 개선
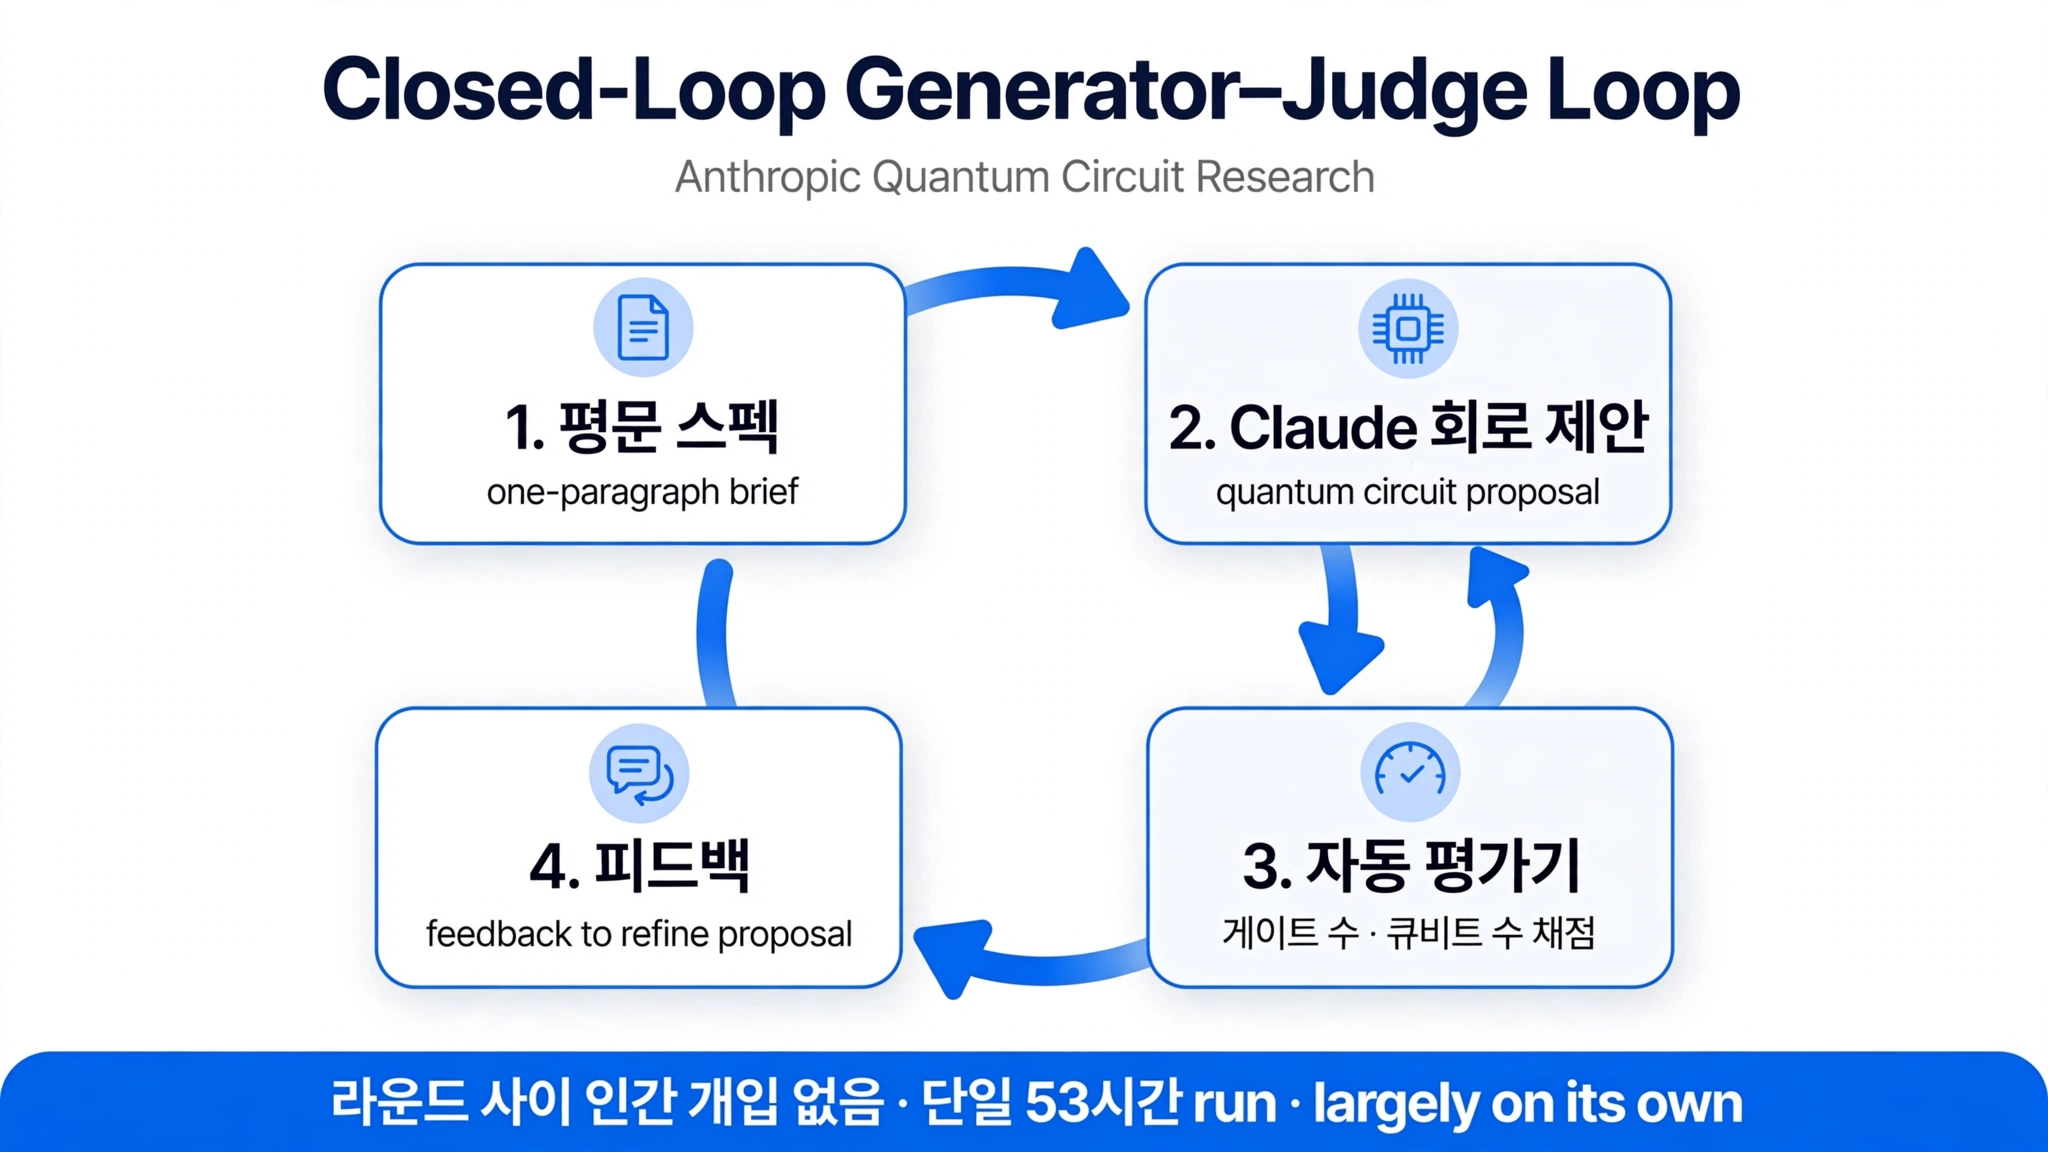
실험 디자인은 에이전트 엔지니어에게 익숙한 패턴이다. 화학·최적화·물리 시뮬레이션·수론에서 가져온 8개 양자 회로 설계 태스크를 plain-language 스펙으로 제시하고, 정답 여부와 게이트·큐비트 비용을 채점하는 자동 평가기(evaluator)를 연결했다. Claude는 회로를 제안하고, 평가기 피드백을 받아 개선하는 루프를 돌린다.
핵심은 라운드 사이 인간 개입이 없었다는 점이다. Anthropic 표현대로 "largely on its own". 대표 성과인 모듈러 역원 회로는 단일 53시간 run, one-paragraph brief에서 출발해 완성됐다. 리드 연구자는 Anthropic STEM Fellows Program의 Andi Gu, 멘토는 Anthropic 양자 물리학자 Alek Kemeny, Harvard의 Susanne Yelin·Mikhail Lukin(QuEra Computing 겸임)이 협업했다.
대표 성과: 모듈러 역원에서 Toffoli 17배 감소
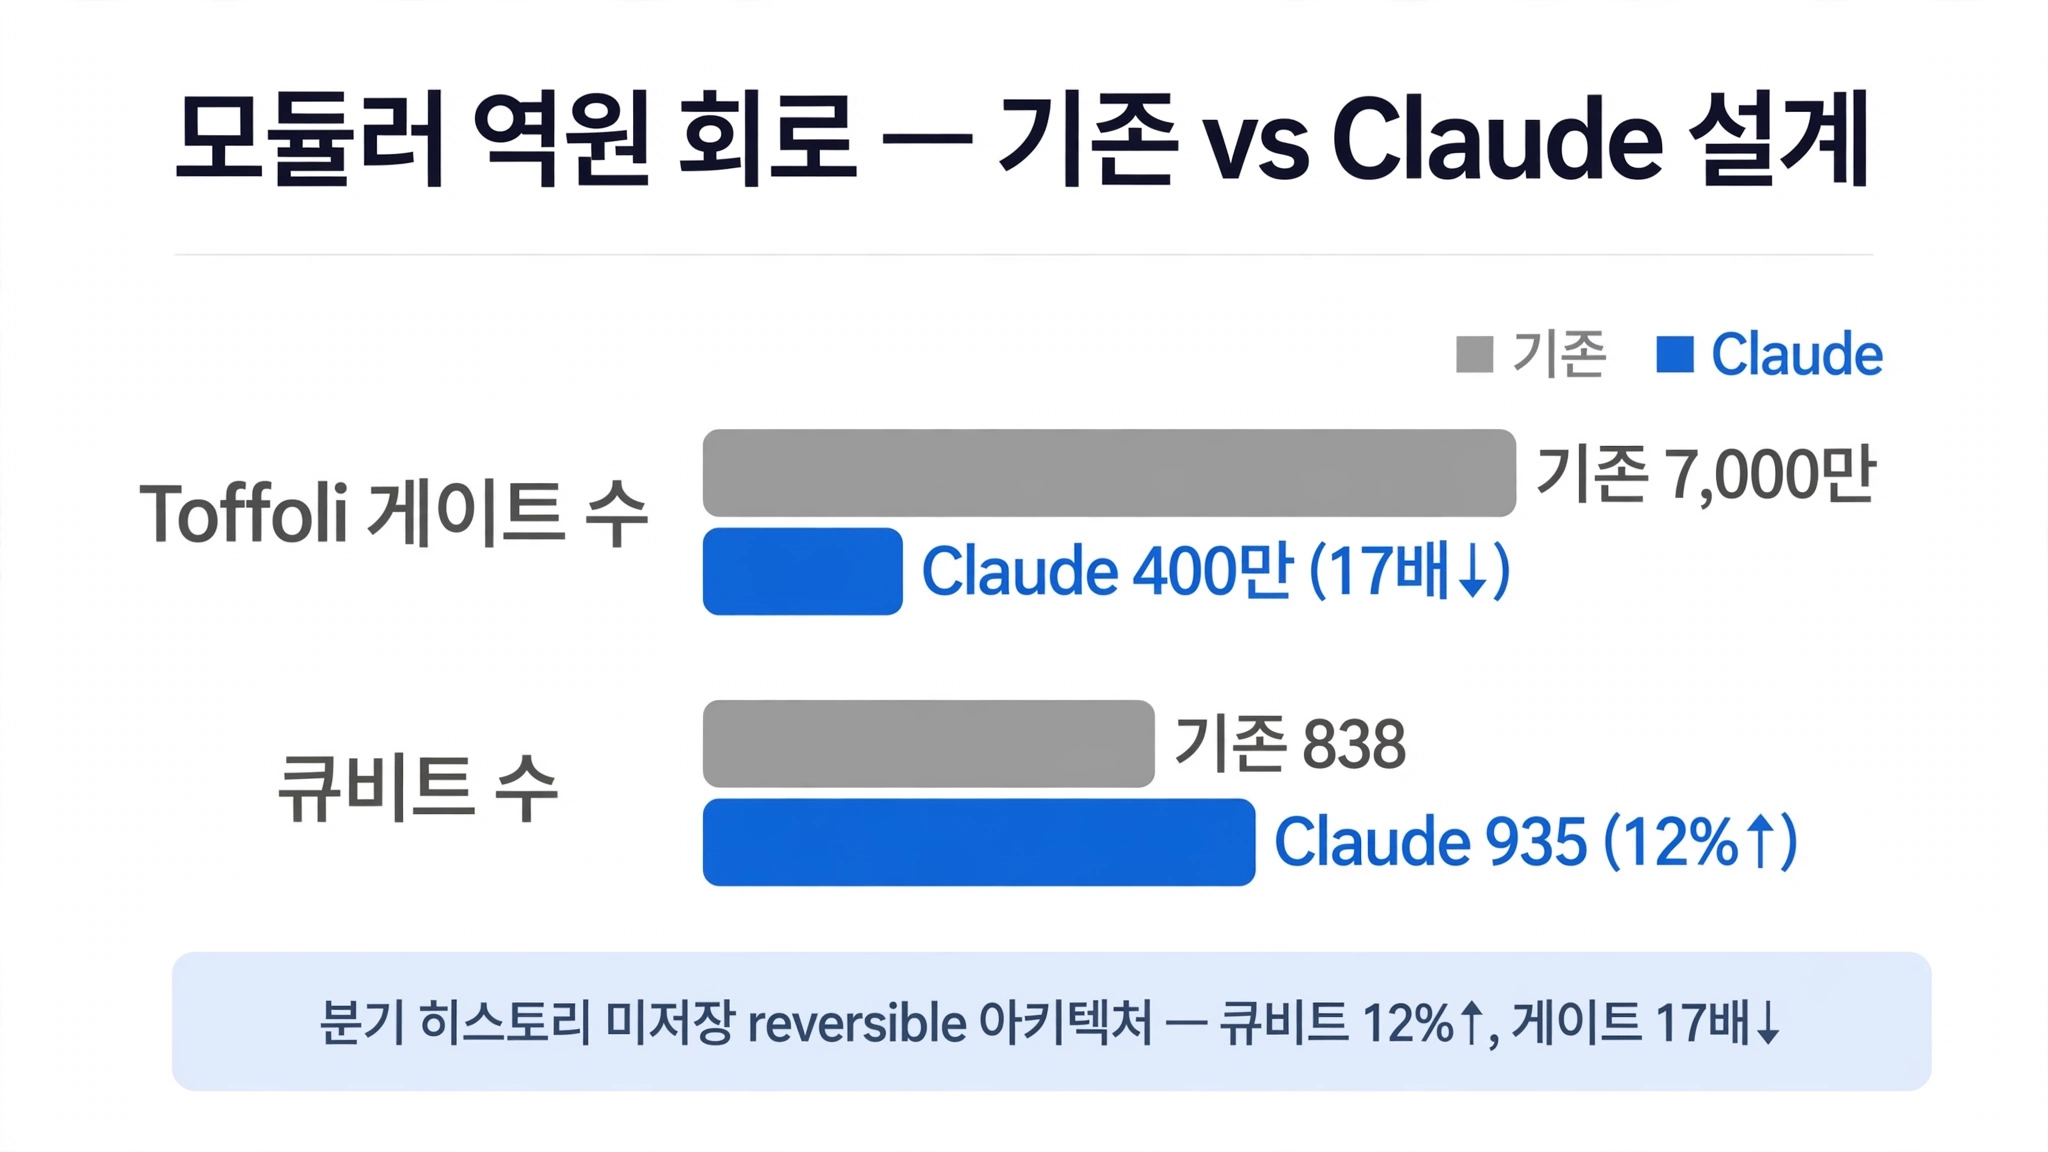
타원곡선 점 덧셈(elliptic-curve point addition)의 모듈러 역원(modular inversion) 연산에서 Claude는 분기 히스토리를 저장하지 않는 새로운 reversible 아키텍처를 발견했다. 수치는 드라마틱하다:
| 자원 | 기존 최소 설계 | Claude 설계 | 변화 |
|---|---|---|---|
| Toffoli 게이트 | 7,000만 | 400만 | 약 17배 감소 |
| 큐비트 | 838 | 935 | 12% 증가 (트레이드오프) |
큐비트를 12% 더 쓴 대신 Toffoli 게이트를 17배 줄인 트레이드오프 — 인간 전문가의 직관을 벗어난 설계 공간을 모델이 스스로 찾아낸 셈이다. DQI(decoded quantum interferometry) 최적화 알고리즘에서는 Google Quantum AI의 기존 구성을 대체하는 Berlekamp-Massey 디코딩을 적용해 디코더 게이트 수를 약 12배 줄였다.
검증: 평가기 + 시뮬레이션 + Lean 형식 증명
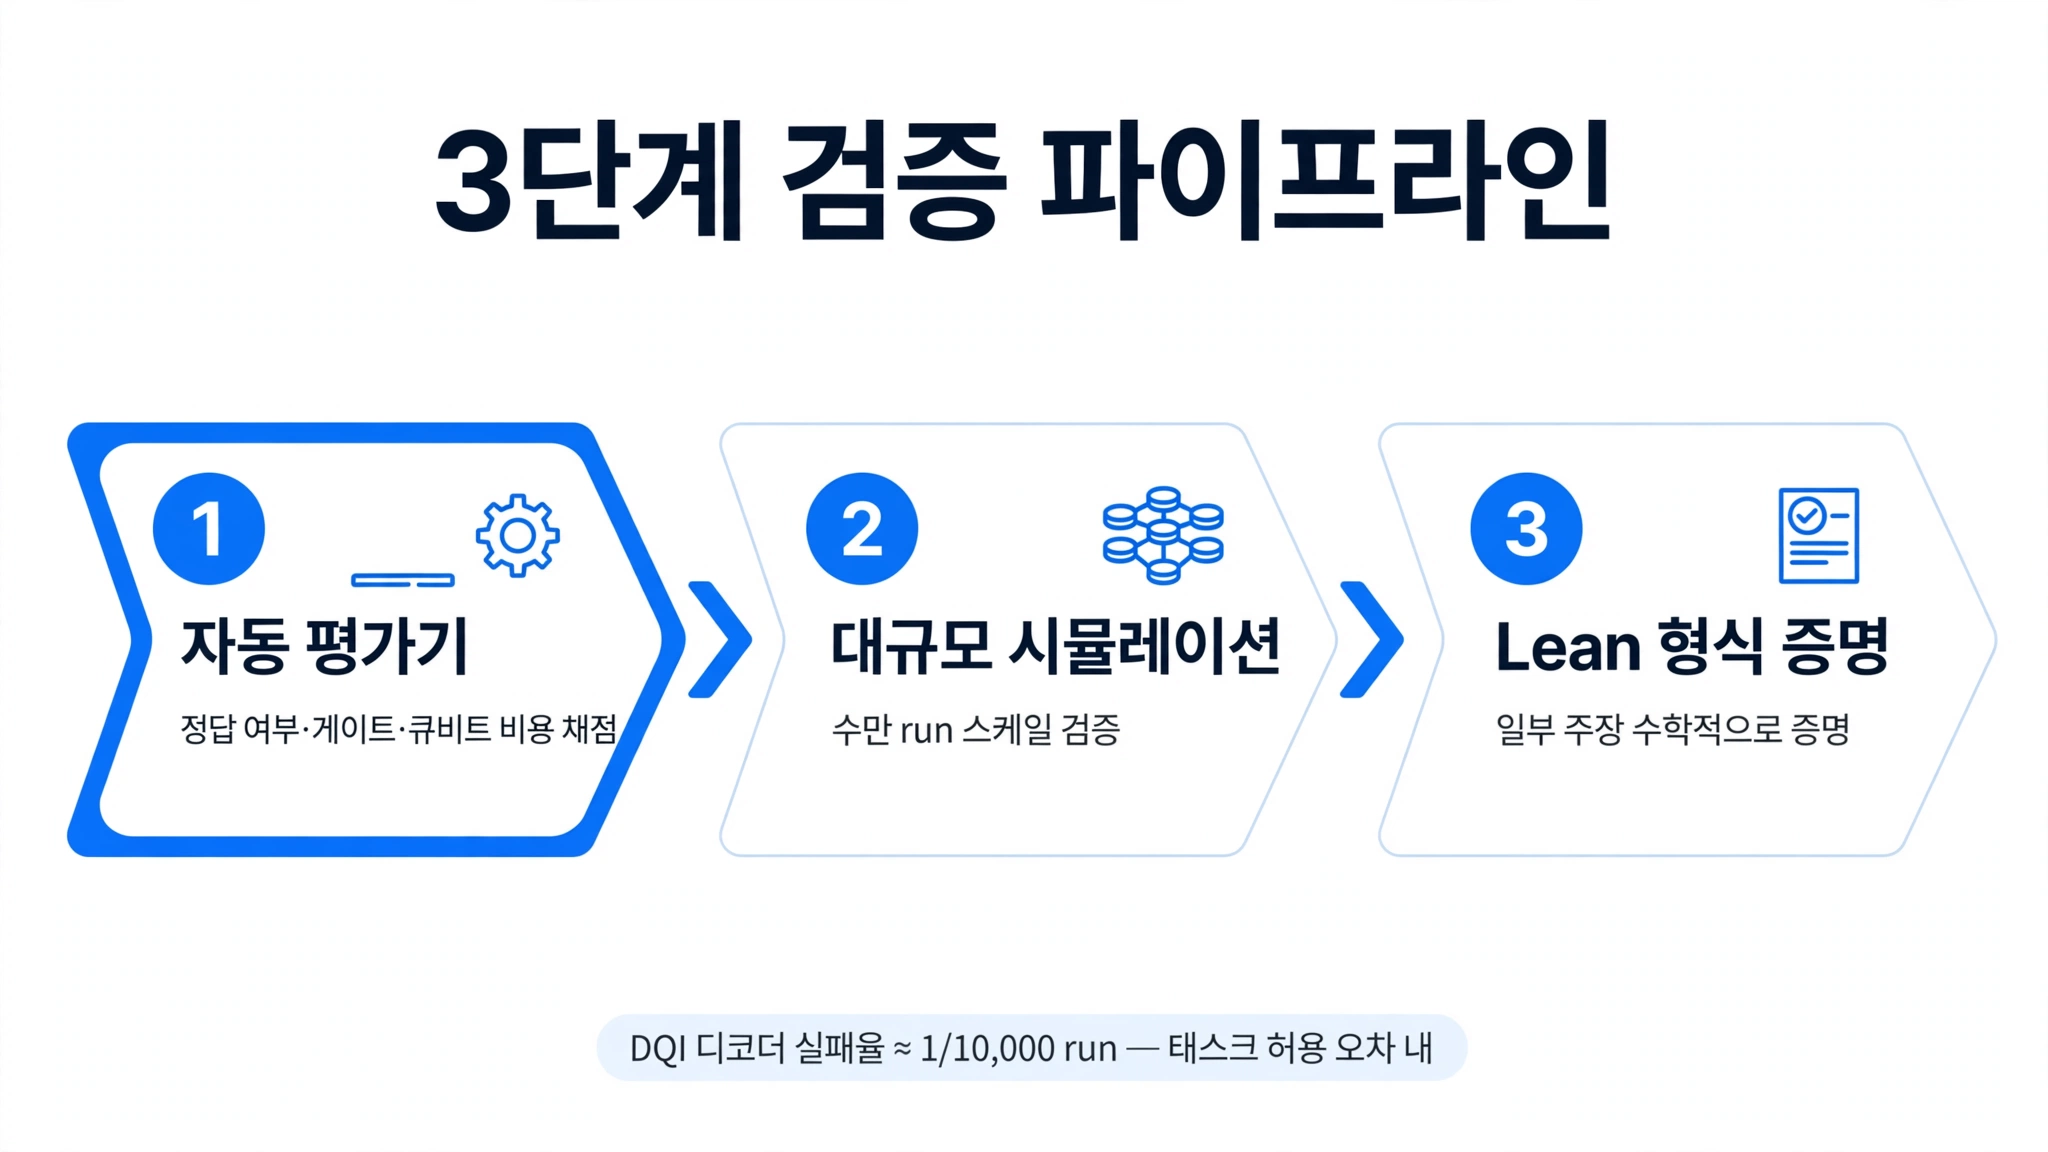
클레임이 크면 검증도 크다. 이번 연구는 3단계 검증 스택을 갖췄다:
- 자동 평가기 — 정답 여부와 게이트·큐비트 비용을 자동 채점
- 대규모 시뮬레이션 — 수치 주장의 스케일 검증
- Lean 형식 증명 — 일부 주장에 대한 기계 검증 가능한 수학적 증명
DQI 디코더의 실패율은 약 1/10,000 run으로 태스크 허용 오차 내라고 밝혔다. 동행 논문 "Discovering state-of-the-art quantum circuits with large language models"은 10월 15일 arXiv에 제출됐다(46페이지, 그림 10개, 표 6개).
아직 미확인: 결과는 태스크 한정·하드웨어 의존적이다. 오류 정정과 더 견고한 큐비트의 필요성을 없애지 않으며, 실제 양자 하드웨어에서 돌린 것이 아니라 "paper 위의 자원 추정치"다. 독립 재현 결과는 아직 없다 — 17배 개선 주장의 재현이 다음 단계의 관건이다. 8번째 태스크(게이트·큐비트를 동시에 줄이지 못한 케이스)의 구체적 한계도 추가 검증이 필요하다. 모든 수치는 연구팀 주장으로 취급할 것.
왜 중요한가: generator-judge 패턴의 일반화
한국 Android 개발자·AX TF 리드 관점에서 당장 쓸 도구는 아니지만, 패턴은 직접적이다. 이번 연구의 설계 패턴을 의사코드로 옮기면:
# generator-judge 클로즈드 루프 (Anthropic 양자 회로 연구의 구조)
spec = read_plain_language_spec()      # 한 문단 브리프
candidate = None
while not evaluator.accept(candidate):
    proposal = claude.propose(spec, history=feedback_log)
    score = evaluator.score(             # 자동 채점: 정답 여부·게이트·큐비트 비용
        proposal, on=["correctness", "toffoli_gates", "qubits"]
    )
    feedback_log.append((proposal, score))
    candidate = proposal
verify(candidate, stages=["simulation", "lean_proof"])
이 구조는 에이전트 품질 보증(QA) 파이프라인과 동일하다 — 생성기(generator)가 후보를 만들고, 채점기(judge)가 객관적 지표로 검증하고, 피드백이 다음 라운드로 돌아간다. 코드 리뷰 에이전트, 테스트 생성 에이전트, 프롬프트 최적화 루프에 응용 가능한 아이디어가 여기 있다:
- 채점기의 엄밀함이 곧 생성기의 한계 — 자동 평가기가 측정할 수 있는 지표만 개선된다. 우리 에이전트의 judge도 "측정 가능한 지표"부터 정의해야 한다.
- 검증 스택의 레이어링 — 빠른 휴리스틱 평가기 → 무거운 시뮬레이션 → 형식 증명. 우리 QA도 린터 → 테스트 → 인간 리뷰의 레이어 구조로 짜는 게 같은 철학이다.
- 장시간 무인 run의 신뢰성 — 53시간 무인 run이 가능했던 건 평가기가 "정답 여부"를 기계적으로 판정할 수 있었기 때문이다. 무인 에이전트 run의 전제는 자동 정합성 검사다.